Hindsight:给AI Agent接上长期记忆的开源方案

Hindsight为AI Agent提供跨会话长期记忆,通过记住、回忆、反思三步解决大模型"失忆"问题。
Hindsight是Vectorize开源的AI长期记忆方案,专门解决大模型跨会话"失忆"的痛点。它不替换底层模型,而是通过三个核心动作运作:Retain从对话或任务中提取事实、关系与时间信息并存入记忆库;Recall在需要时并行使用语义、关键词、关系图和时间四种检索方式取回相关证据;Reflect则在简单查询之外进一步综合推理,给出更深层的回答。与静态知识库不同,Hindsight关注的是"做过什么、发生了什么变化"这类动态积累。它支持API、SDK和MCP接入,可托管或自托管,适合需要长期跟进项目、反复补背景的Agent场景。
AI的"失忆"困境
昨天刚告诉编程助手这个项目用什么语言、哪些文件不能动,今天换个窗口又得从头解释一遍。这种反复补背景的体验,几乎是所有和AI Agent长期打交道的人都遇到过的问题。大模型本身没有跨会话的记忆能力,每次对话都是一张白纸。
Vectorize开源的Hindsight想解决的正是这种"失忆"。它不替你写代码,也不替换你正在用的大模型,而是专注于一件事:把有价值的信息存下来,在需要的时候准确找回来,给Agent接上一个能跨会话使用的记忆库。
三个核心动作:记住、回忆、反思
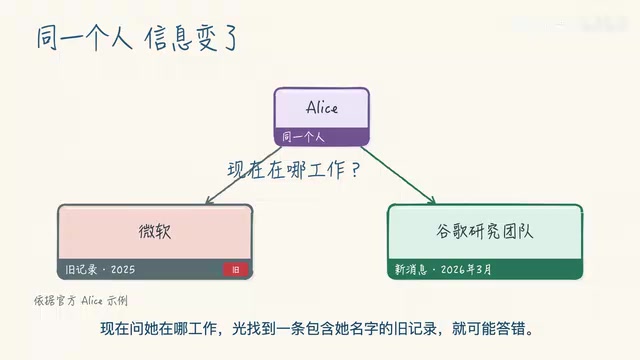
Hindsight的工作方式可以拆成三个动作。官方用了一个Alice的例子来说明其中的关键难点:早先的记录说Alice在微软工作,后来又有一条消息说他三月加入了谷歌研究团队。如果系统只找到一条包含他名字的旧记录,就可能答错——时间和关系必须一起考虑。
Retain:记住
第一步是Retain。输入可以是一段对话,也可以是一段任务经历。系统用大模型从中提取事实、人物关系和时间,再组织成可检索的记忆。"谁做了什么、什么时候发生"不再只是一整段模糊的文字。
值得关注的是,原文会被保留,提取出的事实进入记忆区,相关事实还会被归纳成"观察"。比如一个人的工作信息多次更新,系统就需要结合证据持续修订认识,而不是永远抱着第一条记录不放。
Recall:回忆
第二步是Recall。它会并行使用多种检索线索:语义检索找意思相近的内容,关键词检索找明确的词,关系图处理人物和事件之间的联系,时间检索处理日期范围。结果再合并、排序,按预算返回相关记忆。
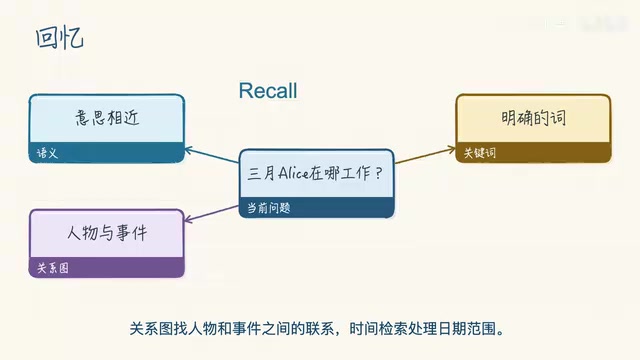
换句话说,回忆不是把全部聊天记录塞回提示词,而是挑出相关证据。新工作的事实和归纳后的观察都能成为候选,检索要做的是筛选。回答对不对,最终还得看信息是否完整,以及模型如何使用这些证据。
语义检索(Semantic Search)依赖向量嵌入(Embedding)技术:文本被转换为高维数值向量,意思相近的内容在向量空间中距离更近,因此即使措辞不同,也能被检索到。关键词检索则是传统的精确匹配,适合处理专有名词、代码变量名等语义嵌入难以捕捉的内容。关系图(Knowledge Graph)将人物、组织、事件表示为节点,将它们之间的关联表示为边,擅长回答"A和B有什么关系"这类问题。将这几种机制并行运行再合并排序,是当前检索增强生成(RAG)领域常见的"混合检索"策略,目的是弥补单一检索方式的盲区——纯语义检索容易漏掉精确词,纯关键词检索又难以理解语义变体。
Reflect:反思
第三步是Reflect。问"Alice现在在哪工作",主要是查事实;但问"他适不适合参加机器学习项目",就得把工作经历、团队和过去的建议综合起来。Reflect会利用记忆做进一步推理再给出回答。
需要提醒的是,推理本身可能出错,不能把它当成保证。
和普通知识库有什么不同
很多人会问,这和知识库有什么区别。
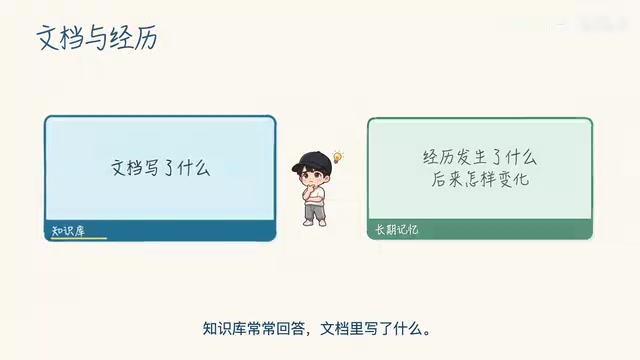
知识库常常回答"文档里写了什么",是静态的内容检索。长期记忆则更关心"我们之前做过什么、后来发生了什么变化、积累了什么认识"。两者可以配合使用,并不冲突。
一个关键设计是,Hindsight不会靠保存聊天记录直接改写大模型的参数。所有记忆都放在Bank(记忆库)里,你可以按用户、项目或Agent来划分。多个设备接同一个库就能检索同一份记忆,接不同的库则分开组织。共享之前需要先想清楚谁该看到哪些内容,别把无关客户的数据混在一起。
接入方式与实际考量
Hindsight提供API、SDK,也支持MCP。通过MCP可以把保存、检索和反思暴露成Agent工具。
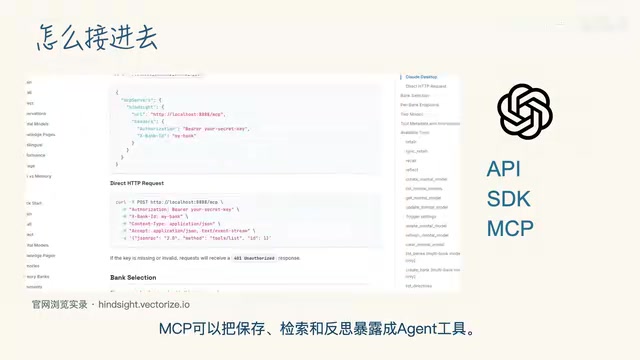
这里有个容易误解的点:工具连接成功只代表"可以调用",是否每轮自动保存、是否每次会话自动回忆,还要看具体集成怎么配置。官方也提供面向编程Agent的集成方案。
部署上可以选托管服务,也可以自己运行。但自托管仍要准备存储和模型服务,并不等于没有调用成本。如果模型走外部API,相关内容仍可能发送给那个服务,这一点在处理敏感数据时尤其要留意。
建议先用一小组非敏感资料验证:记得对不对、找得回来吗、过时信息怎么处理。
MCP(Model Context Protocol)是Anthropic于2024年末推出的开放协议,旨在标准化大模型与外部工具、数据源之间的连接方式。它的作用类似于USB接口的统一规范:工具开发者只需实现一次MCP接口,就能被所有支持该协议的AI客户端调用,而不必为每个平台单独适配。通过MCP将Hindsight的记忆操作暴露为工具,意味着支持MCP的Agent框架(如Claude Desktop、部分开源Agent)可以直接调用保存和检索记忆的动作,无需修改模型本身的代码逻辑。这也是为什么文章强调"工具连接成功"和"实际触发记忆"是两回事——协议层面的连通只是前提,具体的调用时机仍由Agent的业务逻辑决定。
什么场景值得用
如果只是偶尔问一次问题,未必需要这套系统。但如果你的Agent长期跟进一个项目、总在重复补背景,Hindsight就值得一试。
用一句话概括它的分工:记住负责积累,回忆负责取证,反思负责综合。三者配合,才让AI在换个窗口后仍能"记得"你们之前的约定。
相关推荐

合理使用制度为何对AI时代人人有益
从Hacker News讨论出发,解析合理使用(Fair Use)原则在AI训练与内容创作中的法律逻辑、争议焦点及其对创作者与技术生态的双重影响。
Salesforce 3.75亿美元收购Rune,AI物流技术补强国防业务
Salesforce 据报道以 3.75 亿美元收购国防科技初创公司 Rune,这家 AI 物流公司的技术将用于补强 Salesforce 的 Missionforce 国防平台,也延续了 Salesforce 近期的并购节奏。
Mistral Large 4开源万亿参数,微软6万员工自愿离职
Mistral Large 4 开源万亿参数多模态模型,编码智能体评测得分 48;闪迪财报显示 AI 推理重塑 NAND 需求;谷歌 Gemini 上线应用内文件编辑,OpenAI 上调 Codex 额度,微软向 6 万员工提供自愿离职方案。