Hyperresearch:可验证的智能搜索代理,如何杜绝AI幻觉?

Hyperresearch以可验证引用和拒绝编造为核心,提供可信的AI研究代理搜索。
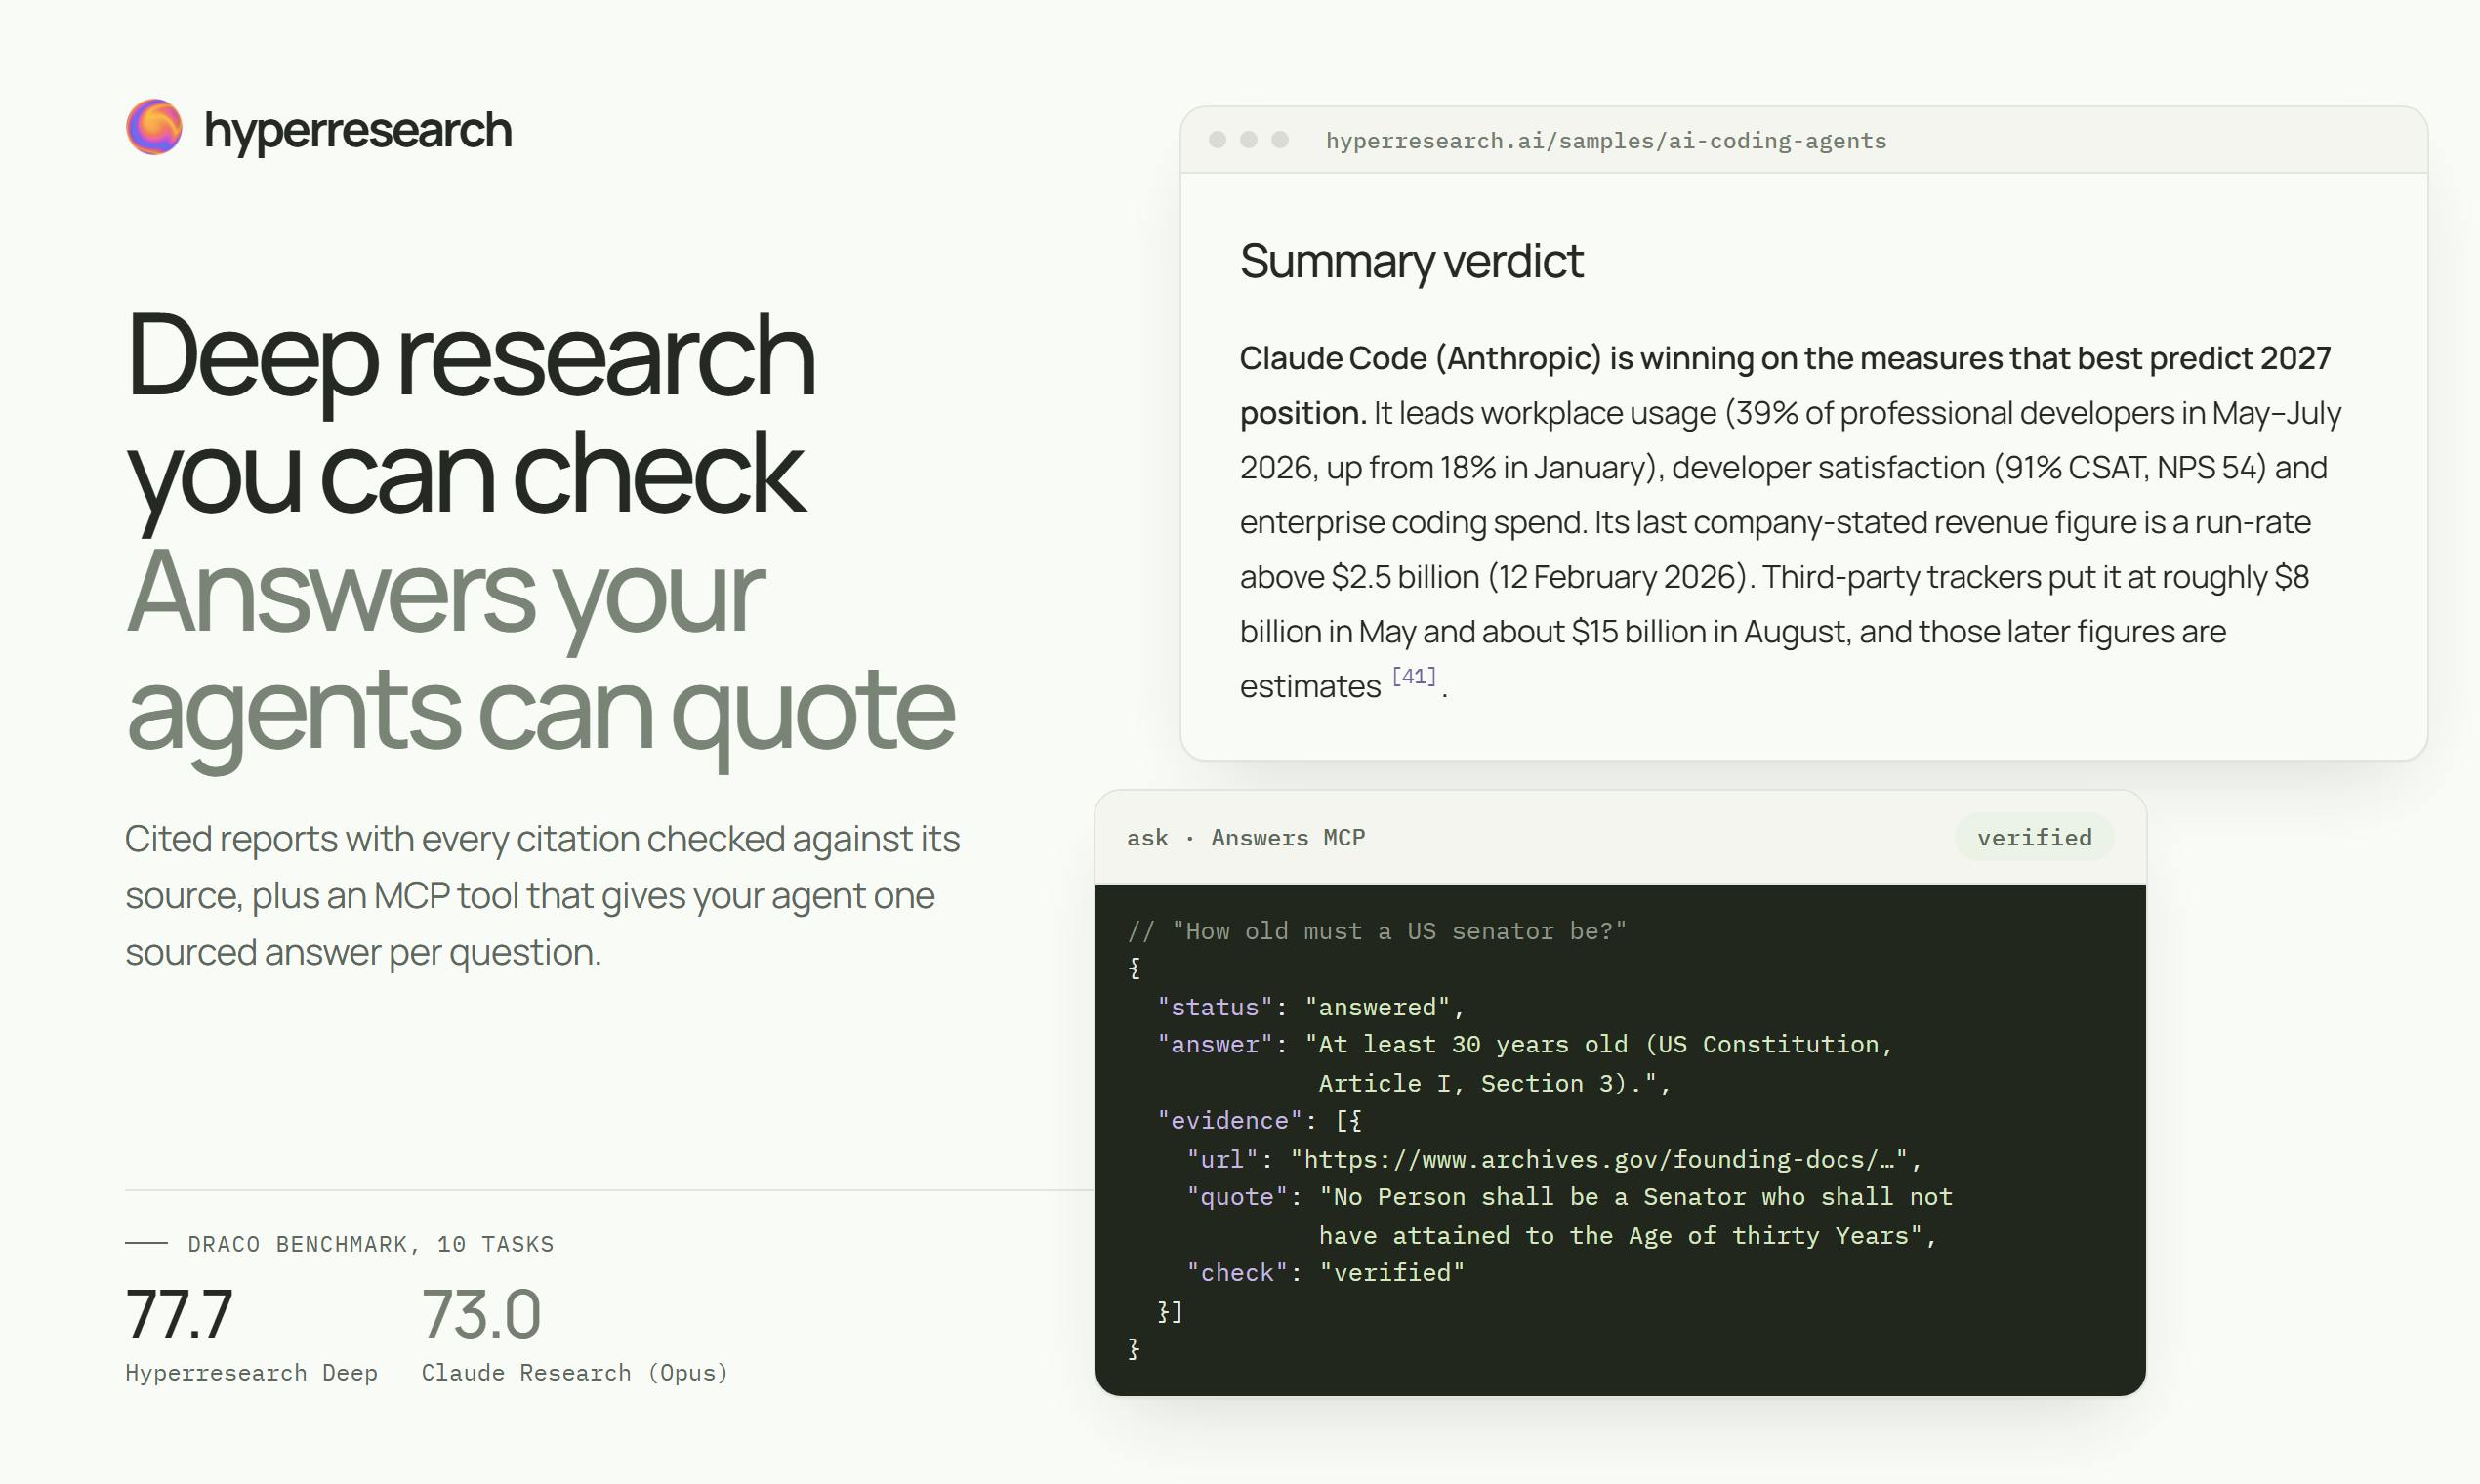
Hyperresearch是一款在Product Hunt上排名第10的AI搜索工具,主打「可验证的智能代理搜索」。其工作流程是:用户提问后生成带引用的报告,每个被引用的论断都与原始来源核对,所有来源存入可搜索库。在DRACO基准测试中排名第一,体现复杂研究场景下的能力。它支持MCP和API集成,开发者调用ask接口可获得带逐字引用的答案或明确的「未找到」,杜绝幻觉。数据覆盖方面聚合了4个AI搜索引擎和40多个数据源,提供广泛深入的信息访问。产品面向开发者和研究者,强调可信度而非界面炫酷,为研究型代理提供了可验证的范式。
在AI搜索工具层出不穷的今天,一个核心痛点始终未解:如何确保AI给出的答案是真实可靠的,而非编造?Product Hunt上排名第10的Hyperresearch试图用「可验证的智能代理搜索」回答这个问题。
核心理念:每个引用都经得起检验
Hyperresearch的标语是「Durable, verified agentic search」(持久、可验证的智能代理搜索)。它的工作流程很直接:用户提问后,得到一个带有引用的报告,而报告中每一个被引用的论断都会与原始来源进行核对。所有来源都保存在一个可搜索的库中,方便追溯。
这种设计直击当前AI搜索的软肋——模型可能生成看似合理但实则虚构的内容。Hyperresearch通过强制核对引用,将「证据」置于「答案」之前。
性能表现:DRACO基准测试第一
据官方介绍,在DRACO基准测试中,Hyperresearch是「世界排名第一的研究代理」。虽然素材未提供具体分数,但这一声明本身表明了团队对产品能力的自信。DRACO是一个评估深度研究代理的基准,涵盖多步骤推理与信息整合任务,能在此登顶意味着Hyperresearch在复杂研究场景下具有竞争力。
DRACO(Deep Research Agent Competition & Benchmark)是一个专门用于评估深度研究型AI代理的基准测试集,由学术界与工业界联合推动。它模拟真实的研究流程,要求代理在多个异构信息源之间进行多步骤检索、交叉验证和综合推理,最终生成结构化报告。评测维度通常包括事实准确性、引用完整性、信息覆盖度和推理链条的合理性。与传统的单轮问答基准不同,DRACO更注重代理在长程任务中的规划能力与自我纠错能力。因此,在该基准上排名靠前,通常意味着代理在复杂、开放性的研究场景中具备较强的鲁棒性和可靠性。
开发者友好:MCP与API集成
Hyperresearch近期新增了对MCP(Model Context Protocol)和API的支持。这意味着开发者可以将Hyperresearch的搜索能力嵌入自己的AI代理工作流中。
具体来说,当你的代理调用ask接口时,会得到两种结果之一:一段包含逐字引用的简短答案,或者一个简单的「未找到」(not found)。官方强调,这是为了「杜绝幻觉」——宁可承认不知道,也不编造信息。
这种设计在需要高可靠性的场景中尤为重要,比如法律、医疗或金融领域的辅助研究。
MCP(Model Context Protocol)是由Anthropic提出的一种开放协议,旨在标准化AI模型与外部工具、数据源之间的交互方式。它允许开发者以统一的方式为AI代理提供上下文信息,例如数据库查询、文件检索或API调用,从而避免为每个工具单独编写适配层。MCP采用客户端-服务器架构,模型作为客户端发起请求,工具作为服务器响应,支持动态发现和权限控制。对于Hyperresearch而言,支持MCP意味着其搜索能力可以无缝接入基于MCP构建的代理生态,开发者无需额外封装即可在Claude Desktop、Cursor等支持MCP的环境中调用其研究接口,显著降低了集成成本。
数据覆盖:聚合4大AI搜索引擎与40+数据源
为了提供「最广泛和深入」的访问,Hyperresearch整合了4个AI搜索引擎和40多个其他数据源。这种聚合策略让它在信息广度上具备优势,尤其适合需要跨库检索的研究任务。不过,素材未披露具体是哪些搜索引擎和数据源,实际效果还需用户验证。
市场反响与定位
Hyperresearch在Product Hunt上获得了82票支持,排名当日第10,分类标签包括API、开发者工具、人工智能和GitHub。从评论数(3条)来看,讨论热度不算高,但作为一款面向开发者的工具,其价值更多体现在实际集成后的效率提升上。
结语:可信AI搜索的一小步
Hyperresearch没有试图用更炫酷的界面吸引眼球,而是聚焦于AI搜索的信任问题。通过引用核对、拒绝编造、聚合多源数据,它为「研究型代理」提供了一个可验证的范式。对于需要可靠信息支撑的开发者与研究者,这或许是一个值得关注的选项。
相关推荐

Cloudflare开源AI代码安全审计工具,获6万星
Cloudflare开源Security Audit,为AI编码Agent提供免费安全审计。三步工作流:应用测绘、多Agent对抗找Bug、三级分类报告,源自内部漏洞狩猎系统,近6万星标。

GPT-6 Astra读权重绝技:仅限小网络,实用靠写代码
GPT-6 Astra能直接读网络权重,但无工具设置仅限约17万权重的小网络。修复QUEN 3.5 0.8b推理循环靠写Python和50批练习,实测识别游戏耗时近一小时。本文梳理能力边界与两个安全提醒。

GPT-6 Astra 改写 Qwen 权重:7.9% 到 48.1%,是学会了数学还是学会了停?
MIT研究者用GPT-6 Astra直接编辑Qwen权重,数学得分从7.9%升至48.1%,全程无训练。但独立复现显示,提升主要来自修复循环、让模型学会终止作答,而非新增数学能力。