ICLR投稿量突破4.7万?学术会议爆炸式增长背后的隐忧
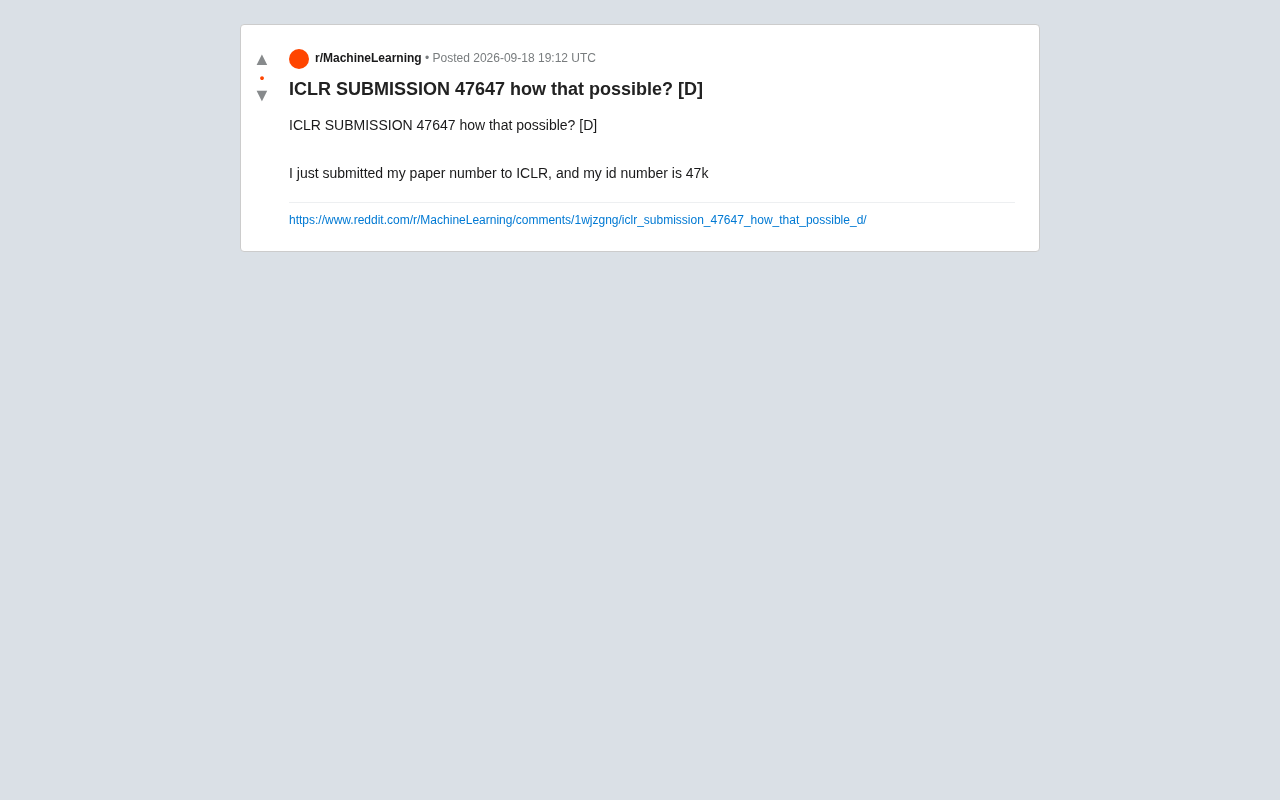
ICLR投稿编号达47647,折射出AI顶会规模急剧膨胀与评审危机加剧的学术生态困境。
近日Reddit上一位研究者晒出的ICLR投稿编号47647,引发了学术界对顶会投稿规模失控的广泛讨论。尽管编号不等同于实际投稿量,但这一数字仍清晰指向一个趋势:大模型浪潮降低了研究门槛,全球AI人才爆发式涌入,加之学术评价体系对"顶会论文"的强烈需求,共同将投稿量推向前所未有的高度。规模膨胀的直接代价是同行评审质量的下滑——审稿人严重不足、评分随机性增大,"评审彩票化"现象愈演愈烈。对于研究者而言,当顶会中稿数量以万计时,单纯的会议标签已难以代表真正的学术价值,论文被引用、复现和延展的实际影响力才是更可靠的评判尺度。
一个投稿编号引发的讨论
近日,一位研究者在Reddit机器学习社区发帖,晒出了自己提交至ICLR(国际学习表征会议)的论文编号——47647。这个看似平常的数字瞬间引发了热议:如果投稿编号已经排到了4.7万,那么本届ICLR的投稿总量究竟达到了什么量级?
发帖者的原话很简单:"我刚提交完ICLR论文,拿到的ID号是47k(约4万7千)。"配图为投稿系统的截图。虽然帖子内容简短,但它触及了近年来AI学术界一个越来越尖锐的现实问题:顶级会议的投稿量正在以令人难以置信的速度膨胀。
需要说明的是,投稿系统的ID编号未必等同于实际投稿数量。编号可能包含撤稿、测试提交、跨年度累计或系统预留等因素。但即便打个折扣,这个数字仍然指向一个明确趋势——机器学习顶会的规模正在急剧扩张。
顶会投稿量为何一路飙升
ICLR作为深度学习领域最具影响力的会议之一,其投稿量的增长轨迹几乎是整个AI研究热潮的缩影。从早期的数百篇,到后来的数千篇,再到如今动辄上万的规模,背后有几股力量在共同推动。
大模型浪潮让入行门槛在某种意义上降低了。开源框架、预训练模型和云算力的普及,使得更多研究者能够快速产出可投稿的成果。话说回来,学术界和工业界对"顶会论文"的强烈需求——无论是博士毕业、职称评定还是求职简历——都在制造巨大的投稿动力。
全球AI人才的爆发式增长同样功不可没。越来越多的高校、企业实验室和初创团队涌入这一领域,投稿基数自然水涨船高。当一个领域成为全球科技竞争的焦点时,论文数量的膨胀几乎是必然结果。
ICLR(International Conference on Learning Representations,国际学习表征会议)由Yoshua Bengio和Yann LeCun等深度学习先驱于2013年创办,最初规模极小,首届投稿仅约150篇。其定位是专注于表征学习与深度神经网络,与NeurIPS、ICML并称深度学习领域三大顶会。ICLR采用OpenReview平台进行公开评审,审稿意见和作者回应对公众可见,这一透明机制在学术界颇具争议但也颇受关注。从2019年约1500篇投稿,到2022年突破1万篇,再到近年疑似逼近数万量级,ICLR的增长曲线几乎与全球AI投资热度完全吻合,是观察AI研究生态扩张最直观的窗口之一。
规模膨胀带来的评审危机
投稿量的暴涨直接冲击着同行评审这一学术质量的基石。如果一届会议真的要处理数万篇投稿,就意味着需要动员数以万计的审稿人,而合格审稿人的数量增长远远跟不上投稿的膨胀速度。
这带来了一系列连锁反应:单个审稿人被分配过多论文、评审质量下降、评分随机性增大、优秀论文可能被埋没、灌水论文可能蒙混过关。近年来关于顶会"评审彩票化"的抱怨屡见不鲜,本质上正是供需失衡的产物。
更棘手的是,随着大模型能够辅助甚至部分代写论文和评审意见,学术诚信的边界变得模糊。会议组织者不得不投入更多精力去甄别AI生成内容、检测重复投稿和防范评审操纵。规模越大,治理成本越高。
所谓"评审彩票化"(Review Lottery),是指论文能否被接收在很大程度上取决于随机分配到的审稿人,而非论文本身的质量。这一现象已有实证研究支撑:2014年NIPS(现NeurIPS)曾做过一个著名实验,将约10%的投稿同时交给两组独立审稿人评审,结果发现两组的接收决定有约57%不一致——也就是说,超过一半的论文命运在不同评审组中会得到截然相反的结论。随着投稿量持续膨胀、审稿人负担加重,这种随机性只会进一步放大。部分会议已尝试引入元审稿人(Meta-reviewer)制度、开放式同行评审或审稿人激励机制来缓解问题,但目前尚无公认的系统性解决方案。
这对研究者意味着什么
对于身处其中的研究者而言,这个4.7万的编号既是机遇也是压力。一方面,庞大的投稿池说明领域活跃、机会众多;另一方面,接收率被摊薄、竞争白热化,一篇论文能否中稿越来越依赖话题热度、写作包装乃至运气成分。
理性看待会议标签的价值或许更为重要。当顶会论文数量以万计时,单纯的"中稿"标签所承载的稀缺性正在稀释。真正有生命力的工作,最终仍然依靠其被后续研究引用、复现和延展的实际影响力来证明自己,而非投稿系统里的一个编号。
这场关于投稿编号的短暂讨论,折射出的是整个AI学术生态在高速扩张下的成长阵痛。会议组织者、评审机制和评价体系都面临着重构的压力。如何在保持开放性的同时守住质量底线,将是未来几年学术共同体必须回答的问题。
相关推荐
METIS-Core:纯C++强化学习框架,为生产环境剔除Python开销
METIS-Core 是一个纯 C++ 编写的开源强化学习框架,基于 LibTorch 剔除 Python 执行开销,支持 DQN、多智能体 MARL 和多线程 MCTS 的 AlphaZero,面向机器人、交易等低延迟生产场景。
nzb360 v25 发布:新增观看追踪,媒体服务器管理再升级
nzb360 v25 正式发布,新增 Tracearr 观看追踪功能,可在 Sonarr、Radarr 和 Dashboard 中追踪用户观看记录,同时用 Chaptarr 替代 Readarr,全面重构界面并优化性能、缩减 APK 体积 30% 以上。
世界模型公司为何守口如瓶:资本狂热下的信息黑箱
世界模型公司手握巨额资金和市场热度,却从创始人到数据供应商都对技术进展守口如瓶。本文剖析这一AI新兴赛道信息不透明背后的竞争、估值与数据供应链原因,以及由此带来的行业隐忧。