Intent.md重塑AI开发:Anthropic智能体协作新范式
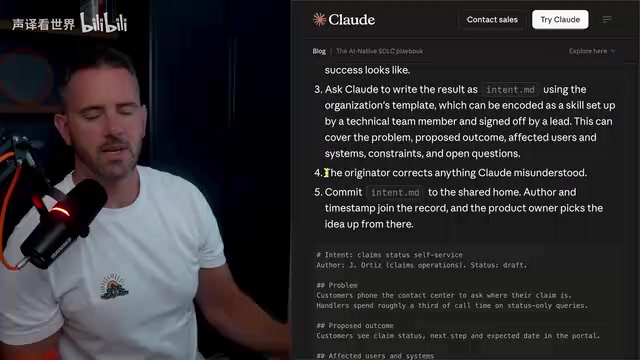
Anthropic团队近期发布了AI原生软件开发生命周期(SDLC)实践手册,核心理念是通过Intent.md文件重构传统开发流程。这套方法论由Claude Code创作者Veris Cherney团队提出,旨在将AI智能体深度融入从需求到维护的全流程。
从代码瓶颈到流程瓶颈的范式转变
软件开发生命周期(Software Development Life Cycle, SDLC)是软件工程中用于描述软件从概念到退役全过程的框架模型。经典的瀑布模型(Waterfall Model)由Winston Royce于1970年提出,强调阶段间的顺序依赖;敏捷开发(Agile)在2001年由《敏捷宣言》确立,强调迭代交付和快速响应变化;DevOps则是2009年后兴起的文化运动,打通开发与运维的壁垒。传统SDLC中,构建(编码)阶段通常占据整个项目30-50%的时间成本,因为需要人工逐行编写、调试代码。而测试和维护阶段往往占据软件总成本的60-70%,这也是为什么业界一直在探索自动化测试、持续集成等实践来优化这些环节。
传统SDLC包含规划、设计、构建、测试、部署和维护六个阶段,其中构建环节耗时最长、成本最高。但AI智能体的出现改变了这一格局——构建阶段被大幅压缩,速度提升2倍以上。
AI智能体(AI Agent)是指能够感知环境、自主决策并执行任务的人工智能系统。与传统的对话式AI(如早期的ChatGPT)不同,智能体具备工具调用能力(Tool Use)——它可以读写文件、执行命令、调用API等,而不仅仅是生成文本。这一能力源于大语言模型的Function Calling机制:模型输出结构化的函数调用请求(如read_file、run_command),由外部系统执行后将结果返回模型。Claude的Computer Use、OpenAI的GPT-4 with Code Interpreter都是这一范式的实现。在软件开发场景中,智能体可以像人类开发者一样操作IDE、运行测试、提交代码,但速度可达人类的数倍甚至数十倍,且不受疲劳限制。
Anthropicㄢ出的关键问题是:如何利用智能体优化其他所有环节?这标志着开发瓶颈的本质转变:代码编写不再是限制因素,流程设计才是。新范式要求我们重新审视每个环节的人机协作模式,而Intent.md正是这套体系的核心工件。
Intent.md:人机协作的新接口
什么是Intent.md
Intent.md是既可供人类阅读又可供机器解析的需求文档。
产品需求文档(Product Requirements Document, PRD)是互联网行业的标准需求表达方式,通常由产品经理编写,包含用户故事(User Story)、功能列表、验收标准(Acceptance Criteria)等结构化内容。传统PRD存在明显的信息损耗问题:客户的原始痛点→产品经理的理解→开发的技术方案,每一层转译都可能偏离初衷。根据Standish Group的研究,需求不明确是软件项目失败的首要原因(占比37%)。敏捷开发引入了User Story('作为[角色],我希望[功能],以便[价值]')和Story Point(复杂度估算单位)来细化需求,但仍然是人类之间的多层传递,无法完全消除理解偏差。
Intent.md的革命性在于跳过中间层——通过AI智能体直接与需求发起者对话,将隐性知识(tacit knowledge)如业务背景、约束条件、历史决策等直接编码到文档中,大幅减少了'需求理解偏差'这一软件项目失败的首要原因。它通过智能体与需求发起者的深度对话生成,直接捕获源头痛点和上下文。
创建流程分为三步:
- 智能体访谈:使用Discovery技能(如Switch Dimension Discovery或Cursor需求发现)让智能体反复提问,直到完全理解需求
- 上下文注入:需求发起者将领域知识、经验和约束大量输入对话
- 文档生成:智能体综合信息并保存为
/intent/*.md文件
关键优势在于消除了传统流程中的多次转译损耗——需求不再经过用户故事、故事点、待办事项等多层传递,而是从发起者直达智能体。
谁可以创建Intent
Intent的发起者可以是任何角色:
- 提交Bug的客户
- 有功能想法的产品经理
- 记录流程改进的开发者
这种开放性打破了传统需求管理的层级限制。所有Intent汇总后由产品负责人审查分类,可使用标签系统(前端/后端、大任务/小任务、优先级等)管理,甚至可以让智能体自动分类。
工件链:从Intent到Deployment
工件(Artifact)在软件工程中指开发过程中产生的可交付物,如需求文档、设计图、代码、测试报告等。传统开发中,这些工件往往分散在不同工具中(Jira管理需求、Confluence存储文档、GitHub托管代码),缺乏有机联系,导致信息孤岛问题。Intent→Spec→Plan→Code这条工件链借鉴了'文档驱动开发'(Documentation-Driven Development, DDD)的思想——先写文档再写代码,确保设计与实现一致。但AI原生工件链增加了机器可读性:每份文档既是人类决策的记录,也是下游智能体的输入(通过Markdown的结构化格式和自然语言描述)。这种设计使得AI可以在整个SDLC中保持上下文连贯性,而不是每个阶段都从零开始理解需求。
Spec.md:自动生成技术规格
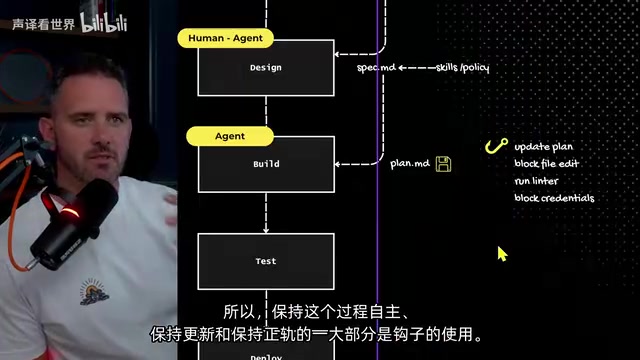
Intent批准后,通过钩子(Hook)或自动流程触发Spec.md生成。
钩子(Hook)是编程中的事件响应机制,源自操作系统的中断处理概念。在现代软件开发中,Git Hooks(如pre-commit、post-merge)、Webhook(HTTP回调)、CI/CD Pipeline都是钩子的应用——当特定事件发生时(如代码提交、Issue创建、PR合并)自动触发预定义的操作(如运行测试、发送通知、部署服务)。GitHub Actions、GitLab CI、Jenkins等平台都基于钩子机制实现自动化工作流。Anthropic提到的'通过钩子触发Spec.md生成'是将这一机制扩展到AI工作流中:当Intent.md被批准(如通过标签标记或移动到特定目录)时,自动唤起智能体执行Intent→Spec的转换任务,无需人工介入。
Anthropicㄢ供的提示词模板可将Intent转化为详细的需求和设计规格,应用样式指南和最佳实践。
关键实践:
- 使用Agents.md或技能库确保规格符合组织治理标准
- 原生计划模式(Cursor/Claude Code)可直接生成规格
- 定制技能可生成团队特定格式的规格文档
Plan.md:可执行的实施方案
工程师拉取Intent和Spec后,通过计划模式生成Plan.md。这份文档应详尽到可以独立交付给任何工程师执行,而无需参考上游文档。
Plan.md结构包括:
- 需要更改的文件清单
- 工作顺序和任务列表
- 风险与约束
- 成功标准和验证检查
审查时要反复询问"哪些地方可能出错",确保计划的完备性。
自主执行与治理平衡
自动模式的权限设计
Anthropicㄧ议在受控环境中使用自动模式,但前提是建立完善的权限体系:
- 明确智能体可访问的工具范围
- 锁定允许的网络源和依赖包
- 通过Cursor或Claude权限系统实施策略
只有在政策调优完成后,才能让智能体在无人值守情况下高速运转。
多智能体协作
工作树(Worktree)是Git 2.5+(2015年发布)引入的特性,允许在同一仓库中同时检出(checkout)多个分支到不同目录,实现真正的并行开发而无需克隆多份代码。传统上,开发者需要频繁切换分支(git checkout)或维护多个仓库副本(git clone),导致上下文切换成本高(每次切换需重新构建、重启服务等)。工作树通过git worktree add命令创建额外的工作副本,共享同一个.git目录,节省磁盘空间且保持元数据同步。在AI原生开发中,工作树的价值被放大:可以让多个智能体实例各自在独立的工作树中处理不同任务(如一个修Bug、一个开发新功能),彼此不干扰,最后通过PR合并回主分支。
现代开发环境支持工作树(Worktree)和子智能体,可以:
- 让多个智能体并行处理不同任务
- 每个智能体在独立上下文窗口中工作
- 通过工件文档(Intent/Spec/Plan)而非对话历史传递信息
上下文窗口(Context Window)是大语言模型的核心限制之一,指模型一次能处理的最大文本量(以Token计,1 Token约0.75个英文单词或0.5个中文字)。早期GPT-3(2020)仅支持4K tokens(约3000个英文单词),GPT-4(2023)扩展到32K/128K,Claude 3.5(2024)目前支持200K tokens。对话历史、代码库内容、系统提示词都会占用上下文窗口,一旦超限,模型就会'遗忘'早期信息(类似人类短期记忆的容量限制)。这也是为什么传统的'一个对话式AI完成整个项目'不可行——一个中等规模的项目(10万行代码)轻易超过百万tokens。Anthropic提出的多智能体+工件传递方案巧妙规避了这一限制:每个智能体只需理解当前任务的Intent/Spec/Plan(通常几千tokens),而不需要加载整个项目历史,实现了'无状态'的任务分发模式。
这种架构避免了单一上下文窗口的限制,使大型项目的并行开发成为可能。
代码审查与质量门禁
视觉测试(Visual Testing)是UI测试的重要分支,通过截图对比检测界面变化,弥补传统功能测试的盲区。传统的功能测试(如Selenium、Puppeteer)只验证DOM结构和交互逻辑(如'按钮是否可点击'、'表单提交是否成功'),无法捕捉CSS渲染错误、布局错乱、字体加载失败等视觉问题。Playwright、Cypress等现代测试框架支持像素级截图对比(Pixel-Perfect Comparison):对每个测试用例保存基准截图(Baseline),后续运行时将新截图与基准对比,可检测1像素的偏移或颜色差异。Applitools、Percy等专业平台进一步引入智能对比算法,过滤动态内容(如时间戳、广告)的干扰。在AI原生开发中,智能体可以自动生成测试用例、运行Playwright脚本并分析视觉差异——这在快速迭代的场景中尤为重要,因为人工视觉检查成本高且易遗漏。
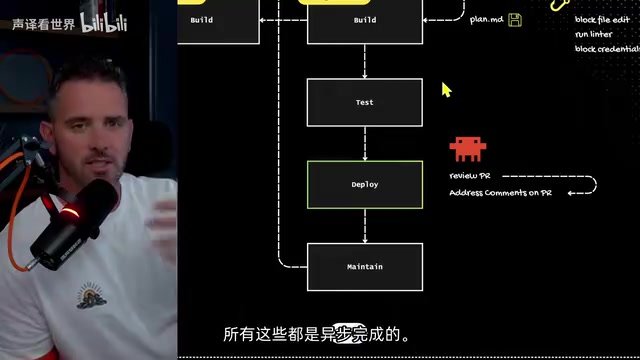
测试阶段引入多层自动化验证:
- 智能体自测:编写并运行单元测试、端到端测试
- 代码检查:运行Linter和构建验证
- 视觉测试:使用Playwright/Cursor Browser进行UI测试和截图
- PR审查:独立的Claude实例基于安全政策审查拉取请求
维护阶段的自主诊断
可观测性(Observability)是现代云原生架构的三大支柱之一(另外两个是微服务和容器化),源自控制论对系统内部状态的推断能力。它通过日志(Logs,记录离散事件)、指标(Metrics,记录时间序列数据如CPU使用率)、追踪(Traces,记录请求在分布式系统中的调用路径)三大支柱全面了解系统运行状态。Prometheus、Grafana、Jaeger、ELK Stack是常用工具栈。传统监控是被动的(Reactive)——设置阈值告警(如'CPU>80%'),超限后人工响应。而主动监控(Proactive Monitoring)结合AI能力可以实现异常预测和自主诊断:通过机器学习识别指标的异常模式(如流量突降、错误率飙升、响应时间变长),在故障影响扩大前就触发处理流程。AIOps(AI for IT Operations)是Gartner在2016年提出的概念,将AI应用于IT运维,实现从救火式响应到预防式治理的范式转变。
最具前瞻性的部分是维护阶段的自动化。传统上,维护是被动响应式的——等待报警或工单。AI原生流程中,智能体可以:
- 主动监控:基于指标异常(页面崩溃、API限流)自动触发
- 自主诊断:分析日志、生成问题Intent.md
- 方案建议:在人类介入前提供诊断和修复建议
例如,凌晨3点服务器故障时,智能体已完成初步诊断并生成Intent,工程师醒来即可审查方案而非从零开始排查。这是AIOps理念的体现——将运维从救火式响应转变为预防式治理。
评估与持续优化
持续评估(Continuous Evaluation)是机器学习系统工程中的关键实践,类似于软件工程中的持续集成(CI)。由于大语言模型会定期更新(如Claude 3.5 Sonnet→Claude 4,或OpenAI的模型快照切换),或团队会调整提示词(Prompt)和技能库(Skills),需要验证这些变更是否改善或恶化了AI在实际任务上的表现。基准测试集(Benchmark Dataset)通常包含20-100个真实案例,覆盖常见场景(如'生成CRUD API')和边缘情况(如'处理Unicode字符')。每次变更后运行评估,检测准确率、代码质量(通过Linter)、测试通过率等指标是否回归(Regression,即性能下降)。这与A/B测试、金丝雀发布(Canary Deployment)等灰度策略一脉相承——先在小范围验证,确认无问题后再全量推广,确保AI能力的迭代是可控、可验证的,避免'模型更新后反而不如旧版'的问题。
Anthropicㄧ议建立持续评估体系:
- 收集代码库中20个典型问题作为基准测试集
- 每次模型升级或技能更新时运行评估
- 检测SDLC流程是否出现回归
这种方法将传统CI/CD中的持续集成扩展为"持续评估",确保AI能力提升真正转化为流程改进。
实施建议与注意事项
这套方法论不是推翻现有工作流的理由。如果你已在使用Superpowers、BMAT或自研系统,应该:
- 渐进式采纳Intent.md等核心概念
- 保留团队已验证的有效实践
- 根据项目关键性调整人类审查的介入深度
没有放之四海而皆准的方案,从简单的计划模式到复杂的编排系统,关键是找到适合团队的人机协作平衡点。治理框架(权限、钩子、代码检查)是确保安全和质量的前提,不可跳过。
结语
Intent.md范式的本质是将隐性知识显性化、将临时对话持久化。它不仅是文档格式的创新,更是开发协作模式的重构——从人类手写代码到人类定义意图、智能体执行实施。随着多智能体协作和自主维护能力的成熟,SDLC的每个环节都在被重新定义。对于希望构建AI原生开发流程的团队,这份实践手册提供了可落地的起点。
相关推荐
Claude挑战循环真相:Wayfinder技能修复AI一次构建应用
解析Claude挑战循环(Challenge Loop)的运作原理与两大致命缺陷,以及如何用Matt Pocock的Wayfinder技能生成可验证规格文件,让AI代理一次性构建真实项目而非仅限游戏演示。
Claude Code 令牌耗尽?7个隐藏消耗点审计与修复指南
Claude Code 总是提前撞上令牌限制?本文拆解 Token 复合增长的底层机制,梳理从 /clear 到定时任务的七个隐藏消耗点,并澄清短提示、压缩、截图等无效省钱建议,附实用自查命令与审计方法。
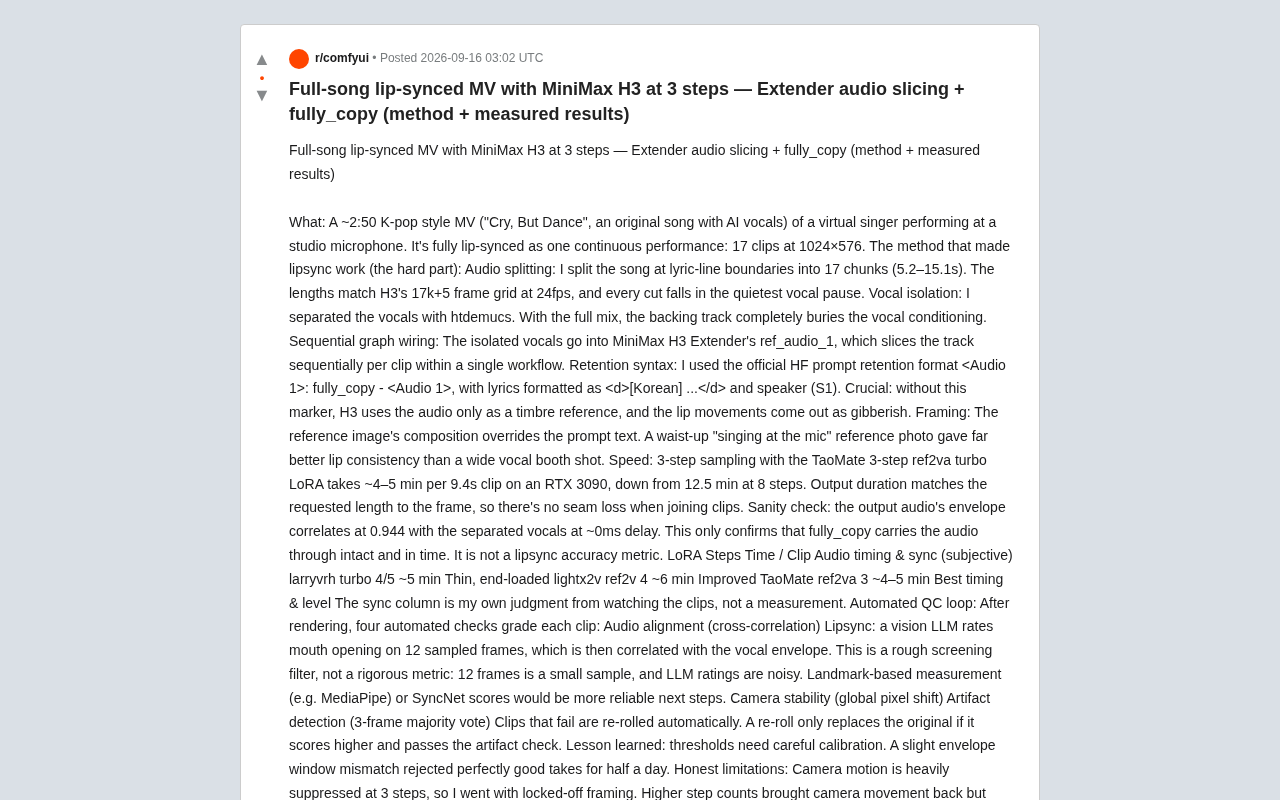
MiniMax H3实测:3步采样打造整首歌口型同步MV
一位创作者用MiniMax H3 Extender制作整首歌口型同步MV的完整实测:音频切片、htdemucs人声隔离、fully_copy保留语法、3步turbo LoRA提速,附三款LoRA对比与自动化质检方案。