IntentLens:生成图表前先看清指标定义的本地数据分析工具

IntentLens 是一款本地数据可视化工具,强制用户在生成图表前审查聚合逻辑,防止图表在数学上正确却回答错误的问题。
IntentLens 针对数据分析中一个常被忽视的陷阱而设计:图表可能在数学上完全正确,却因聚合方式不同而回答了截然不同的问题——整体转化率与分组平均转化率的典型差异就是例证。这款本地运行的 Excel/CSV 可视化工作台,在生成图表之前强制暴露分组方式、聚合逻辑、比率定义和缺失值处理供用户审查。技术上,模型只提出声明式分析方案而非直接执行任意代码,兼顾了可控性与安全性。项目提供无需安装的在线示例,完整版支持自有文件与大模型对话,已在 GitHub 开源,但仍为开发版,模型辅助时会向服务商发送字段元数据,隐私边界需用户自行评估。
一张图表为什么会答错问题
图表看起来可能很正确,却在回答一个错误的问题。这是 IntentLens 作者提出的核心观察,也是整个项目的出发点。
开发者用一个简单的例子说明了这个陷阱。假设有两组数据:
- A 组:100 次访问产生 10 次转化 → 转化率 10%
- B 组:10 次访问产生 5 次转化 → 转化率 50%
如果计算整体转化率,结果是 15 / 110 ≈ 13.64%;而如果取两组转化率的平均值,结果却是 30%。两种算法在数学上都成立,但它们回答的是完全不同的问题。
问题在于,大多数分析工具会直接把这种选择隐藏在图表背后。等图表生成出来,使用者往往已经默认了某种聚合逻辑,却没有机会确认这是否符合自己真正想问的问题。IntentLens 想做的,就是把这个选择在图表生成之前显式地摆到台面上。
这个现象在统计学中与「辛普森悖论」(Simpson's Paradox)密切相关——当数据按子组聚合时,整体趋势可能与每个子组内部的趋势完全相反。经典案例来自1973年加州大学伯克利分校的录取数据:整体上看似存在对女性的录取歧视,但逐院系拆分后,大多数院系实际上对女性录取率更高,差异来自女性更倾向于申请竞争激烈的院系。转化率的例子属于同一类陷阱:加权方式不同,结论可以截然相反。这也是为什么「选择聚合方式」不是技术细节,而是分析意图本身的一部分——不同的聚合逻辑对应不同的业务问题,混用会得出看起来合理却在业务上无意义的结论。
IntentLens 在构建什么
IntentLens 是一款本地运行的 Excel/CSV 可视化工作台,它的工作流程被明确拆解为几个步骤:
导入数据 → 描述问题 → 审查方案 → 计算 → 优化 → 导出
这个流程中最关键的环节是「审查方案」。在真正执行计算之前,用户可以检查分组方式(grouping)、聚合逻辑(aggregation)、比率定义(ratio definitions)以及缺失值的处理方式(missing-value handling)。完整版应用还支持图表修订和可复现的导出。
从技术设计上看,IntentLens 有一个值得关注的取舍:模型并不直接生成任意的 Python 或 JavaScript 代码去执行,而是提出声明式的分析方案(declarative analysis plans)。应用会先验证这些方案,再基于数据快照进行计算。这种做法避免了「让大模型随意跑代码」带来的不可控性和安全隐患,也让每一步计算逻辑都可被人工审查。
为什么声明式方案更安全
让 AI 直接执行代码在数据分析场景中并不少见,但风险也很明显——生成的代码可能有副作用、难以复现、也难以在执行前判断对错。IntentLens 用「方案先行、验证后算」的思路,把 AI 的角色限定在「提议分析逻辑」而非「直接操作数据」,这与近期不少 AI 工具强调的可控性方向一致。
声明式(declarative)与命令式(imperative)是两种截然不同的编程范式。命令式代码描述「如何做」——比如一段 Python 脚本逐步操作 DataFrame;声明式代码描述「要什么」——比如「按月份分组、对转化次数求和、除以访问次数得到转化率」。在 AI 生成代码的场景中,命令式脚本的风险在于:模型可能引入文件读写、网络请求或意外的数据修改,且人工审查一段代码的成本远高于审查一份结构化的分析意图描述。声明式方案将 AI 的输出限定为可枚举的操作类型(分组、聚合、过滤等),应用层可以对这些操作进行白名单校验,从根本上隔离了代码执行带来的副作用风险,也使每一步逻辑都能以自然语言向用户解释清楚。
无需安装的在线示例
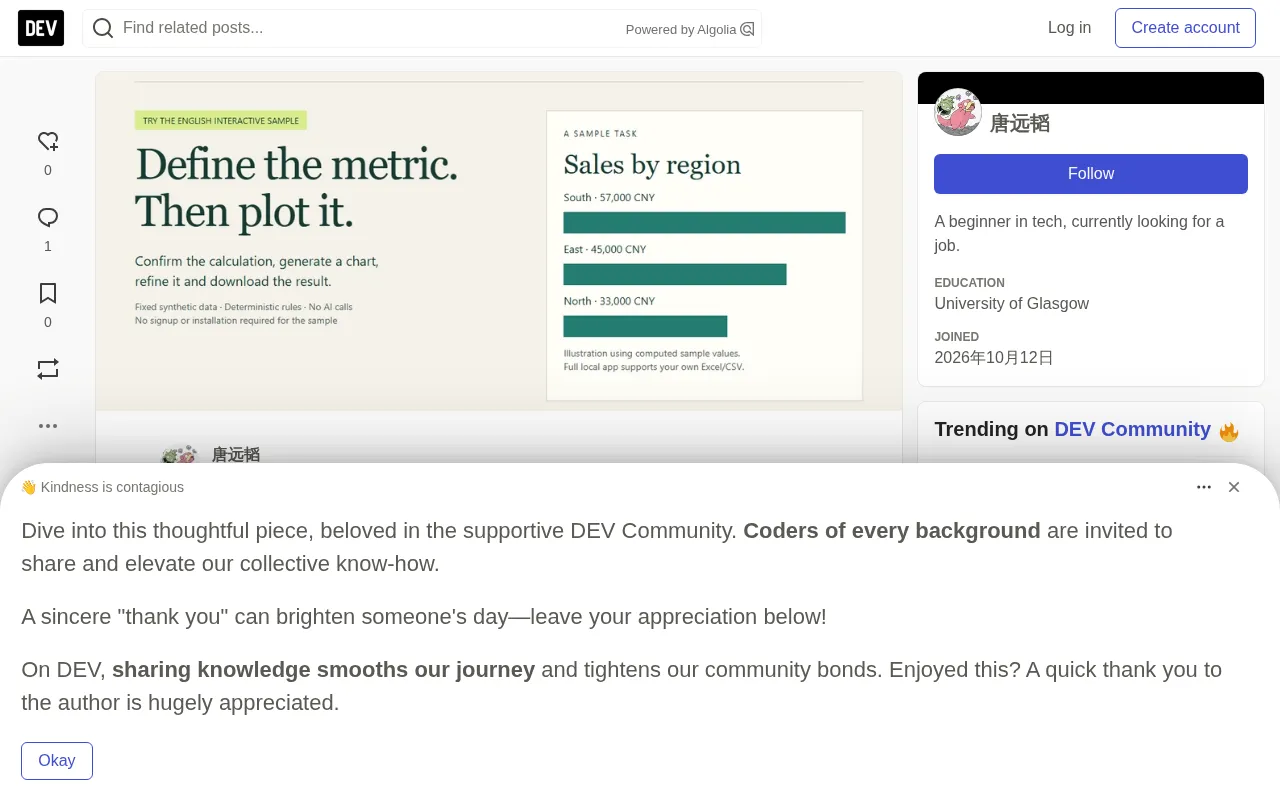
开发者提供了一个无需安装、注册或 API Key 的英文交互示例,可以直接在浏览器里体验。
建议尝试的一个小任务是:
- 选择转化率相关的问题
- 对比「整体转化率」与「月度平均转化率」
- 生成图表
- 修改图表标题或排序
- 下载结果
需要特别说明的是,公开示例使用固定的合成数据和确定性规则,它不会调用 AI,也不接受文件上传。文章开头那个两组数据的例子只是用来解释概念,与示例中实际的 12 条记录数据集是分开的。
这种设计让用户可以在零成本、零风险的情况下先理解「确认指标定义」这一步到底带来了什么价值,再决定是否部署完整版本。
完整本地版本的能力
完整的工作台支持处理用户自己的 Excel/CSV 文件,支持与配置好的大模型进行对话,提供多种图表引擎以及修订历史记录。
开发者还录制了一段英文演示,展示了真实的本地工作流程:上传一个合成 CSV 文件、输入问题、由 DeepSeek广告 返回分析方案、生成图表,并将计算得到的区域合计值与原始输入数据进行了核对。
不过作者也坦诚说明了当前的局限:这仍是一个开发版本,面向可信任的本地单用户使用场景。模型辅助的方案规划需要 API Key,并且会把字段元数据和统计信息发送给所配置的服务商。换句话说,隐私边界需要用户自己评估——本地计算的是数据本身,但字段结构和统计摘要会离开本地。源代码与安装说明已在 GitHub 开源。
作者在寻求的反馈
这个项目最有意思的地方,是开发者对「确认步骤是否真的值得」保持开放态度。他明确提出想验证:在真实的报表工作流中,这个确认环节究竟是防止了错误,还是只增加了摩擦。
针对经常和电子表格打交道的用户,他抛出了几个具体问题:
- 在你上一份报表中,审查指标定义能否避免一个错误,还是只会拖慢速度?
- 在示例中你在哪一步卡住了?
- 你会改用什么替代方案,那个工作流有什么做得更好的地方?
作者还在招募五位有周期性报表任务的用户,用公开或脱敏数据试用完整版应用。
对于习惯了「AI 一键出图」的用户来说,IntentLens 代表了一种相反的思路:慢一点,先把问题定义清楚,再让机器计算。在 AI 越来越擅长「快速给答案」的当下,这种强调「先对齐问题」的工具,或许正好击中了数据分析中最容易被忽视的痛点。
相关推荐

B站保姆级Codex攻略:从安装到实战,让AI帮你操作电脑
基于B站保姆级教程,详解Codex从安装、工作模式设置到项目文件夹管理、文件整理、计划模式与可视化仪表盘的完整实战流程,附使用心法与注意事项。

Agent Skills渐进式披露架构详解:让AI智能体拥有无限能力
详解Agent Skills渐进式披露架构:从什么是Agent Skills、解决什么问题,到如何定义Skills列表与调用工具,并对比Multi-Agent的区别,帮助开发者快速掌握这一AI智能体能力扩展方案。

Agent Loop面试十连问:B站最细Loop Engineering教程拆解
B站Agent Loop面试十连问教程拆解:从生命周期、工具、记忆、交付物四个维度讲清Agent Loop与单次API调用的本质区别,附可直接套用的面试回答模板,帮你在Loop Engineering面试中少走弯路。