IntLawNER:国际法领域首个命名实体识别数据集与基准
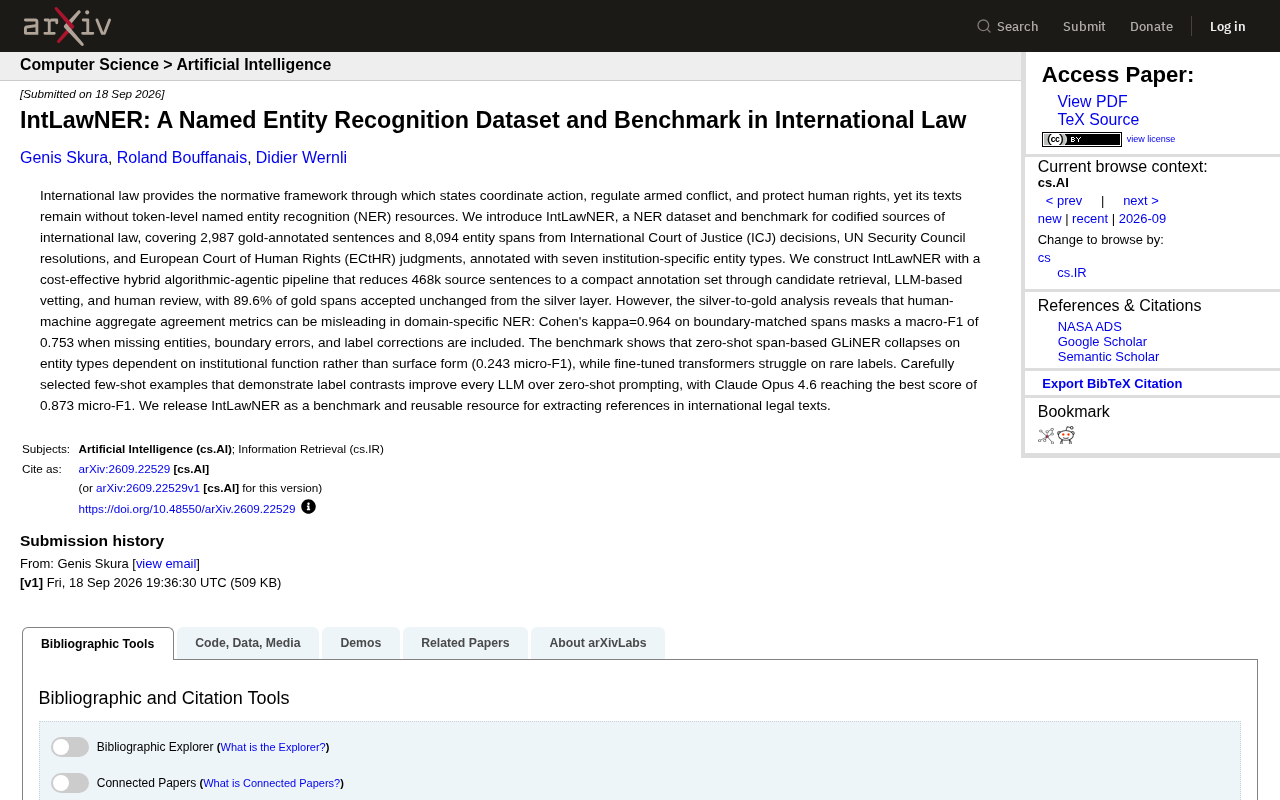
IntLawNER是首个国际法词元级NER基准,揭示了评估指标陷阱与机构职能型实体的识别难题。
IntLawNER是一个专为国际法文本设计的命名实体识别数据集与基准,覆盖ICJ判决、联合国安理会决议和ECtHR裁决三类来源,包含2,987个人工标注句子和8,094个实体片段。研究团队采用算法与大语言模型智能体协同的混合流水线,将46.8万句源文本压缩为精简标注集,89.6%的机器初步标注被直接采纳,大幅降低了纯人工成本。论文最具方法论价值的发现是评估指标的陷阱:Cohen's kappa高达0.964,但纳入遗漏实体和边界错误后宏观F1骤降至0.753,揭示单一高分指标的误导性。基准测试显示,零样本GLiNER在机构职能型实体上几乎失效(微观F1仅0.243),而配合对比性少样本示例的Claude Opus 4.6取得最佳成绩(0.873),为法律科技和跨国司法文本分析提供了坚实起点。
国际法是各国协调行动、规范武装冲突、保护人权的规范框架,但这些法律文本长期缺乏词元级别的命名实体识别(NER)资源。一篇发表于 arXiv 的新论文提出了 IntLawNER——一个专门面向成文国际法源的 NER 数据集与基准,试图填补这一空白。
为什么国际法需要专属的 NER 资源
命名实体识别是自然语言处理中的基础任务,目标是从文本中识别出人名、机构、地点等实体。但通用 NER 模型在国际法文本上往往力不从心,因为这类文本的实体不仅依赖字面形式,还高度依赖机构职能语境。
研究团队从三大权威法律来源提取语料:国际法院(ICJ)判决、联合国安理会决议,以及欧洲人权法院(ECtHR)裁决。最终 IntLawNER 包含 2,987 个人工黄金标注句子和 8,094 个实体片段,并按机构特性划分为七种实体类型。这种以机构为核心的标注方案,正是它区别于通用 NER 数据集的关键所在。
国际法文本在语言上有几个显著特征,使其难以套用通用NER工具。首先,国际法中的「机构职能依赖型实体」大量存在——例如「缔约国」「申诉方」「高级专员」等称谓,其实体类型取决于它们在特定法律程序中所扮演的角色,而非字面词语本身。同一个词语在不同语境下可能归属完全不同的实体类别。其次,国际法文本高度引用性,充斥着对条约条款、决议编号、案件名称的交叉引用,这些引用本身也构成需要识别的实体。最后,ICJ判决、安理会决议与ECtHR裁决三类文本在写作风格、法律传统和机构惯例上均有显著差异,单一领域的训练数据很难泛化到其他场景。这些特性共同决定了国际法NER需要专属的、基于机构职能的标注体系,而非沿用新闻或生物医学等领域的现有方案。
混合式标注流水线:算法与智能体协同
从零构建高质量法律标注数据集成本极高。研究团队设计了一套兼顾成本与质量的混合算法-智能体流水线,将原始的 46.8 万句源文本压缩为一个精简的标注集合。
这套流程包含三个环节:候选检索(candidate retrieval)、基于大语言模型的审查(LLM-based vetting),以及人工复核。值得关注的是,在最终的黄金标注中,有 89.6% 的实体片段直接从「银层」(silver layer,即机器初步标注结果)原封不动地被接受,说明自动化环节的初始质量相当高。这种设计大幅降低了纯人工标注的负担,为专业领域数据集构建提供了可复用的范式。
一致性指标的陷阱:Kappa 高不等于质量好
论文中最具方法论价值的发现,来自银层到黄金层的转换分析。研究揭示了一个容易被忽视的问题:在领域特定的 NER 任务中,人机聚合一致性指标可能具有误导性。
具体来说,在边界匹配的片段上,Cohen's kappa 达到了 0.964,看似接近完美一致。但一旦把遗漏实体、边界错误和标签修正都纳入考量,宏观 F1(macro-F1)骤降至 0.753。这意味着仅看高 kappa 值会掩盖模型在实际标注中的诸多缺陷。对于依赖专业标注的研究者而言,这一警示提醒我们:评估指标的选择必须与任务复杂度相匹配,单一高分并不能代表整体质量。
Cohen's kappa 是评估两位标注者(或人与模型)之间标注一致性的经典统计量,其值域为-1到1,1表示完全一致,0表示与随机标注无异。在NER任务中,kappa通常在「已识别出的片段」上计算,即只统计双方都认定存在实体的位置上标签是否一致。这种计算方式天然会跳过「一方认为存在实体而另一方未标注」的情况,导致指标虚高。宏观F1(macro-F1)则对每个实体类别分别计算精确率和召回率后取平均,稀有类别与常见类别权重相同,因此能够充分暴露模型在低频实体上的失败。两个指标的剧烈落差(0.964 vs 0.753)在本质上反映了「片段边界命中率」与「完整实体召回能力」之间的根本区别——高kappa仅说明模型识别出的片段标签准确,却掩盖了大量根本未被识别到的实体。
模型基准:从零样本崩溃到少样本逆袭
在基准测试环节,研究团队评估了多种主流方法,结果颇具启发性。
零样本的基于片段的 GLiNER 模型在依赖机构职能(而非表面形式)的实体类型上几乎完全失效,微观 F1 仅为 0.243。这印证了国际法实体识别的核心难点——模型无法仅凭字面模式判断实体的法律含义。而经过微调的 Transformer 模型虽然整体表现更好,却在稀有标签上表现挣扎。
转机来自精心挑选的少样本示例。当提示中包含能够展示标签对比的少样本样例时,所有大语言模型的表现都超越了零样本提示。其中,Claude Opus 4.6 取得了最佳成绩,微观 F1 达到 0.873。这一结果说明,在专业领域任务中,示例的质量和对比性设计,往往比单纯堆砌模型规模更为关键。
GLiNER(Generalist and Lightweight model for NER)是一类基于双编码器或span-based架构的开放NER模型,支持通过自然语言描述实体类型来进行零样本识别,无需为每个新类型重新训练。其核心思路是将实体类型描述与文本片段映射到同一向量空间,通过相似度匹配完成分类。这种设计在通用场景下表现出色,因为常见实体类型(人名、地名、机构名)的语言描述与文本中的表层特征高度对应。然而在国际法中,「申诉国」「被申请人」等实体的识别需要理解程序性角色和法律语境,而非依赖词汇表面规律,这正是GLiNER零样本模式的盲区。少样本提示(few-shot prompting)通过在输入中附上若干标注示例,让模型从示范中习得任务边界和标签对比逻辑,本质上是用上下文学习(in-context learning)弥补模型对领域知识的欠缺,因此在专业领域任务中往往能带来显著的性能跃升。
意义与展望
IntLawNER 作为国际法文本的首个词元级 NER 基准与可复用资源被公开发布,主要用于提取国际法律文本中的引用与实体。
它的价值不仅在于数据集本身,更在于其揭示的两个深层问题:其一,领域特定 NER 中评估指标的可靠性需要重新审视;其二,机构职能依赖型实体对现有模型构成了实质性挑战。对于法律科技、合规检索、以及跨国司法文本分析等应用场景,这一资源提供了坚实的起点。随着大语言模型在专业领域的持续渗透,类似 IntLawNER 这样兼顾成本与质量的构建方法,或将成为高价值垂直数据集的标准做法。
相关推荐
WorkBuddy全功能深度解析:三大模式与企微集成实战
深度解析WorkBuddy三大任务模式、企业微信集成能力与外贸询盘、薪酬核算、定时任务等高价值场景,并客观评估其积分策略与生态绑定限制,为企业选型提供参考。
折叠屏手机能否颠覆竖屏短剧生态?
折叠屏手机展开后的大屏并不适合观看竖屏短视频,两侧留下巨大黑边。与此同时,起源于中国的微短剧正以竖屏格式在美国创造超10亿美元收入。折叠屏全球销量占比不足2%,它能否颠覆竖屏内容生态?
编程定律Tier List:哪些是真知,哪些该被淘汰?
从康威定律到布鲁克斯定律,资深开发者对经典编程定律进行Tier List评级:哪些定律在AI时代依然成立,哪些只是被高估的经验之谈?本文梳理讨论核心观点并延伸思考。