Jetson AGX上优化SegFormer-B2:提升FPS与越野语义分割可靠性

边缘设备越野语义分割的工程实践:在安全性、帧率与精度之间寻找可部署的平衡点。
本文围绕一个在Jetson AGX上运行的越野自主导航项目展开,核心模型为SegFormer-B2,当前在TensorRT FP16下实现20–30 FPS,目标提升至60+ FPS。文章指出,单纯追求帧率或mIoU并非正确方向——最关键的工程挑战是"假可通行"误判:近距离障碍物被识别为可通行地形,这是导航安全的最大威胁。针对此问题,文章重点推荐引入ZED 2i已有的双目深度信息进行RGB-D融合,哪怕只做几何后处理校验也能大幅降低误判率。在加速方面,INT8量化、知识蒸馏(以B2为教师蒸馏至轻量网络)和PIDNet等实时架构是主要路径。训练策略上,应针对高危类别做困难样本挖掘,并引入安全导向的评估指标替代单一mIoU。
在自动驾驶和机器人领域,越野环境下的语义分割一直是块难啃的硬骨头。与结构化的城市道路不同,野外场景缺乏清晰的车道线、路缘和标准化的地物类别,模型既要准确区分可通行区域(traversable)与障碍物,又要在算力受限的边缘设备上保持足够的实时性。最近Reddit上一位开发者分享的工程实践,正好把这个难题的典型挑战摆到了台面上。
项目背景:边缘设备上的越野导航
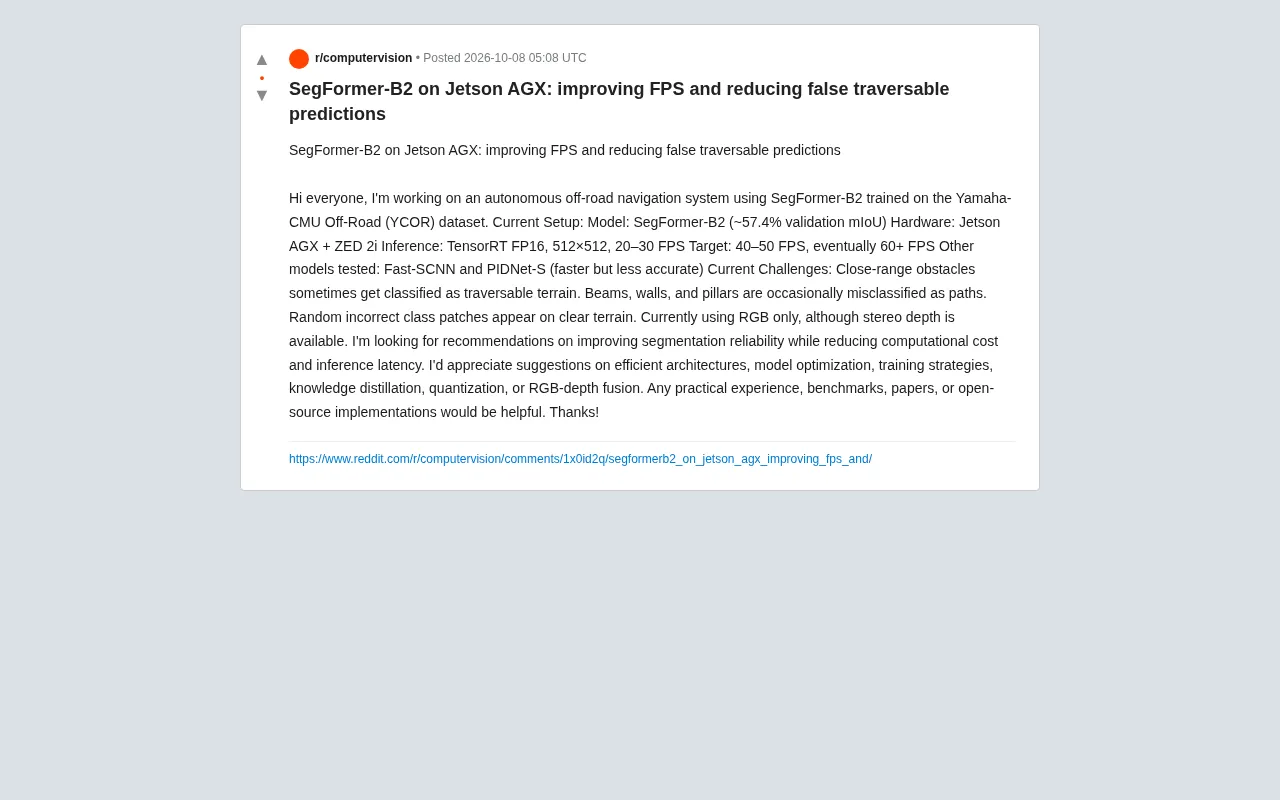
这个项目的目标是搭建一套自主越野导航系统,核心技术栈相当典型:
- 模型:SegFormer-B2,在Yamaha-CMU Off-Road(YCOR)数据集上训练,验证集mIoU约为57.4%
- 硬件:Jetson AGX + ZED 2i双目相机
- 推理:TensorRT FP16量化,输入分辨率512×512,当前帧率20–30 FPS
- 目标:先冲到40–50 FPS,最终希望达到60+ FPS
开发者还测试过Fast-SCNN和PIDNet-S等更轻量的架构,它们速度更快但精度明显不如SegFormer-B2。这其实揭示了边缘端语义分割永恒的矛盾——速度与精度的权衡。SegFormer系列作为基于Transformer的分割模型,在精度上有优势,但自注意力机制带来的计算开销对Jetson这类嵌入式平台并不友好。
SegFormer是由NVIDIA研究院于2021年提出的轻量级Transformer分割框架,其核心创新在于用层次化的Mix Transformer(MiT)编码器替代传统ViT,并采用极简的All-MLP解码器。不同于SETR等早期视觉Transformer方案,SegFormer在编码器阶段通过逐步降低序列长度来控制计算量,使其在精度和效率之间取得了较好的平衡。B0到B5代表从轻到重的六个规格,B2属于中等体量,参数量约25M,在ADE20K等城市场景基准上mIoU超过46%。YCOR(Yamaha-CMU Off-Road)数据集则专为非结构化越野场景设计,包含草地、泥土、灌木、岩石、水域等典型越野类别,是目前越野语义分割领域最常用的公开基准之一,其标注粒度和类别设计直接决定了模型对"可通行性"的理解边界。
核心痛点:危险的"假可通行"预测
从工程落地的角度看,这个项目遇到的问题比单纯的帧率不足更严峻:
- 近距离障碍物被误判为可通行地形——这是安全隐患最大的错误类型
- 横梁、墙壁、立柱偶尔被识别成通路
- 空旷地面上随机出现错误的类别色块
- 目前仅使用RGB输入,但ZED 2i提供的双目深度信息尚未利用
对于导航系统而言,把障碍物误判为可通行区域(false traversable)是致命的。模型宁可保守地把可疑区域标为不可通行,也不能让机器人撞上一堵被误认为是"路"的墙。57.4%的mIoU看似及格,但平均指标往往掩盖了关键类别上的脆弱表现——恰恰是这些少数但高风险的错误决定了系统能否安全运行。
提升可靠性:RGB-Depth融合是关键突破口
针对误判问题,最有价值的改进方向是引入已有但未使用的深度信息。ZED 2i本身就能输出稠密深度图,而近距离障碍物被误判为可通行地形这类错误,恰恰是单目RGB最难解决的——因为视觉上墙壁的纹理可能与地面相似,但深度几何关系截然不同。
常见的RGB-D融合策略包括:
- 早期融合:将深度作为额外通道与RGB拼接后输入网络,实现简单但对预训练权重的适配有要求
- 中期融合:在特征层面交叉融合两种模态,典型如双分支编码器结构
- 几何后处理:用深度图做几何约束,对分割结果中违反物理规律的"可通行"区域进行过滤
对于近距离障碍物误判这种高危场景,哪怕只是用深度做简单的后处理校验(比如检测突变的高度梯度),都能显著降低false traversable的发生率,而且几乎不增加训练成本。
降低延迟:从量化到知识蒸馏
要把帧率从20–30 FPS推向40–60 FPS,可以从多个层面入手:
模型压缩与量化
当前已用TensorRT FP16,进一步可以尝试INT8量化。INT8能在Jetson AGX上带来可观的加速,但对精度敏感,需要配合量化感知训练(QAT)或校准数据集来控制精度损失。考虑到项目对误判极其敏感,建议量化后重点评估关键类别的IoU而非仅看整体mIoU。
知识蒸馏
用SegFormer-B2作为教师模型,蒸馏到更轻量的学生网络(如Fast-SCNN或PIDNet-S),有机会在保留大部分精度的同时获得速度提升。这是解决"轻量模型精度不足"问题的经典思路——让小模型学到大模型的软标签知识。
架构选择
PIDNet本身就是为实时语义分割设计的,其三分支结构在精度和速度间做了较好平衡。如果B2的Transformer开销实在难以压缩,不妨考虑SegFormer-B0/B1这类更小的变体,或者直接深耕PIDNet系的实时架构,用更好的训练策略和数据增强去弥补精度差距。
TensorRT是NVIDIA推出的高性能深度学习推理优化库,专为在NVIDIA GPU(包括Jetson系列嵌入式平台)上部署模型而设计。它通过算子融合、内存优化和精度校准等手段大幅降低推理延迟。FP16(半精度浮点)是目前Jetson AGX上最常用的量化级别,相比FP32可获得约1.5–2倍加速且精度损失极小。INT8(8位整数)则能在Tensor Core上进一步翻倍吞吐量,但需要一个代表性校准数据集来统计每层激活值的分布范围,或采用量化感知训练(QAT)在训练阶段就模拟量化误差。知识蒸馏(Knowledge Distillation)最早由Hinton等人于2015年系统化提出,核心思想是让小网络(学生)拟合大网络(教师)输出的软概率分布而非硬标签,从而将大模型隐含的"暗知识"迁移给小模型,在分割任务中通常还会在中间特征层增加模仿损失以提升效果。
训练策略:别只盯着mIoU
随机错误色块和特定物体(横梁、立柱)的误判,往往反映出训练数据的覆盖不足或类别不平衡问题。几个实用建议:
- 针对误判频繁的类别做困难样本挖掘或调整损失权重
- 增强训练集中障碍物(墙、柱、梁)的样本多样性
- 引入时序一致性约束,利用视频帧间的连续性抑制随机闪烁的错误色块
- 评估时增加针对"可通行/不可通行"二分类的安全指标,而不只依赖多类别mIoU
mIoU(mean Intersection over Union,平均交并比)是语义分割最通用的评估指标,计算所有类别IoU的算术平均值。其局限性在于对类别不均衡不敏感——稀有但高危的类别(如近距离障碍物)即便IoU极低,对整体mIoU的拉低效果也有限,容易被高频类别(如大面积草地)的良好表现所掩盖。在安全关键的导航场景中,更有意义的指标包括:针对"可通行/不可通行"二分类的召回率(Recall),尤其是障碍物类别的召回率;以及False Traversable Rate,即被预测为可通行但实际为障碍物的像素比例。时序一致性约束则通常通过视频帧间的光流对齐损失或CRF(条件随机场)后处理来实现,能有效抑制单帧推理中常见的"闪烁"噪声,对提升用户感知质量和下游规划模块的稳定性都有帮助。
写在最后
这个案例是边缘AI工程落地的一个缩影:真正的难点从来不只是跑分,而是在算力、延迟、精度和安全性之间找到可部署的平衡点。对于越野自主导航来说,充分利用已有的双目深度信息、针对高风险误判做专项优化,往往比盲目追求更高的mIoU或帧率更有价值。感兴趣的开发者可以关注SegFormer、PIDNet的开源实现,以及YCOR等越野数据集,在真实硬件上做充分的基准测试。
相关推荐

亚马逊新款Alexa平板来袭:超值价格背后的广告隐忧
亚马逊新款Alexa平板以229至549美元的超值价格冲击安卓平板市场,有望成为默认选择。但低价背后是广告补贴与购物推送的隐忧,本文分析其机遇与潜在陷阱。

ChatGPT移动端上线DOT:随身AI代理如何帮你搞定工作
OpenAI的ChatGPT移动端正式上线DOT主动式AI代理,支持iOS和Android。本文详解DOT的设置流程、个性化配置,以及它如何自主编码、跨Slack协作完成复杂任务。

Claude Code v2.1.296 更新解析:子代理、权限与跨平台修复
Claude Code v2.1.296 版本更新详解:新增子代理 autoCompactWindow 与工作流模型控制,加固 Bash 权限与密钥脱敏,优化 Windows 兼容性,并下调 Sonnet 5.5 缓存读取价格。