Jev:TypeSafe AI首个System 1模型,专为数据分类而生
TypeSafe AI推出专注数据分类的System 1模型Jev,速度快40-200倍、成本低250倍,应像if语句而非LLM来使用。
TypeSafe AI发布的Jev是一个颠覆常规认知的模型:它不生成文本、不写代码,只做数据分类,但在这一垂直场景下实现了惊人的速度(70-500毫秒)和成本优势(输入$0.04/百万token,输出免费)。其设计理念源自卡尼曼的「System 1/System 2」框架——Jev专注快速直觉判断,而非缓慢推理。它的核心价值在于输出格式的绝对可靠性:你定义一个TypeSafe JSON格式,它就严格按该格式输出,结构上几乎不会出错,同时附带置信度信息供开发者做准确率校准。适用场景包括邮件分类、内容审核、越狱识别等所有「10秒内凭直觉就能判断」的任务;而LLM裁判、上下文压缩等需要深度推理的用法则被作者明确反对。正确理解Jev的方式是:把它当成一个新安装的库或一个if语句,而非通用大模型的替代品。
又到了新模型发布的时刻,但这次的主角和我们熟悉的LLM截然不同。它不会写代码、不擅长生成长文本,也不会出现在那些「最强新模型」的评测榜单上——因为它压根不是为那些场景设计的。这个由TypeSafe AI推出、名为 Jev 的模型,只做一件事:数据分类,而且做到了极致。
一个反直觉的模型定位
Jev的核心不是生成文本,而是接收数据、组织并分类,然后以完美的TypeSafe JSON格式返回结果。你给它一个格式规范,它就严格按照这个格式输出,几乎从不出错。这意味着它不是用来替代Fable、Astra这类通用模型的——如果你现在正用那些昂贵的大模型做本可以交给Jev的活,那确实值得反思一下成本结构。
Jev背后的核心概念是「System 1模型」,灵感来自丹尼尔·卡尼曼的《思考,快与慢》。System 1是大脑快速直觉的判断——看一眼就知道「那件衬衫是蓝色的」;System 2则是缓慢、审慎的推理。TypeSafe AI的框架里,Jev负责第一类任务,而推理模型继续负责第二类。模型名字取自「杰文斯悖论」(Jevons Paradox):当蒸汽机效率提升,煤炭消耗反而增加,因为动力变便宜后被用到了更多地方。这正是理解Jev的正确视角——它不解锁全新能力,而是让已有能力快到、便宜到足以大规模落地。
「杰文斯悖论」(Jevons Paradox)由19世纪英国经济学家威廉·斯坦利·杰文斯提出。他在1865年观察到,蒸汽机效率的提升并未减少英国的煤炭总消耗,反而使煤炭用量大幅增加——因为效率提升降低了单位成本,触发了更广泛的应用需求。这一悖论在AI领域的类比同样成立:当推理或分类的成本降低100倍,企业不会做同样多的事情花更少的钱,而是会把AI决策嵌入原本因成本过高而放弃的数百个流程中。Jev这个命名因此暗示了一种规模效应预测:极低的分类成本会催生全新的使用场景,而非仅仅优化现有流程。
谁做的,为什么快
据视频作者介绍,Jev由前OpenAI员工Diogo打造,他参与了ChatGPT和RLHF的研发。尽管RLHF在塑造模型行为上很出色,但对分类任务帮助有限。Diogo的判断是:如果更专注于分类而非通用文本生成,就能换来极致的速度和成本优势。
结果就是这样一组近乎离谱的数据:输入token约 $0.04/百万,对比Fable这类模型的 $10/百万;而输出token完全免费——他们形容为「太便宜以至于不值得计量」。速度上,传统LLM需要3到300多秒才能完成的分类工作,Jev只需 70到500毫秒,也就是快了40到200倍。
为实现这一点,团队从零构建了面向自动化的技术栈:新的模型架构、追求极致效率的并行采样器,以及他们称为「校准决策强化学习」的训练方法。目前首个公开版本处于邀请制早期访问阶段,可通过OpenRouter、Vercel AI Gateway等渠道接入。
RLHF(Reinforcement Learning from Human Feedback,基于人类反馈的强化学习)是让大语言模型对齐人类偏好的核心训练方法:人类标注员对模型输出进行比较和评分,训练一个奖励模型,再用强化学习让生成模型的输出向高分方向优化。RLHF极擅长塑造模型的语气、安全边界和指令遵循风格,但对于「输出结构化JSON分类标签」这类任务,它的训练信号过于模糊——奖励函数很难精确衡量分类的速度与格式合规性。Diogo的判断是,放弃RLHF、转而专门针对分类任务设计「校准决策强化学习」,能换来更极致的速度和结构合规性,代价是彻底放弃通用文本生成能力。
像调用函数一样调用智能
理解Jev的关键,是把它当成「前沿智能的函数调用」:非结构化状态进,类型化的概率决策出。你丢给它一堆杂乱的文本数据,拿回一个类型安全的结构。
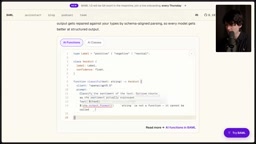
这类需求此前已有不少尝试,比如作者很推崇的BAML。BAML本质是一门「胶水语言」,介于agent和真实代码之间,用类似TypeScript的语法定义输出格式,并在运行时修复模型输出的JSON格式错误。作者曾用GPT-OSS-120b配合BAML筛选提及赞助商的评论,体验很好;一旦脱离BAML才发现,GPT-OSS-120b有近一半概率格式化JSON出错。
Jev的不同之处在于:它根本无法输出错误格式。你给它一个JSON格式,它就返回那个格式。需要澄清的是「确定性」问题——输出的形状是确定的,永远符合你定义的格式;但内容不是确定的,只是相当可靠。这正是结构化输出的价值:LLM本身不具备确定性,而Jev让你能像调用代码一样可靠地调用它。
值得一提的是,Jev在每个输出中都会给出置信度与不确定性,让你能围绕准确率做校准——这解决了传统模型「95%的时候能做对,但不告诉你何时落在那5%」的自动化痛点。
BAML(Boundary Markup Language)是一个开源框架,专门解决「让LLM可靠输出结构化数据」的工程问题。它允许开发者用类TypeScript语法声明期望的输出结构,在调用时自动将结构定义注入prompt,并在运行时对模型返回的JSON做容错修复——例如截断的引号、多余的逗号等常见格式错误。BAML的存在本身就说明了问题的普遍性:即便是GPT-4级别的大模型,在没有专门约束的情况下也有相当概率输出格式不合规的JSON。Jev的架构选择则是从根本上消除这一问题——结构化输出不是事后修复的结果,而是模型推理的直接输出形式,因此理论上不存在格式错误的可能。
能用来做什么,不能用来做什么
凡是需要分类的场景,Jev都适用:按主题整理YouTube视频、判断邮件是否重要及归类、内容安全与审核、识别越狱提示等。作者用它做了不少演示。
最直观的一个例子是他搭的跳棋游戏:Jev接收棋盘状态(数据而非图像,它没有视觉能力),几乎瞬间返回落子决策。速度确实惊人,但——它不太聪明,作者「几乎没认真看就把它打爆了」。这恰恰说明问题:它不用大脑的推理部分,只是处理数据。
其他演示同样亮眼:分类1500封邮件时,平均200毫秒/封、每秒处理38封;对1118个代码对话线程、32311条消息做分类,总成本仅37美分;甚至能在7.1秒内完成订机票,靠读取HTML直接决策网页导航。它还能实时驱动Doom——每秒运行10次,一小时成本不到7美元。
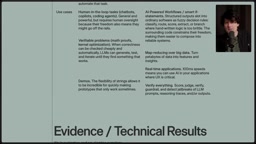
但作者反复强调边界。有人问:能不能用它当裁判,评判四个LLM的输出?作者直接反对——这既昂贵又荒唐:Jev只用「一半大脑」,它不具备区分不同LLM输出优劣所需的推理能力。它的上下文窗口只有 32K token,本质上「和一个switch语句一样聪明」。
那些被夸过头的用法
作者对几个被热炒的用法态度鲜明。Braintrust建议用Jev替代LLM裁判来给agent输出打分——作者认为这是坏主意,写好一个裁判prompt根本不需要多久,用非推理模型做评分只会降低可信度。
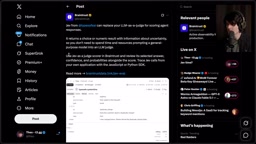
更受争议的是「用Jev做上下文压缩(compaction)」。作者详细论证了为何这行不通:压缩不是过滤,而是基于全部历史合成摘要;Jev既没有工具调用的输出结果,也拿不到模型的推理数据(各家实验室早已不返回reasoning),32K上下文更是远远不够。加之现代模型已在训练中针对压缩做过调优,改动它们看到的历史反而适得其反;缓存失效问题也会让成本不降反升。已有人实测该方案,表现很差。「它唯一的好处,是快到能塞进普通推特用户的注意力时长,所以视频保证会火。」
该怎么看待Jev
作者给出一个简单判断法:当你感知完所有信息后,回答这个问题需要几秒? 如果不到10秒(比如判断衬衫颜色),Jev大概率适合;如果超过10秒需要思考,就不适合。
Jev是一个System 1模型——System 2是你思考一件事,System 1是你的大脑替你反应,类似敲膝盖时腿的反射。它的价值不在于替代Codex、Claude或你终端里的工具,而在于让大量此前不现实的分类、排序、快速决策场景变得又快又便宜。
换句话说,别把它当成生成代码或文本的「推理农场」,而应把它看作一个新安装的库、一个可调用的函数——当成一个if语句来用。抱着正确的心态,这个模型会很好玩。
卡尼曼的双系统理论(Dual Process Theory)将人类思维分为两种模式:System 1快速、自动、无意识,依赖模式匹配和直觉,几乎不消耗认知资源;System 2缓慢、主动、有意识,负责逻辑推理、规划和复杂判断,消耗大量注意力。在AI工程实践中,这一框架提供了一种任务路由的思维方式:把System 1类任务(分类、过滤、快速标注)交给专门的轻量模型,把System 2类任务(代码生成、多步推理、复杂决策)交给推理模型,而非用同一个高成本模型处理所有请求。Jev的出现使这种架构分层在成本和延迟上首次变得实际可行。
相关推荐
Metapunk三大新技能:构建AI软件开发闭环
Metapunk新版本新增Implement Spec、PR和Retro三大技能,补齐AI软件开发闭环。本文解析各技能功能与工作流,帮助提升AI Agent开发效率与代码质量。
6个黑暗中的恐怖故事:TED-Ed用动画讲透人性寓言
TED-Ed 精选六则恐怖故事合集,涵盖《猴爪》、日本阿岩传说、死神教父、贝奥武夫、爱伦·坡《红死魔的面具》与无耳芳一。本文解析这些动画短片如何用跨文化寓言讲述欲望、背叛与死亡的代价,以及它们为何适合作为课堂讨论素材。
Python调用Ollama轻量模型实战指南
从安装Ollama、拉取0.8B轻量模型到用Python跑通调用的完整实操指南,含服务启动、模型名匹配、首次加载延迟等易踩坑细节,单次调用实测0.23秒。