Python调用Ollama轻量模型实战指南
Ollama 用一条安装命令、811MB 小模型和十几行 Python 代码,在本机快速跑通本地大模型调用。
文章基于一段实操演示,梳理了用 Ollama 在本地运行大模型的完整路径:官网安装后先执行 `ollama serve` 启动后台服务,再在另一终端用 `ollama pull` 拉取模型,并建议显式指定 0.8B 小参数版本(体积约 811MB)而非默认的 4B 版本。随后从模型页面复制官方 Python 示例,只需把模型名改成实际拉取的版本,安装 ollama 包即可运行。性能上首次调用因模型加载较慢,之后几乎瞬时,演示中单次耗时 0.23 秒。文章还提醒服务与客户端分离、模型名精确匹配、首次延迟需预热等实践要点。
Ollama 正在把本地大模型的门槛压到极低。不需要 GPU 集群,不需要复杂的推理框架配置,一条安装命令、一次模型拉取、一段十几行的 Python 代码,就能在本机跑起一个能用的对话模型。本文基于一段实操演示视频,梳理从安装到跑通 Python 调用的完整路径,并补充一些视频里没展开的细节。
安装 Ollama:一条命令的事
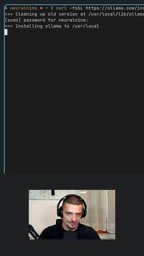
视频演示在 Linux 环境下操作,但流程在各平台大同小异。打开 Ollama 官网点击 logo 进入 get started 页面,会看到对应操作系统的安装命令。Linux 下直接在终端粘贴执行,输入密码后即安装最新版本。据视频演示者说明,其机器上此前已装过 Ollama,所以这一步更多是确认版本更新。
安装完成后需要先启动服务。在第一个终端执行 ollama serve,让后台服务跑起来,后续的模型拉取和 Python 调用都依赖这个服务进程。这一点在视频里被特别强调——很多人卡住不是因为代码写错,而是忘了服务没起。
拉取模型:优先选小参数版本
服务启动后,开第二个终端执行 ollama pull <模型名>。视频里演示者建议从最小的模型入手:他提到某个版本参数量仅 0.8B,而默认拉取的是 4B 版本,因此需要显式指定小模型名称。
小模型的实际体积只有 811MB 左右,据演示者评价「not really big」,意味着几乎任何现代机器都能承载。对于只想验证流程、做原型开发或跑在资源受限设备上的场景,这是更务实的选择。大模型当然能力更强,但第一次跑通链路时,没必要在下载和显存上给自己设障碍。
模型名称中的「0.8B」「4B」指的是参数量(Parameters),即模型中可训练权重的数量,B 代表 Billion(十亿)。参数量直接决定模型的表达能力与资源需求:参数越多,通常理解与生成能力越强,但显存占用、加载时间和推理延迟也越高。以 4-bit 量化为例,每 10 亿参数约占用 0.5–0.7GB 内存,因此 0.8B 模型落在 1GB 以内,4B 模型则需 2–3GB。Ollama 的模型标签(如 llama3.2:1b、llama3.2:3b)就是用来区分同一模型家族的不同规模版本,不写标签时往往默认拉取中等规模版本,这正是文中强调要显式指定小模型的原因。
Python 调用:官方示例直接可用
模型拉取完成后,不需要自己从零写调用代码。Ollama 的模型页面提供了 Python 示例,切到 Python 标签页即可复制。视频中演示者打开了一个预先准备好的 main.py,核心改动只有一处:把模型名改成实际拉取的 0.8B 版本,否则代码会去找默认模型而报错。
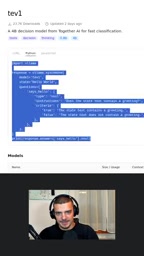
依赖方面需要安装 Ollama 的 Python 包。演示者使用 UV 作为包管理与运行工具,通过 uv run main.py 执行脚本。如果你用传统的 pip + venv,流程等价,先 pip install ollama 再 python main.py 即可。视频没有深入讲包管理选择,这属于个人工具链偏好,不影响最终效果。
Ollama 的 Python 包本质上是一个轻量 HTTP 客户端,它通过本地默认端口 11434 与 ollama serve 启动的服务通信,并不在 Python 进程内直接加载模型。这意味着脚本中 ollama.chat() 或 ollama.generate() 的每次调用,都是一次本地网络请求,模型的生命周期由后台服务管理。理解了这层客户端/服务端架构,就能明白为什么服务没启动时代码会报连接错误,也能解释为什么首次请求慢、后续请求快——模型常驻在服务进程的内存中,而不是随脚本反复加载。
性能表现:首次慢,之后几乎是瞬时
实际运行时的表现值得注意。第一次执行脚本时,命令行里能看到明显的启动等待——模型需要加载进内存。但据演示者观察,后续调用「almost instantaneous」,速度非常快。他用计时的方式给出了一次完整调用的总耗时:0.23 秒。
这个数字说明,对于 0.8B 这个量级的模型,本地推理的延迟已经低到可以支撑交互式应用。当然,0.23 秒是单次简单调用的结果,换成更复杂的提示词或更长的输出,耗时会上升。视频没有测试这些边界情况,属于演示未覆盖的部分。
文中 0.23 秒的耗时需要放在具体语境中理解:它通常指模型已加载后的单次短提示、短输出调用,且很可能运行在 CPU 或集成显卡上。本地推理延迟主要由三部分构成——提示词预处理(prefill)、逐 token 生成(decode)和模型加载。0.8B 模型在普通 CPU 上每秒可生成数十个 token,因此短回答能压到亚秒级;但输出长度一旦增加到数百 token,耗时就会线性上升。此外,首次调用的冷启动可能达到数秒甚至更久,具体取决于模型体积与磁盘速度。评估本地模型是否够用,应关注「每秒 token 数」和「首 token 延迟」两个指标,而非单次总耗时。
几个容易被忽略的实践要点
服务与客户端分离:ollama serve 和 Python 脚本要跑在不同终端,或者确保服务以守护进程方式常驻,否则脚本连不上本地端口。
模型名必须精确匹配:拉取时用了什么名字,代码里就写什么。小参数版本通常需要在名称后加标签区分,写错会触发自动拉取默认模型,白白多下载几个 GB。
首次延迟是常态:如果做延迟敏感的应用,建议在服务启动后先发一次预热请求,把模型加载的代价前置,避免第一个真实用户吃到冷启动。
这套流程的价值在于验证成本极低:811MB 的下载量、十几行代码、0.23 秒的响应,构成了一个可以快速迭代的本地实验环境。跑通之后再换更大模型,只是改一个模型名的区别。
相关推荐
B站唯一讲透Harness Engineering?企业级多Agent协同实战解析
解析Harness Engineering企业级多Agent协同的核心组件:编排层、状态管理、安全隔离与可观测性。结合B站教程素材,讨论面试官为何开始追问工程约束,以及如何理性看待“唯一讲明白”类技术内容。
AI Agent全栈实战课:从0到1掌握双框架开发
B站AI Agent全栈实战课程导学解析:四阶段覆盖基础概念、LangChain精讲、单Agent实战与CrewAI多智能体进阶,含零配置环境工具与开源代码,适合有编程基础的开发者系统入门。
手写Agents.md,让AI编程稳定性大幅提升
B站UP主通过视频编辑器和卡牌游戏两个项目对比,揭示手写Agents.md和设计文档能显著提升AI编程稳定性,解释Agents.md与技能注入机制的区别,并给出文档驱动开发的实用方法。