机器言论的三次变异:从搜索引擎到生成式AI的法律困境
当算法开始「说话」
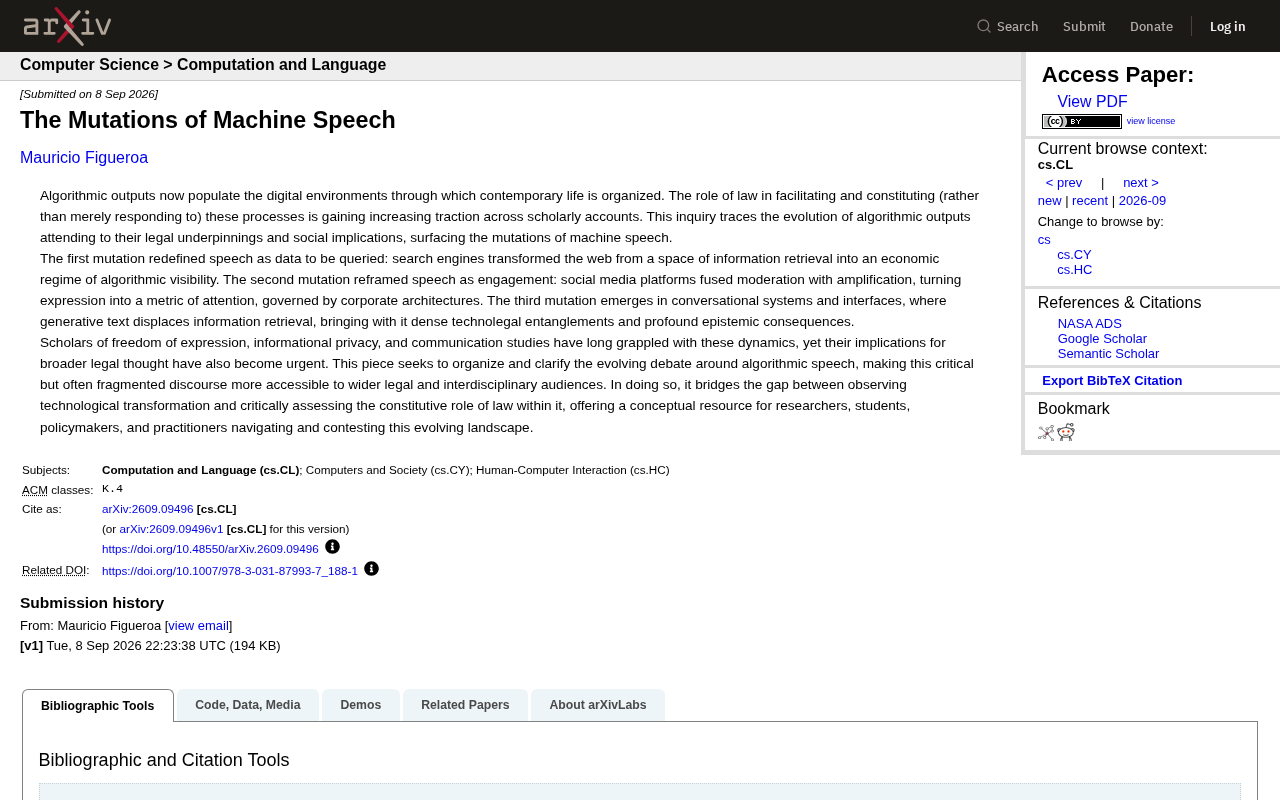
我们的数字生活正被算法输出所包围。从搜索结果到社交媒体动态,再到对话式AI,机器生成的「言论」已经成为组织当代生活的基础设施。一篇发表于arXiv的法律研究论文《The Mutations of Machine Speech》提出了一个发人深省的框架:法律并非仅仅在被动回应技术变革,而是主动地促成并塑造了这些变革。arXiv是由康奈尔大学运营的开放获取预印本平台,涵盖物理学、计算机科学、数学、法学等领域的前沿研究,其开放共享的特性使得跨学科对话成为可能。
论文的核心洞察在于,它追溯了算法输出的演化历程,揭示了「机器言论」在过去数十年间经历的三次根本性变异。每一次变异都伴随着深刻的技术-法律纠缠(technolegal entanglements),以及对社会认知方式的重大冲击。「技术-法律纠缠」这一概念借鉴了科学技术研究(STS)领域的「社会技术纠缠」理论,强调技术系统与法律制度之间并非简单的单向因果关系,而是相互建构、共同演化的复杂网络——技术创造新的法律问题,而法律回应又反过来重塑技术的发展方向。STS领域中,布鲁诺·拉图尔的行动者网络理论(ANT)和希拉·贾萨诺夫的「共同生产」(co-production)框架为这一分析提供了重要的方法论基础,它们主张技术人工物和社会秩序总是在同一过程中被同时建构的。这一视角直接挑战了传统法学中「技术中立」的假设,即法律应当独立于特定技术形态而保持普适性。理解这些变异,对于我们思考言论自由、信息隐私乃至更广泛的法律哲学,都具有紧迫的现实意义。
第一次变异:言论成为可查询的数据
论文指出的第一次变异,发生在搜索引擎兴起的时代。在这一阶段,「言论」被重新定义为可供查询的数据。搜索引擎将互联网从单纯的信息检索空间,转变为一种「算法可见性」的经济体制。
要理解这一转变的技术基础,需要回顾搜索排序技术的演化轨迹。早期搜索引擎依赖简单的关键词匹配,而Google在1998年推出的PageRank算法开创性地利用网页间的链接关系来评估页面权威度——一个被更多高质量页面链接的页面被认为更具可信度。PageRank的核心思想源自学术引用网络——正如一篇被大量引用的论文通常被认为更重要,一个被大量高质量网页链接的页面也被赋予更高权重。这一算法本质上将互联网的超链接结构转化为一个巨大的有向图,通过迭代计算每个节点的特征向量中心性来确定排名。此后,排序算法持续演进:Google在2013年引入Hummingbird算法开始处理语义搜索,2015年的RankBrain首次将机器学习引入核心排序,到2019年的BERT模型则实现了对自然语言上下文的双向理解。如今的排序系统已融合深度学习的语义理解模型,能够解析用户查询的真实意图。这一技术演化的深层含义在于:算法从机械地匹配关键词,进化为「理解」用户意图并主观判断内容相关性,其编辑性质愈发明显。这意味着算法不仅在组织信息,更在定义什么信息「值得被看见」。
这一转变的意义远比表面看起来深远。当信息的价值不再取决于内容本身,而取决于它在算法排序中的位置时,「被看见」就成为一种稀缺资源。谁能出现在搜索结果的第一页,谁就掌握了话语权和商业机会。SEO(Search Engine Optimization,搜索引擎优化)行业的诞生正是这一逻辑的直接产物——人们不再仅仅为人类读者写作,而是同时在为算法「写作」。这一行业在2023年的全球规模已超过800亿美元,其本质是围绕算法可见性展开的资源竞争,深刻地重塑了内容创作的激励结构。值得注意的是,这种「为算法写作」的实践本身就构成了一种新型的技术-法律纠缠:搜索引擎通过算法设定可见性规则,内容生产者调整行为以适应这些规则,而当SEO操纵行为(如链接农场、关键词堆砌)引发法律争议时,又反过来推动了反垃圾邮件法规和不正当竞争法律的演进。
可见性即权力
在这一体制下,法律扮演了关键角色。平台责任的界定、版权规则的适用、搜索结果排序是否受言论自由保护等问题,都在无形中塑造了「算法可见性经济」的边界。
其中最具标志性的法律框架是美国《通信规范法》第230条(Section 230)。该条款规定互联网平台不因用户发布的内容而承担出版者责任,同时赋予平台「善意」内容审核的豁免权。这一1996年通过的法律条款诞生于一个特殊的司法背景:在此之前,1995年的Stratton Oakmont v. Prodigy案判决认为,如果在线服务商对用户内容进行了任何编辑或审核,就可能被视为「出版者」而承担诽谤责任——这一逻辑反而惩罚了那些试图维护内容质量的平台。第230条正是为了纠正这一扭曲的激励结构而诞生的,它被广泛认为是美国互联网产业崛起的法律基础设施。然而,当平台通过算法主动排序和推荐内容时,它已经超越了中立管道的角色,实质上行使着编辑权力,第230条的豁免逻辑是否仍然适用,成为当代法律争论的核心焦点。
与此同时,欧盟在2014年的「被遗忘权」(Right to be Forgotten)判决中首次明确:搜索引擎的排序结果本身构成一种信息处理行为,需要受到数据保护法的约束。这一判决源于西班牙公民Mario Costeja González对Google的诉讼——他要求删除搜索结果中关于其房产被拍卖的过时新闻链接。欧盟法院在Google Spain SL v. AEPD案中裁定,搜索引擎运营商有义务在特定条件下删除指向包含个人信息的网页链接,即使这些网页本身是合法发布的。这一判决的深远意义在于,它确立了信息的「语境完整性」(contextual integrity)原则——即使信息本身是准确的,在不恰当的语境中被持续展示也可能构成对个人权利的侵害。这标志着法律对算法可见性经济的直接介入,也体现了不同法律传统对「机器言论」截然不同的回应方式——美国倾向于将搜索排序视为受第一修正案保护的编辑表达,而欧盟则将其视为需要受数据保护法规制的数据处理行为。法律并非中立的旁观者,而是这一新秩序的共同建构者。
第二次变异:言论成为参与度指标
第二次变异随着社交媒体平台的崛起而到来。在这一阶段,「言论」被重新框定为参与度(engagement)。社交媒体将内容审核与内容放大融为一体,把表达行为转化为衡量注意力的指标,并由企业架构所治理。
参与度作为核心指标的兴起,与注意力经济(attention economy)理论密切相关。诺贝尔经济学奖得主赫伯特·西蒙早在1971年就指出:「信息的丰富意味着注意力的匮乏。」在西蒙之后,迈克尔·戈德海伯在1997年首次系统性地提出注意力将成为新经济的核心货币,达文波特和贝克在2001年的《注意力经济》中将其理论化为企业战略框架。社交媒体平台将这些理论洞察转化为精密的工程实践——Facebook(现Meta)的EdgeRank算法(后演化为更复杂的机器学习排序系统)通过亲密度、权重和时间衰减三个核心变量来决定内容展示;TikTok的推荐引擎则采用了更激进的兴趣图谱模型,基于用户的观看时长、完播率、互动行为等数百个信号实时调整内容分发;Twitter(现X)的时间线算法同样本质上是注意力分配系统。这些系统通过持续的A/B测试不断优化参与度指标,每天进行数十亿次的排序决策,将用户的每一次点击、停留和滑动都转化为可量化的行为数据,每一次决策都隐含着对什么内容「更有价值」的判断。
这是一个微妙但影响深远的变化。在社交媒体的逻辑中,一条言论的「价值」不再取决于它是否真实、是否有益,而取决于它能激发多少点赞、评论和转发。平台算法天然倾向于放大那些引发强烈情绪反应的内容——这恰恰解释了为什么极端化、争议性和情绪化的言论在社交网络上如此容易病毒式传播。学术研究为这一现象提供了量化证据:MIT学者在2018年发表于《Science》的大规模研究发现,虚假新闻在Twitter上的传播速度是真实新闻的六倍,其扩散范围更广、速度更快,而情绪唤起(特别是惊讶和厌恶)是驱动虚假信息传播的关键因素。2021年Facebook前员工Frances Haugen泄露的内部文件(「Facebook Papers」)进一步证实了这一点:公司内部研究早已知晓其算法对青少年心理健康和政治极化的负面影响,但出于商业利益的考量,并未采取充分的纠正措施。
内容审核与算法放大的双重博弈
论文特别强调了「审核」与「放大」的融合。平台一方面通过内容审核政策决定什么可以被说,另一方面又通过推荐算法决定什么能够被广泛看见。这两种权力的结合,使得平台对公共话语的塑造能力达到了前所未有的程度。值得注意的是,内容审核和算法放大在实践中的不对称性:平台的内容审核政策通常是公开的、可被审视的,而推荐算法的具体运作逻辑则高度不透明。这种不透明性意味着,算法放大实际上是一种隐性的、难以问责的权力行使,其对公共话语的影响可能远超显性的内容删除。
更值得警惕的是,这一切都发生在企业架构的治理之下。决定公共言论生态的规则,并非由民主程序制定,而是由私营公司在商业利益驱动下设计。这引出了一个根本性问题:当私营平台实质上承担了公共广场的功能时,传统的言论自由框架是否还适用?
「公共广场」(public forum)概念源自美国宪法第一修正案的判例法传统,指政府不得在传统公共空间(如公园、街道)限制言论自由。这一法律原则建立在国家行为理论(state action doctrine)的基础之上——第一修正案仅约束政府行为,而非私人主体。然而,当公共讨论的主要场所从物理空间迁移到数字平台时,这一传统框架面临根本性的适用困境。宪法学者蒂姆·吴(Tim Wu)将这一困境概括为「私人审查」(private censorship)问题:在一个言论的主要瓶颈不再是政府压制而是平台算法的时代,第一修正案的传统框架是否足以保护言论自由的实质价值?2023年美国最高法院审理的Moody v. NetChoice案和NetChoice v. Paxton案正是这一争论的司法体现——德克萨斯州和佛罗里达州试图立法禁止社交媒体平台基于政治立场进行内容审核,而平台方则主张内容审核本身就是受第一修正案保护的编辑自由。这场法律博弈的结果,将深刻影响第二次变异的最终走向。
第三次变异:生成式AI让检索走向终结
论文认为,我们正在经历第三次变异——它出现在对话式系统和生成式界面中。在这里,生成式文本正在取代信息检索。
当你向ChatGPT或类似系统提问时,它不再像搜索引擎那样返回一系列链接供你自行判断,而是直接生成一个看似权威的答案。这一转变的技术基础是大语言模型(LLM)的突破性进展,特别是2017年Google提出的Transformer架构。该架构通过自注意力机制(self-attention)捕捉文本序列中任意位置之间的依赖关系,使得模型能够在数万亿词元的语料上学习并编码人类语言的深层统计规律。在此基础上,OpenAI的GPT系列、Google的PaLM/Gemini系列、Anthropic的Claude系列等模型通过规模化训练和基于人类反馈的强化学习(RLHF)实现了前所未有的文本生成能力。这一转变带来了论文所称的「密集的技术-法律纠缠」以及「深刻的认识论后果」。
生成式AI引发的认识论危机
生成式AI最深层的挑战在于认识论层面。当机器直接给出答案时,信息来源的透明度大幅下降。用户很难追溯一个答案的依据,也难以判断其中是否包含「幻觉」(hallucination)或偏见。
「幻觉」是大语言模型(LLM)的一个核心技术局限,指模型生成看似合理但实际上不正确或完全虚构的内容。这一问题源于LLM的根本工作原理——它们是基于概率的文本预测系统,通过在海量训练数据中学习到的统计模式来生成下一个最可能的词元(token),而非从结构化知识库中检索经过验证的事实。模型没有对外部世界的真实感知,它的「知识」完全来自训练数据中的统计相关性;当模型面对训练数据稀疏或相互矛盾的领域时,它会基于表面的语言模式「编造」看似合理的内容。2023年的「Mata v. Avianca」案件戏剧性地展示了这一风险:一名律师使用ChatGPT生成法律简报,其中包含多个完全虚构的判例引用,最终面临法庭制裁。检索增强生成(Retrieval-Augmented Generation,RAG)等技术试图通过在生成前从外部知识库中检索相关文档来为模型提供事实基础,从而缓解幻觉问题,但检索质量、上下文窗口限制和模型对检索结果的忠实度等问题仍然制约着其效果,尚未从根本上解决。
搜索引擎时代,用户至少还保留着在多个来源之间比较和批判的能力;而在生成式界面中,这种批判性距离正在被削弱。这一现象与认知科学中的「自动化偏见」(automation bias)密切相关——大量研究表明,人类在面对计算机系统的输出时,倾向于过度信任并减少独立验证,尤其当输出以自然语言的形式呈现、看起来像是来自一个博学的对话者时,这种偏见会进一步加强。
这不仅仅是技术准确性的问题,更关乎我们作为社会如何构建和验证知识。如果越来越多的人将生成式AI的输出视为可信的知识来源,那么对「真实」的判断权就在悄然从人类转移到算法系统手中。哲学家们将这一趋势描述为「认识论权威的转移」——从传统的知识权威机构(大学、新闻媒体、专业组织)转向不透明的技术系统,这对启蒙运动以来建立在个人理性判断基础上的知识论传统构成了根本性挑战。
AI生成内容的法律空白地带
与前两次变异相比,第三次变异引发的法律问题更为棘手。生成式内容的责任归属、AI训练数据与版权的关系、AI输出是否受言论自由保护、错误信息造成损害时谁应负责——这些问题目前大多处于法律的模糊地带。
在版权领域,美国版权局在2023年明确表示,纯粹由AI生成的作品不具备版权资格,因为版权法要求「人类作者」(human authorship)。这一立场在Thaler v. Perlmutter案中得到司法确认,法院驳回了为AI系统DABUS生成的图像申请版权的请求。然而,当人类与AI协作创作时,版权的边界变得模糊——美国版权局在审查Kris Kashtanova的AI辅助漫画《Zarya of the Dawn》时做出了细致的区分:人类选择的文本和整体构图可以获得版权保护,但AI生成的单个图像不行,这一「逐元素审查」的方法预示了未来版权分析的复杂性。在训练数据方面,The New York Times诉OpenAI案、Getty Images诉Stability AI案等里程碑诉讼正在检验「合理使用」(fair use)原则在AI训练场景下的适用边界——如果AI模型在训练过程中大量使用了受版权保护的作品,这究竟是变革性的合理使用还是大规模侵权?合理使用原则的四要素检验(使用目的和性质、原作品性质、使用的数量和实质性、对市场的影响)在AI训练这一前所未有的场景下面临重新解释的需要。在责任归属方面,当AI输出导致损害时(如医疗建议错误、法律信息误导),是由开发者、部署者还是用户承担责任,现行侵权法体系缺乏明确答案。传统产品责任法要求证明产品存在「缺陷」,但对于一个概率性的、非确定性的语言生成系统而言,如何界定「缺陷」本身就是一个悬而未决的法律难题。
欧盟《人工智能法案》(AI Act)于2024年正式生效,采用风险分级的监管框架,将AI系统按照其潜在风险程度分为不可接受风险、高风险、有限风险和最小风险四个等级,代表了目前最系统的立法尝试。不可接受风险类别包括社会信用评分系统、实时远程生物识别(有限例外)和操纵人类行为的AI系统等,被完全禁止;高风险类别涵盖医疗设备、关键基础设施、执法、教育和就业等领域的AI系统,需要满足严格的合规要求;有限风险类别主要针对聊天机器人和深度伪造等系统,核心义务是透明度;该法案还专门对通用人工智能模型(GPAI,如GPT-4)设立了分级透明度和安全义务,具有系统性风险的GPAI模型需要进行红队测试和模型评估。论文呼吁法律学界正视自身在这一进程中的「建构性角色」——法律的每一次回应,都不只是在适应技术,更是在定义技术的社会意义。
这个法律分析框架为何重要
这篇论文最大的价值,在于它为一个高度碎片化的讨论提供了清晰的组织框架。言论自由、信息隐私、传播学等领域的学者长期以来各自探讨这些问题,但它们对更广泛法律思想的影响却常常被忽视。
作者试图弥合「观察技术变革」与「批判性评估法律建构作用」之间的鸿沟。换言之,我们不应把技术演化视为一种自然发生的、法律只能被动应对的力量;恰恰相反,法律的每一次选择——无论是平台豁免条款还是数据保护规则——都在主动塑造着机器言论的形态。这与法律领域中「法律建构主义」(legal constructivism)的传统一脉相承,后者认为法律不仅反映社会现实,更积极地参与社会现实的建构。这一理论传统的知识根源可以追溯到多个学术脉络:在法学内部,它与20世纪初卡尔·卢埃林和杰罗姆·弗兰克等学者开创的法律现实主义运动密切相关,该运动挑战了法律形式主义对法律自治性的假设;在更广泛的社会理论层面,它呼应了彼得·伯格和托马斯·卢克曼的知识社会学框架以及福柯关于法律-权力-知识关系的分析;在技术治理领域,劳伦斯·莱西格的「代码即法律」(code is law)理论进一步强调了技术架构本身就是一种规制力量,与法律、市场和社会规范共同构成四种基本的行为调节机制。这篇论文的贡献在于将这些理论洞察具体化到「机器言论」的演化分析中。
为AI治理提供概念工具
对于研究者、政策制定者和从业者而言,这个「三次变异」的框架提供了一个宝贵的概念资源。它帮助我们理解:我们今天在生成式AI治理上做出的法律和政策选择,将决定第三次变异最终的走向。正如第230条塑造了搜索引擎时代的信息生态,如今围绕AI责任、透明度和版权所做出的制度选择,将在未来数十年间定义人类与机器生成知识之间的关系。
这一框架的实践意义还体现在它为当下激烈的政策辩论提供了历史纵深。当政策制定者面对生成式AI的监管挑战时,回顾前两次变异的经验教训至关重要:第230条最初旨在保护新兴互联网产业,但其长期效果远超立法者预期;「被遗忘权」判决试图平衡信息自由与个人隐私,但在实践中引发了关于「谁来决定什么应被遗忘」的持续争论。这些历史先例提醒我们,今天看似合理的制度选择可能在未来产生深远而难以预见的后果——正因如此,对法律建构性角色的自觉反思,比以往任何时候都更为紧迫。
结语
从「言论即数据」到「言论即参与度」,再到「生成取代检索」,机器言论的三次变异勾勒出一条清晰的演化轨迹。每一次变异都不仅是技术的跃迁,更是权力结构与认知方式的重构。
在生成式AI快速普及的当下,这篇论文提醒我们:真正的问题不在于技术能做什么,而在于我们通过法律和制度选择,允许它成为什么。法律从来不是旁观者,而是这场深刻变革的共同作者。
相关推荐
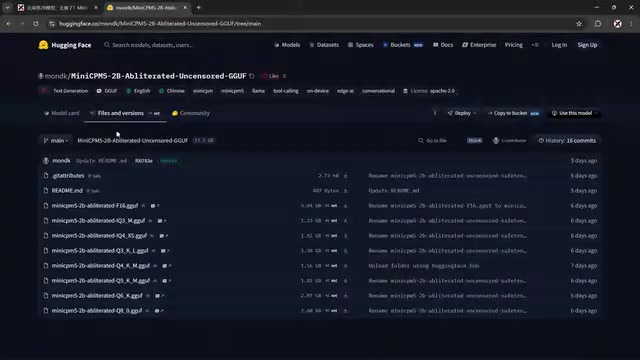
MiniCPM-2B无审查版本地部署教程:接入llama.cpp与Hermes全流程
MiniCPM-2B 本地部署完整教程:涵盖 GGUF 模型下载、llama.cpp 配置、启动脚本编写及接入 Hermes 客户端全流程。支持 131K 上下文,普通电脑即可运行的国产轻量级大模型部署指南。
DeepSeek Harness 解析:智能体内核的三大设计问题
DeepSeek Harness 是什么?本文从三个递进问题拆解智能体 Agent 的内核设计:Harness 工程化、插件化体系原理,以及高可用 Agent 产品的架构落地思路,帮助前端开发者转型 AI 全栈。
Markdown为何是AI世界的母语?Obsidian语法保姆级教程
从Obsidian公开课整理的Markdown保姆级教程:六大类通用语法、Obsidian扩展语法(双链、标签、Callout)实操,并深入解析为什么Markdown凭借结构化纯文本与低冗余特性成为AI世界的母语。