记忆预测增益MPE:量化历史信息对随机过程预测的价值
MPE框架将"历史信息对预测的贡献"精确量化为准确率提升,并给出最小必要记忆长度的理论上界。
arXiv新论文提出**记忆预测增益(MPE)**,针对离散时间有限状态随机过程,将"利用完整历史比仅用静态分布能多预测对多少"这一模糊问题转化为可严格分析的概率量。论文证明MPE始终非负、存在依赖静态准确率的上界,且期望最优预测准确率关于历史长度单调不减——为工程直觉提供了严格支撑。进一步地,论文引入有限历史MPE和**最小记忆长度**概念,并证明对k阶马尔可夫链该长度以马尔可夫阶数为上界,将抽象度量转化为可操作的设计参数。与经典信息论方法(如互信息、超额熵)不同,MPE直接以预测命中率为核心指标,更贴近实际决策需求。当前框架限于离散有限状态场景,连续过程推广及实证估计方法有待后续工作。
一个被忽视的核心问题:历史信息到底有多大用?
预测随机过程时,我们总是本能地假设:掌握的历史越多,预测就越准。但这个"越多越好"的直觉究竟值多少?过去的观测相比于仅依赖静态边际分布,到底能带来多少预测精度的提升?这是一个看似简单却长期缺乏精确量化工具的问题。
一篇新发布的arXiv论文(arXiv:2610.06894v1)提出了名为**记忆预测增益(Memory Prediction Excess,简称MPE)**的概率量,试图从纯概率视角回答这个问题。它针对的是离散时间、有限状态的随机过程,衡量使用完整历史相对于仅使用静态边际分布时,预测准确率的平均提升幅度。
MPE的定义与基本性质
MPE的定义相当直接:它等于"期望最优条件预测准确率"减去"最优静态预测准确率"。换句话说,一个是在掌握全部历史后能达到的最佳预测精度,另一个是只看整体分布(不看任何上下文)时能达到的最佳精度,两者之差就是历史信息带来的"净增益"。
论文梳理了MPE的几条关键性质,构成了这个度量的理论骨架:
非负性与上界
MPE永远是非负的——这符合直觉,因为多一份历史信息至少不会让最优预测变差。更有意思的是它存在一个取决于静态准确率的上界,而这个上界当且仅当"未来几乎必然是过去的确定性函数"时才被取到。也就是说,只有当历史能完全决定下一个状态时,记忆才发挥出理论上的最大价值。
退化情形
论文还刻画了MPE为零的退化情况。当历史对预测毫无帮助时,MPE归零,此时整个过程在预测意义上近乎"无记忆"。这类边界情形的刻画,让MPE不仅是一个数值,更是一个能够诊断过程结构的工具。
归一化版本
为了让不同过程之间可比较,作者引入了一个取值在单位区间[0,1]内的归一化MPE,作为无量纲的"预测效率"度量。这一处理让MPE从绝对量提升为相对量,便于跨场景横向对比。
历史越长,预测越好吗?单调性的证明
论文通过比较不同长度历史的预测表现,推导出一个下界,并证明了一个重要结论:期望最优预测准确率关于历史长度是单调的。
这意味着,从数学上看,更长的历史确实不会损害预测能力,预测精度随历史长度单调不减。这为"信息越多越好"的工程直觉提供了严格的概率论支撑,同时也引出了一个更实际的问题——如果更长的历史总是(弱)更好,那么我们究竟需要保留多长的历史?
有限历史与最小记忆长度
现实系统中,无限保留历史既不现实也无必要。论文因此将框架扩展到有限长度历史,提出了有限历史MPE(FH-MPE),用来衡量仅保留最近若干次观测时所能获得的预测增益。
由此自然引出了一个颇具实用价值的概念——最小记忆长度:为了达到与完整历史相同的预测性能,最少需要保留多长的历史?这个量把抽象的理论度量直接转化为了可操作的设计参数。
马尔可夫链的边界结论
针对有限阶马尔可夫链,论文证明了这个最小记忆长度以马尔可夫阶数为上界。这是一个干净利落的结果:对于k阶马尔可夫过程,你最多只需要记住最近k步,就能获得和记住全部历史一样好的预测效果。这与马尔可夫性质的定义高度自洽,也验证了MPE框架的内在一致性。
k阶马尔可夫链是指当前状态的条件分布仅依赖于最近k个历史状态、与更早历史无关的随机过程。最常见的1阶马尔可夫链(即标准马尔可夫链)满足"给定当前状态,未来与过去独立"这一无记忆性质。k阶推广允许系统在更长的滑动窗口上保持依赖,但依赖窗口仍是有限且固定的。论文关于"最小记忆长度以马尔可夫阶数为上界"的结论之所以重要,是因为它建立了一座桥梁:马尔可夫阶数是过程的结构参数,而最小记忆长度是预测任务的操作参数,两者在这里被精确联系起来。这意味着即使在不知道过程真实阶数的情况下,也可以通过估计MPE在不同历史长度下的收敛行为,反向推断出一个有效的记忆截断点。
与信息论方法的互补关系
值得关注的是MPE的定位。作者明确指出,MPE及其变体是用条件概率和预测准确率来表述的,提供的是一种关于记忆预测效用的概率视角,与经典的信息论方法(如互信息、超额熵等)形成互补。
经典信息论通常以比特为单位衡量"不确定性的减少",而MPE直接盯住"预测对了多少"这一更贴近实际决策的指标。对于关心实际预测命中率而非抽象信息量的应用场景——比如序列预测、状态估计、以及需要权衡记忆成本的在线学习系统——这种以准确率为核心的度量可能更符合直觉,也更易于解释。
经典信息论中,**超额熵(Excess Entropy)**是与MPE最接近的对标概念。超额熵衡量的是"过去所包含的、对预测未来有用的信息量",以比特为单位,定义为过去与未来之间的互信息。**互信息(Mutual Information)**则更广泛地量化两个随机变量之间的统计依赖程度,同样以比特度量。这两类指标的共同特点是刻画"不确定性被消除了多少比特",而非"预测答对了多少次"。这一区别在实践中并非细枝末节:一个系统可能在信息论意义上获益显著(互信息高),但在准确率意义上提升有限——例如当状态空间分布高度不均匀时,最优预测策略几乎总是猜最高频状态,历史信息带来的比特增益未必转化为命中率提升。MPE绕过了这一"翻译损耗",直接在决策者最终关心的指标上做加减法。
意义与局限
MPE的价值在于它把"记忆对预测的贡献"这个模糊问题,转化为一组定义清晰、性质可证的概率量,并给出了最小记忆长度这样的实用结论。对于需要在预测性能和存储/计算成本之间取舍的系统设计者而言,这一框架提供了理论依据。
需要说明的是,论文目前限定在离散时间、有限状态的随机过程范畴内,这既保证了结论的严谨性,也限定了直接适用范围。连续状态、连续时间过程下的推广,以及在真实数据上的估计方法,仍是有待后续工作填补的空白。作为一篇理论性质的新投稿,其实际应用效果还需时间检验。
相关推荐
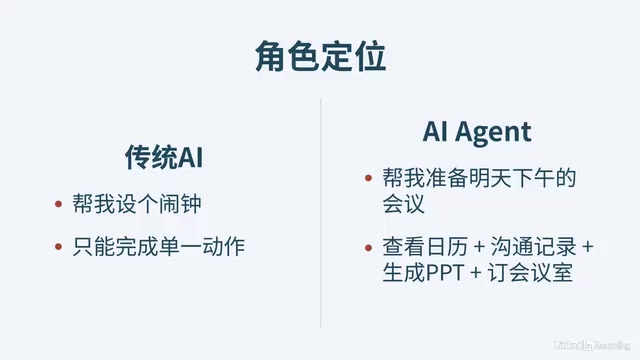
AI Agent快速上手指南:从概念到实战的完整拆解
基于B站《AI Agent快速上手》课程,系统梳理AI Agent的定义、三大核心能力、工作流程、发展简史与五类形态,并剖析理解失败、记忆错乱、工具调用故障与权限越界等真实落地边界,附搭建组件清单与实践建议。

Java+AI工程落地:SpringAI与LangChain4j实战解析
基于B站UP主虚树的Java AI应用教程,解析SpringAI与LangChain4j的技术差异与选型逻辑,涵盖RAG、MCP、模型微调及智能客服、知识库系统实战路径,帮助Java开发者快速切入AI应用开发。

DeepSeek Harness实战:AI工程化编程从入门到企业级落地
基于B站诸葛老师课程,系统梳理Harness AI工程化编程:从提示词工程到智能体的演进、Claude Code结合国产大模型的企业级电商项目实战,以及幻觉、代码不规范、降智等AI编程痛点的应对方法。