揭秘"一元用满血GPT-6"套路:抽卡玩法背后的真相

一段B站视频宣传用"抽卡"方式免费使用GPT-6,实为依赖竞技场平台随机机制配合存在安全风险的第三方软件。
近期B站流传一则视频,声称花一元购买第三方软件即可"无限使用满血GPT-6"。其本质是利用大模型竞技场平台(类似Chatbot Arena)的匿名对战机制,通过反复"抽卡"碰运气获取高性能模型。配套的第三方软件则充当桥接层,让网页端模型获得读写本地文件、控制鼠标键盘的能力,并以此实现让AI自动挑战"羊了个羊"的演示。视频虽展示了AI Agent截图识图、规划消除策略的真实能力,但最终未能通关,作者本人也承认"模型还有很长的路要走"。文章指出三大核心问题:所谓"GPT-6"身份依赖主观经验判断、缺乏官方依据;"免费无限额度"随时可能因平台政策调整失效;第三方软件的本地操控权限存在显著安全风险,却在视频中被完全忽视。
近期一段声称"一元一天、不限次数、无限额度使用满血GPT-6"的视频在B站流传,引发不少关注。视频作者演示了一套通过第三方软件配合大模型排行榜平台来"薅羊毛"的操作,并现场用所谓的GPT-6挑战了热门小游戏"羊了个羊"。这类内容看似诱人,但其技术逻辑和潜在风险值得我们冷静拆解。
所谓"免费GPT-6"的运作原理
视频中的核心思路,是利用一个"大模型排行榜/竞技场"类平台。这类平台的商业模式本身就决定了它对普通用户免费——各家模型厂商为了做宣传、刷榜单,会主动把模型免费提供给平台进行"匿名对战",用户在盲测中投票评价哪个回答更好。
作者正是钻了这个空子:平台的"随机模式"(battle模式)会随机抽取一个匿名模型,其中可能包含被作者称为"Astra""Astra Max"等高强度档位的模型。通过反复"抽卡",再用特定提示词去测试模型的回答风格和能力,就能大致判断当前抽到的是不是所谓的"GPT-6"。
需要强调的是,这套玩法的"免费"建立在平台的公益或宣传属性之上,与真正意义上购买官方API、拥有稳定额度完全是两回事。所谓"一元一天"实际是购买作者的第三方软件,而非模型服务本身。
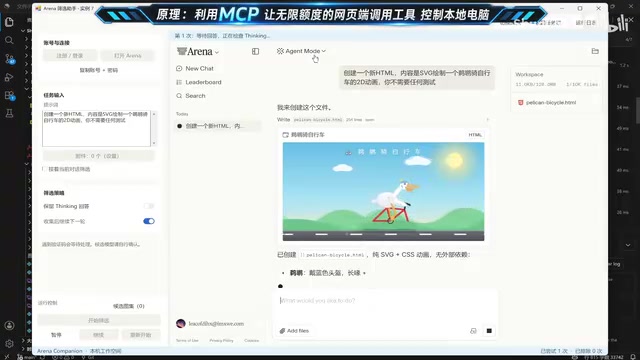
这类"大模型竞技场"平台的代表是UC伯克利团队开发的Chatbot Arena(原LMSYS Arena)。其核心机制是让用户与两个匿名模型同时对话,选出更满意的一方,系统据此用Elo评分体系动态更新各模型的排名。由于排名结果具有独立的学术和商业公信力,OpenAI、Google、Anthropic等主要厂商都愿意免费接入新模型接受"盲测",以获取真实用户的比较性反馈。这正是平台能对普通用户保持免费的根本原因——模型厂商用免费API调用权换取宣传和评测数据,形成了一种互利的商业闭环。用户在这个框架下"薅"到的,本质上是厂商的营销预算,而非平台在做慈善。
"抽卡"过程:随机、不稳定、经验依赖
从演示看,整个"抽卡"体验相当不确定。作者的软件会自动发送提示词、自动重命名对话、自动判断模型强度,但抽到的结果高度随机。视频里就出现了大量"很垃圾很菜"的模型——比如生成的图片里"车轮子都在天上飞",一眼就能看出不是高强度模型。
作者坦言判断模型靠的是"经验",例如某些回答"三天"就一定不是目标模型,会被自动跳过。这意味着:
- 你无法稳定、可控地拿到想要的模型
- 抽卡需要反复尝试,时间成本不低
- 判断标准带有很强的主观和经验色彩
换句话说,即便这套方案能用,它也不是"随时满血",而是"看运气抽"。作者自己在挑战游戏时也承认,当次抽到的"GPT-6并非最高推理档位"。
第三方软件:让网页模型能读写本地文件
视频里的第二个关键软件被作者称为"顺扣"(音译),它的作用是突破排行榜平台的一个天然限制——网页端模型无法读写本地文件。
通过这个软件,作者宣称可以让网页端的GPT、Claude、Gemini(Rena/竞技场内的模型)具备类似Codex的能力:操作电脑、使用终端、读写本地文件、执行Task任务,甚至调用"computer use"能力自动截图、识图、控制鼠标。
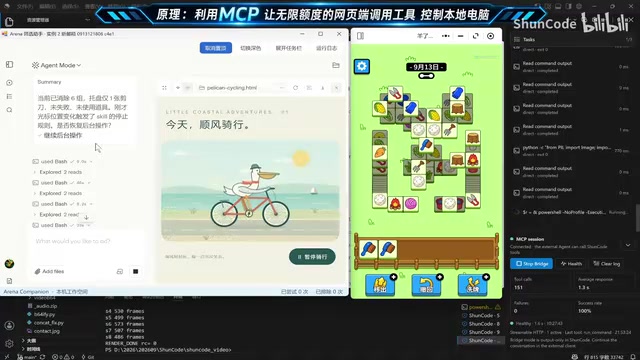
这里存在明显的安全隐患。让一个来源不明的第三方软件桥接网页模型去读写你的本地文件、控制你的鼠标键盘,等于把设备的操作权限交给了未知程序。一旦软件本身存在恶意行为或漏洞,用户的文件和隐私将面临直接风险。这一点视频完全没有提及。
视频中描述的"computer use"能力,指的是让AI模型直接接管计算机鼠标、键盘和屏幕的操作接口,而非仅仅生成文字。Anthropic于2024年率先为Claude推出了这项功能,允许模型通过截图感知屏幕状态,再以像素坐标的形式输出点击或输入指令。这类能力的实现通常需要一个本地的"代理程序"充当桥梁:它负责定时截图并上传给模型API,再将模型返回的操作指令转化为系统级的鼠标键盘事件。正因为该代理程序需要申请截图权限、可访问性权限乃至文件系统权限,其安全性与开发者的信誉直接挂钩。来源不明的第三方实现版本,在技术上完全具备在"帮你玩游戏"的同时窃取屏幕内容、剪贴板数据乃至本地文件的能力。
实测"羊了个羊":AI玩游戏的真实水平
视频后半段的重头戏,是让所谓GPT-6自动挑战"羊了个羊"第二关。这部分反而是最有观察价值的内容,因为它展示了当前视觉+操作类AI Agent的真实能力边界。
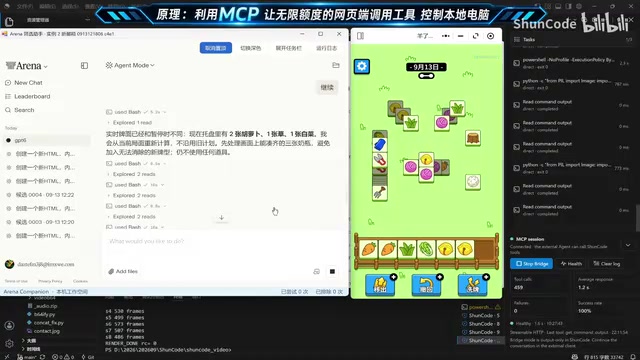
从演示看,模型确实能做到:自动截图、识别牌面、分析层级关系、规划三连消策略、控制鼠标点击,而且不抢占用户鼠标。作者观察到它"看一次点几下、再看一次点几下"的节奏,和人类玩家思路相近,甚至会优先拿走左下角的牌以露出暗牌,被评价为"有智商"。
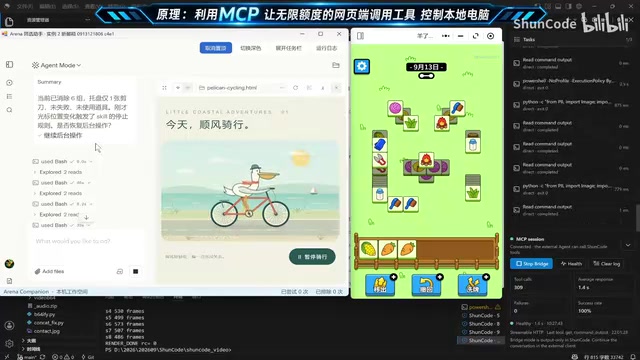
但局限也很明显。模型是"回合式"感知,无法像人类那样实时边看边想;面对左右两侧看不到的暗牌,它同样只能靠运气博弈。最终这一局并未通关——作者归因于两点:一是当次抽到的并非最高推理档位,二是"羊了个羊"本身就带有运气成分。
作者也直言"模型还有很长的路要走",这个判断相对客观。AI Agent在结构化、可观测的任务上进步很快,但在信息不完全、需要长程规划和运气博弈的场景中,仍难以稳定取胜。
"羊了个羊"第二关是一道以超低通关率著称的消除类关卡,核心难点在于大量牌面被上层牌覆盖,玩家必须在信息不完全的条件下规划消除顺序,稍有不慎就会导致槽位占满而无法继续。这种"部分可观测"的博弈环境对AI Agent极具挑战性:模型每次只能从截图中读取当前可见状态,无法像人类一样凭借视觉记忆追踪已翻开的牌,也无法预测暗牌的内容。当前多模态模型在可见信息的识别和短步推理上已相当出色,但面对需要跨多步维护隐藏状态的规划任务时,单次上下文窗口的局限性会被迅速暴露,这也是AI Agent在完全信息游戏(如围棋)上表现优异、在不完全信息游戏上仍明显落后人类高手的根本原因。
冷静看待:噱头大于实用价值
综合来看,这段视频的营销色彩远大于技术价值,几个关键问题需要提醒:
"GPT-6"身份存疑。排行榜平台的匿名模型代号(Astra等)并非官方确认的产品名称,作者靠"经验"判断模型身份,缺乏可验证的依据。将其直接等同于"满血GPT-6"是一种话术。
"免费"是相对的。真正免费的是排行榜平台本身,而作者售卖的是配套软件和抽卡流程。所谓"无限额度"依赖平台的公益属性,随时可能因平台政策调整而失效。
安全风险被刻意淡化。让第三方软件桥接网页模型操控本地电脑,是这套方案里最需要警惕的环节,普通用户很难评估其安全性。
对真正需要稳定生产力工具的用户来说,官方渠道虽然要付费,但换来的是稳定性、合规性和数据安全。而这类"抽卡薅羊毛"的玩法,更适合当作了解AI竞技场平台和AI Agent能力的一个观察窗口,不建议盲目投入或安装来路不明的软件。
相关推荐

AI检测误判风波:作家被指用AI写作,谁该举证?
2026年英联邦短篇小说奖地区获奖者被Pangram检测工具判定100% AI生成,最终靠草稿自证清白。这起事件揭示了AI检测工具的误判风险与创作者面临的举证困境,以及作家协会承认没有可靠AI检测方法的现实。

Paul Ford新作引热议:Web本身已经足够
Paul Ford 文章《The Web Is More Than Enough》在 Hacker News 引发讨论,主张 Web 标准已足够承载应用开发,反对动辄引入封闭平台。本文梳理其核心论点、与当前 AI 应用潮流的张力,以及对开发者技术选型的实际含义。

斯坦福如何教授AI原生工程:CS146S课程揭秘
斯坦福CS146S课程直面AI一键生成作业的挑战,探索AI原生工程教育。Mihail Eric分享如何将AI作为工程伙伴,培养系统设计和代码审查能力,为工程教育提供新范本。