拒绝机制的双重稀疏性:解析Transformer如何构建安全防线

新研究揭示LLM拒绝行为由双层稀疏机制驱动,少数组件与维度即可完整复现安全拒绝效果。
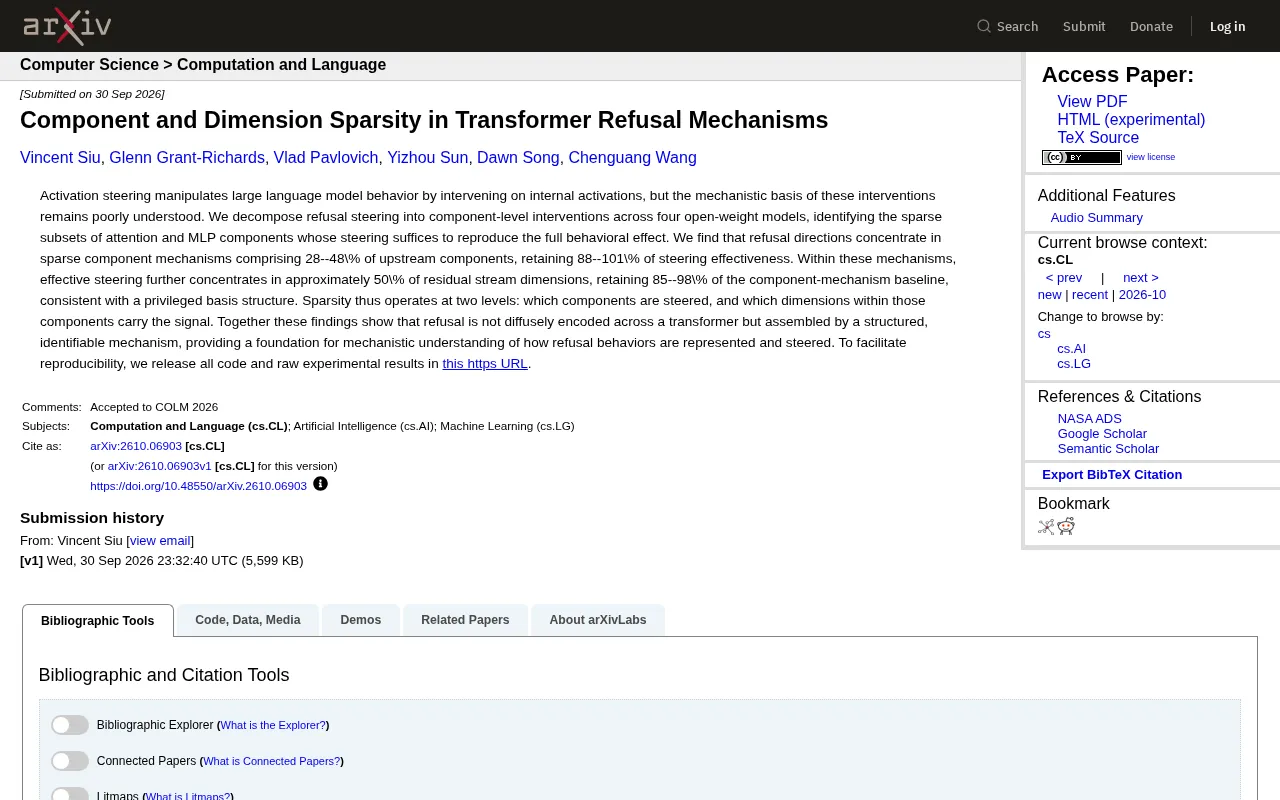
一项基于激活引导技术的新研究(arXiv:2610.06903)系统拆解了大语言模型的拒绝机制,发现其并非弥散编码于整个网络,而是高度集中在少数结构化组件上。实验在四个开源模型上表明,仅28%–48%的上游组件即可保留88%–101%的完整拒绝引导效果;在这些有效组件内部,又只有约50%的残差流维度承载了85%–98%的信号,与"特权基结构"假说高度吻合。这种组件与维度双层稀疏性,意味着模型的安全防线具有可精确定位的物理基础,为机制可解释性研究、越狱漏洞分析以及精细化安全干预提供了明确切入点。研究团队已公开全部代码与实验数据以保障可复现性。
大语言模型的"拒绝"行为——即模型识别到有害请求后拒绝回答——长期被视为一个难以拆解的黑箱。一项发表于arXiv的新研究(arXiv:2610.06903)通过激活引导(Activation Steering)技术,将拒绝机制分解到组件层级,揭示了一个关键事实:拒绝并非弥散式地编码在整个Transformer网络中,而是由一套结构化、可识别的稀疏机制组装而成。
激活引导与拒绝机制的研究背景
激活引导是一种通过干预模型内部激活值来操控大语言模型行为的技术。研究者可以在模型的残差流(residual stream)中注入特定方向的向量,从而增强或抑制某种行为倾向。拒绝行为就是其中最受关注的研究对象之一——它直接关系到模型的安全对齐效果。
然而,尽管这类干预在实践中有效,其背后的机制基础一直模糊不清。我们知道可以"引导"模型拒绝某个请求,却不清楚这种引导究竟作用在网络的哪些部分,又是如何实现的。这项研究正是要回答:拒绝信号到底藏在模型的哪里?
残差流(residual stream)是Transformer架构的核心信息通道。在标准Transformer中,每一层的注意力头和MLP模块都以"读取-处理-写回"的方式与残差流交互:它们从残差流中读取信息,完成计算后将结果加回同一向量。这种加法式累积结构使得残差流成为贯穿整个网络的全局信息总线,每个位置的残差流向量在经过逐层叠加后,最终决定模型的输出分布。正因如此,激活引导技术选择在残差流中注入外部向量——这相当于在信息汇聚的主干道上施加干预,影响力会随层传播并被后续组件放大。理解残差流的这一架构角色,是理解本研究为何能通过"方向注入"来精确操控拒绝行为的关键前提。
组件层级的稀疏性:少数部件承担全部效果
研究团队在四个开源权重模型上,将拒绝引导分解为组件层级的干预,逐一考察注意力(attention)组件和MLP组件的作用。核心发现是:拒绝方向高度集中在一小部分组件上。
具体数据显示,仅占上游组件28%–48%的稀疏子集,就能保留88%–101%的完整引导效果。换言之,即便只对不到一半的组件进行干预,也几乎能完整复现模型的拒绝行为。这意味着大量组件对拒绝机制几乎没有贡献,真正"扣动扳机"的是一个远比想象中更精简的子集。
这一结论对理解模型行为具有直接意义:如果拒绝依赖的组件是稀疏且可定位的,那么针对安全性的分析和干预就有了明确的切入点,而不必在整个网络中漫无目的地搜索。
维度层级的稀疏性:特权基结构的证据
研究的第二层发现更为精细。在上述有效的组件机制内部,引导效果进一步集中在残差流的约50%维度上,这部分维度保留了85%–98%的组件机制基线效果。
这意味着稀疏性在两个层级同时存在:第一层是"哪些组件被引导",第二层是"这些组件内部的哪些维度承载了信号"。研究者认为,这种现象与"特权基结构"(privileged basis structure)相一致——即残差流中某些特定维度在表征拒绝信号时扮演了优先角色,而非信息均匀分布在所有维度上。
这一观察呼应了可解释性研究中长期讨论的议题:神经网络的内部表征是否存在天然的、可对齐的坐标轴。拒绝机制的双重稀疏性为这一假说提供了具体的实证支持。
特权基(privileged basis)这一概念来自神经网络可解释性研究,尤其与Anthropic团队的工作密切相关。在一般情况下,神经网络的内部表征被认为是"旋转不变"的——也就是说,信息可以以任意旋转后的坐标系等价地表达,不存在哪个方向天然更"特殊"。然而,某些网络结构(如带有ReLU激活的MLP层,或经过特定训练过程的模型)会打破这种旋转对称性,使得标准坐标轴方向(即独热方向)对应着可解释的特征,称为"特权基"。本研究发现拒绝信号集中在约50%的固定残差流维度上,正是特权基存在的典型表现:信号不是均匀弥散在所有方向,而是优先编码在某些坐标轴上,这使得直接按维度分析成为可行的研究路径。
对机制可解释性研究的意义
这项工作的价值在于,它把一个抽象的安全行为落实为可定位、可量化的具体结构。过去人们倾向于认为复杂行为在深度网络中是"分布式"编码的,难以精确解析;而本研究表明,至少拒绝这一行为是由结构化、可识别的机制组装而成的。
这为机制可解释性(mechanistic interpretability)提供了坚实的立足点。一旦能够精确定位拒绝信号所在的组件与维度,研究者就能更有针对性地研究模型的安全对齐、潜在的越狱漏洞,以及如何在不损害模型整体能力的前提下调整其安全边界。
为了保证可复现性,研究团队公开了全部代码与原始实验结果,相关资源托管于GitHub(wang-research-lab/Refusal_Mechanisms),便于后续研究者在此基础上验证与拓展。
机制可解释性(mechanistic interpretability)是可解释性研究的一个子领域,其目标是将神经网络的行为逆向工程为具体的、可理解的算法或电路。与关注输入输出关系的行为可解释性不同,机制可解释性试图深入网络内部,识别出"哪些神经元/注意力头/权重矩阵在执行什么计算"。代表性工作包括对GPT-2中间接目标机制(IOI task)的完整电路还原,以及对算术运算中模运算电路的发现。拒绝机制的研究延续了这一思路:一旦能将安全行为落实到具体组件与维度,就可以进一步追问这些组件在执行什么内部算法,以及对抗性越狱攻击究竟是在哪个环节绕过了这套机制。
结语
从四个开源模型的系统分析看,拒绝机制呈现出清晰的双层稀疏特征:少数组件足以驱动完整行为,而这些组件内部又只有约一半维度真正承载信号。这一发现不仅深化了我们对大语言模型安全行为内部构造的理解,也为未来精细化的安全干预与可解释性研究铺设了方法论基础。当模型的安全防线不再是黑箱,针对性的加固与审查才真正成为可能。
相关推荐

神经网络本质是线性回归?华为300集AI课讲师用TensorFlow Playground讲透深度学习
华为300集AI深度学习教程中,讲师用TensorFlow Playground演示神经网络本质是线性回归,讲透机器学习与深度学习在特征工程上的核心差异,以及2012年大数据时代为何成为深度学习崛起的分水岭。

WorkBuddy做AI漫剧全流程:8步从零到成片
基于B站教程梳理WorkBuddy制作AI漫剧的完整八步流程:从选题策划、剧本分镜到图片资产、视频生成、配音剪辑与导出发布,并解析WorkBuddy的专家技能机制与逐个召唤专家的实操技巧,适合零基础入门。

Codex实战教程:从安装到多智能体协同
基于B站Codex实战教程,系统梳理Codex从安装配置、CLI交互、斜杠指令、AGENTS.md架构到MCP协议、多智能体协同与企业级插件开发的完整路径,帮助开发者理解AI Agent的工程化用法。