开源模型安全能力遭裁剪:Kimi与腾讯新模型引担忧

社区指Kimi K3.1与腾讯Hy4移除安全相关能力,引发开源模型安全价值担忧。
Reddit 社区帖子指出,新发布的开源模型 Kimi K3.1 和腾讯 Hy4 疑似移除了网络安全、逆向工程和漏洞修补相关能力,发帖者认为这正在成为中国开源权重模型中的一种不良模式。文章分析了这一担忧的合理性:开源模型的核心价值在于可审计性与本地部署,安全团队依赖其检查后门、审计漏洞和逆向分析;若能力被弱化,研究者可能被迫转向闭源 API,并承受误报关停带来的风险。文章同时指出,该观察目前仅来自单一社区来源,未经官方确认,能力“裁剪”也可能源于安全对齐或训练数据变化。核心结论是:无论成因如何,开源模型安全能力退化值得持续关注,提供方应保持透明。
开源模型正在失去“安全”能力?
最近,Reddit 上的一篇帖子引发了安全社区的关注。发帖者指出,Kimi K3.1 和腾讯的 Hy4 这两个新发布的开源模型,都在从模型中“剔除”网络安全、逆向工程和漏洞修补相关的能力。发帖者认为,这正在成为近期中国开源权重模型中的一个糟糕模式。
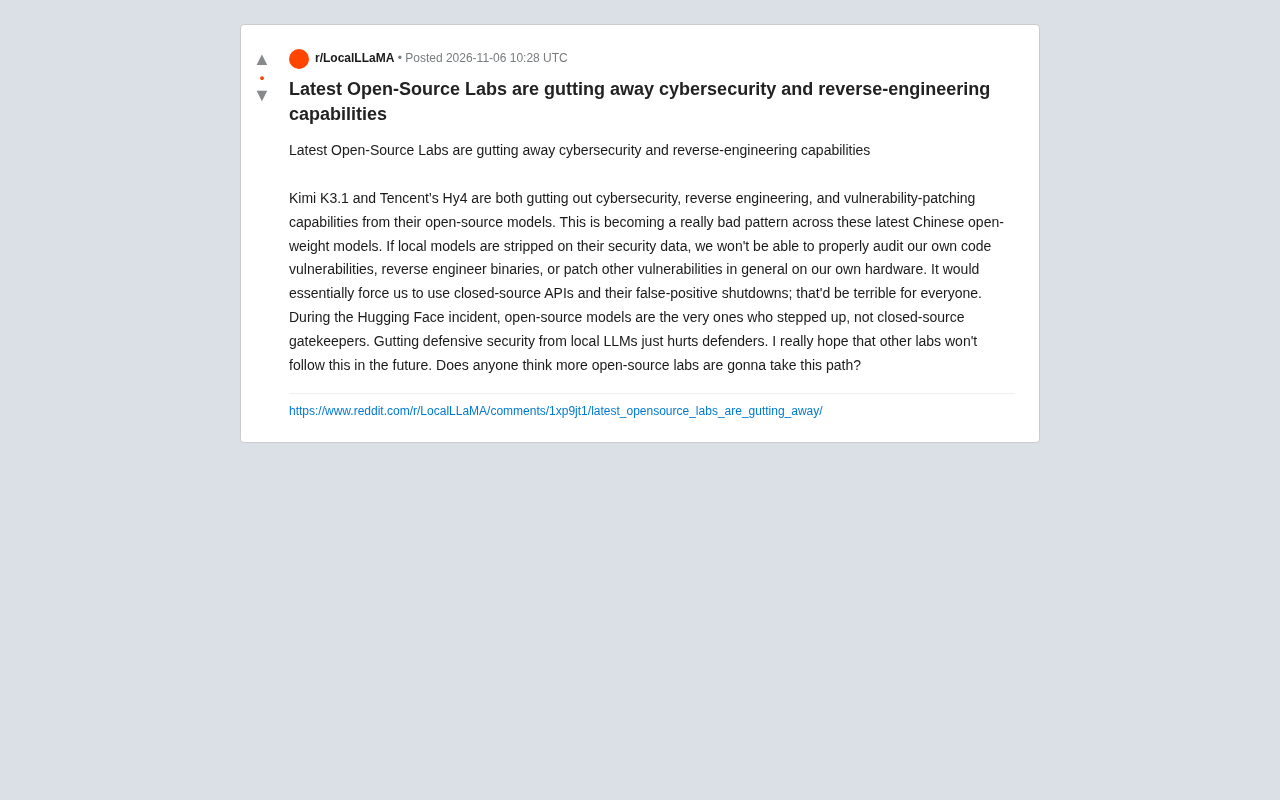
如果本地模型的安全数据被剥离,开发者和安全研究人员将难以在自有硬件上审计代码漏洞、逆向分析二进制文件,或修补其他漏洞。这可能会迫使他们转向闭源 API,而闭源 API 的误报关停机制对所有人来说都是糟糕的体验。
为什么这件事值得警惕?
开源模型在安全领域的价值,恰恰在于其可审计性和本地部署能力。安全团队需要能够检查模型的训练数据、推理逻辑和输出行为,以确认其没有隐藏的后门或偏见。当模型在安全相关任务上被有意弱化时,这种信任基础就被动摇了。
发帖者特别提到了 Hugging Face 事件。在那次事件中,正是开源模型站了出来,而不是闭源的“守门人”。这暗示了一个关键点:在应对安全事件时,开源社区的快速响应和透明性往往比商业闭源方案更可靠。削弱本地模型的安全能力,最终伤害的是防御者。
开源权重模型(Open-weight Model) 指的是模型参数(权重)被公开发布、允许下载和本地运行的模型,区别于仅提供 API 访问的闭源模型。开源权重并不等同于完全开源——训练数据、训练代码和数据处理流程往往并不公开,因此“可审计性”实际上是有层级差异的:研究者可以检查权重、复现推理行为、做红队测试,但未必能追溯训练数据的构成。这也意味着,当模型在某些能力上被“裁剪”时,外部很难区分这是训练数据配比变化、后训练阶段的安全对齐(如拒绝回答某些类别的请求),还是有意在数据管线中剔除了特定领域语料。对于安全研究而言,权重可见但仍存在“黑箱”环节,这正是社区对能力退化保持敏感的原因。
社区的担忧与分歧
发帖者提出了一个开放性问题:是否会有更多开源实验室走上这条路?从帖子语气看,他对此感到悲观,并希望其他实验室不要效仿。
提一嘴,目前这一观察主要来自单一社区来源,尚未得到官方确认。模型能力被“裁剪”可能是出于安全对齐的考虑,也可能是训练数据或评估基准的变化所致。但无论原因如何,社区对开源模型安全能力退化的担忧是真实存在的。
安全对齐(Safety Alignment) 通常指通过监督微调、RLHF 或规则化拒答等方式,让模型在涉及攻击性网络安全操作(如漏洞利用编写、恶意软件分析辅助)时表现出谨慎或拒绝行为。这类对齐本意是防止模型被滥用,但其边界很难精确划定:漏洞修补、逆向工程、恶意软件取证等防御性工作与攻击性操作在技术上高度重叠,粗粒度的拒答策略很容易把正当的安全研究需求一并挡在门外。因此“能力被剔除”与“安全对齐收紧”在表象上往往难以区分,需要通过对具体任务的评测(如 CTF 类题目、补丁生成、二进制分析)来判断模型究竟是能力缺失还是拒答触发。
对开发者的影响
对于依赖本地模型进行安全工作的开发者来说,这一趋势意味着需要更仔细地评估新模型在安全任务上的表现。如果主流开源模型持续弱化相关能力,安全团队可能被迫在“使用能力受限的本地模型”和“依赖可能误报的闭源 API”之间做出选择。
发帖者强调,这“对所有人都是糟糕的”。安全防御不应成为模型能力竞争的牺牲品。开源社区需要持续关注这一趋势,并推动模型提供方在安全能力上保持透明。
误报关停(False-positive shutdown) 指的是闭源 API 提供方基于内容审核策略,对疑似违规的请求直接拒绝或封禁账号,而审核判断本身可能出错。对安全研究者而言,这类机制带来的问题不只是单次请求失败:账号被封可能导致正在进行的分析工作中断,且申诉流程通常不透明、周期长。相比之下,本地部署的开源权重模型不存在服务端审核与远程关停的问题,研究者可以完全控制调用方式与数据流向,这也是安全团队偏好本地模型的重要现实原因之一。
相关推荐

Anthropic Fable 5.2实测:一句话生成3A游戏与Excel克隆
Anthropic Fable 5.2实测:三行提示词生成可玩《战争机器》克隆、完整Excel和DaVinci Resolve克隆,解析基准测试、Ultra Code模式、token成本与定价策略,评估它是否值得替代Opus 5.5。

赛博寻书:BT社区如何「劫走」塞林格遗作
塞林格未发表的《The Ocean Full of Bowling Balls》仅存于大学图书馆且禁止复制。一个私密BT tracker悬赏六TB上传积分,社区从背诵接力到eBay买书扫描,最终成功让文本流出,却因传播过快被管理员删种。本文复盘这场赛博寻书行动及其讽刺结局。

弹劾防长赫格塞斯?五角大楼战争与中期选举风暴
五角大楼气氛紧张,伊朗战事持续八个月仍无退出方案。评论分析赫格塞斯弹劾动议的真实动机:不是罢免,而是留下政治记录,并剖析战争如何通过油价与生活成本影响中期选举选情。