开源QA Agent实测:用测试工作流终结AI幻觉与测试瓶颈
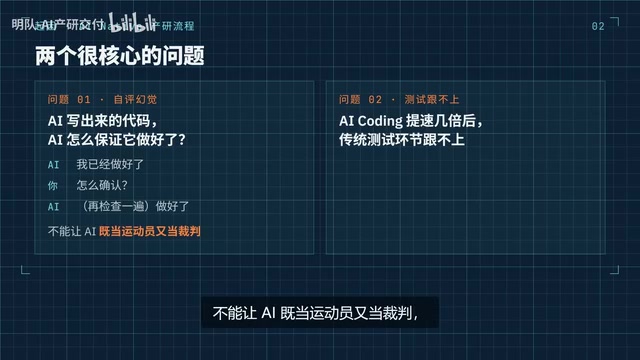
开源QA Agent用独立流水线对抗AI自评幻觉,让测试跟上AI Coding的开发提速。
AI辅助编程大幅提升开发速度的同时,带来了两个新矛盾:AI自评容易产生幻觉、测试排期无法同比压缩。B站UP主明队开源的QA Agent针对这两个痛点,构建了一条由8个Skill组成的端到端自动化测试流水线,覆盖从上下文收集到报告输出的7个阶段。其核心设计是以「第三人称」独立身份从代码事实出发,用可验证的断言替代AI的主观自评,从而在机制层面隔断自评幻觉。实测中,Agent能发现事务回滚时经验值误发等人工用例难以覆盖的隐蔽风险。用例库持续沉淀后,回归测试只需一句话触发,呈现出「第一次是成本,第二次是收益」的复利效应。该工具适用于长期迭代的企业级项目,已开源且一行命令可安装。
AI Coding的两个核心矛盾
随着AI辅助编程渗透到企业研发流程,一个尴尬的问题浮出水面:AI写出的代码,谁来保证它真的做对了?B站UP主明队最近开源了一套内部打磨已久的QA Agent,正是针对这个痛点而来。
第一个矛盾在于AI的自评幻觉。明队指出,AI Coding最常见的场景是——AI写完代码告诉你「我已经做好了」,你追问「确定吗」,让它再检查一遍,它依然回答「做好了」。问题在于,不能让AI既当运动员又当裁判,自我评估天然容易产生幻觉,缺乏独立的事实校验。
第二个矛盾是测试环节跟不上开发提速。传统开发流程中,开发与测试的排期比大约是2:1,前后端开发10天,测试5天。但AI Coding把开发效率提升了3到10倍,开发排期可以压到3天,测试排期却没法同比压缩,依然要5天左右。结果是测试反而成了新的瓶颈。
AI自评幻觉在技术上源于大语言模型的自回归生成机制——模型在生成「代码已完成」这一结论时,依赖的是对自身输出的语义连贯性判断,而非实际运行验证。这与人类开发者主观自信的心理偏差类似,但在LLM中更为系统性:模型倾向于维持上下文的一致性,对已生成的内容赋予较高置信度,即使其中存在逻辑错误或边界遗漏。解决这一问题的工程思路是关注点分离(Separation of Concerns)——生成代码的模型与验证代码的机制必须相互独立,不能共用同一个推理上下文,否则验证结果会被生成过程的「锚定效应」所污染。QA Agent采用独立Agent介入的设计,本质上正是把这条工程原则落实到AI研发流程中。
8个Skill组成的端到端流水线
QA Agent的设计思路是把测试做成一条完整的自动化工作流。据明队介绍,它由8个Skill组成,覆盖7个专职阶段:上下文收集、风险分析、用例设计、脚本生成、执行修复、代码审查、报告输出。从读代码到出结果,整条流水线全自动串联,中间人只需要填一次配置、确认一次用例。
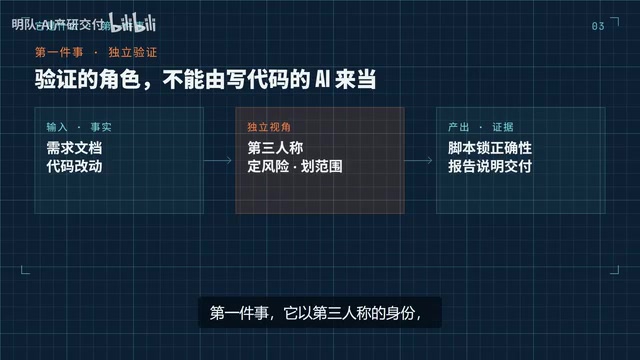
它的核心方法论是以第三人称身份介入。QA Agent不听AI开发者的一面之词,而是从需求文档和代码改动的事实出发,直接确定业务风险、划定测试范围,最终由人来决策。正确性靠自动化测试脚本锁定,交付情况靠自动化测试报告的事实证据来说明。
用明队的话说,结论不是「我觉得没问题」,而是每条结论都要对应一条断言——真的覆盖到还是没覆盖到,流程才放行。这种把主观判断转化为客观断言的机制,正是对抗AI幻觉的关键设计。
「端到端流水线」在这里指的是有向无环图(DAG)式的自动化工作流:每个Skill是一个独立的执行节点,上游节点的输出作为下游节点的输入,整条链路无需人工中转。这种架构在LLM应用中通常借助工作流编排框架(如LangGraph、Dify、AutoGen等)实现,每个节点可以是一次LLM调用、一段工具调用或一个代码执行沙箱。「第三人称身份介入」的实现方式是:Agent的系统提示(System Prompt)明确要求其以独立审查者而非协作者的角色处理输入,输入来源是代码差异(diff)和需求文档,而非对话历史——这从数据层面切断了与开发侧AI的上下文共享,从而保证判断独立性。
实测能发现人工用例想不到的风险
工作流的价值在实测中得到验证。明队提到,QA Agent一开始就帮团队发现了核心流程的风险,比如程序事务回滚时,经验值会不会被错误发放——这类边界场景,人工写测试用例时根本不会想到。
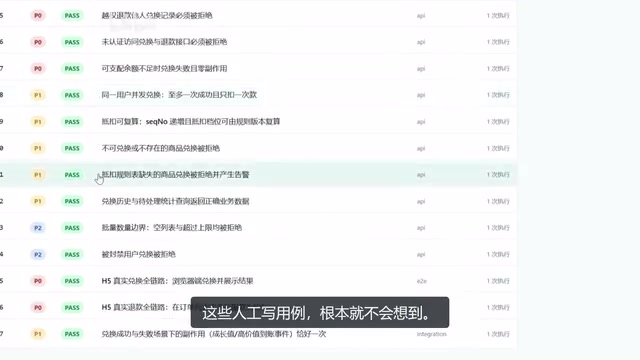
这说明自动化测试Agent的意义不只是「快」,更在于系统性地扫描风险面。人工测试受限于经验和精力,容易遗漏事务、并发、异常回滚这类隐蔽路径,而Agent基于代码事实做风险分析,覆盖面往往更全。
用例库沉淀:第一次是成本,第二次是收益
QA Agent另一个值得关注的设计是持续沉淀。它会把历史测试用例保存下来,逐渐积累成一个长期用例库,成为团队的核心资产。
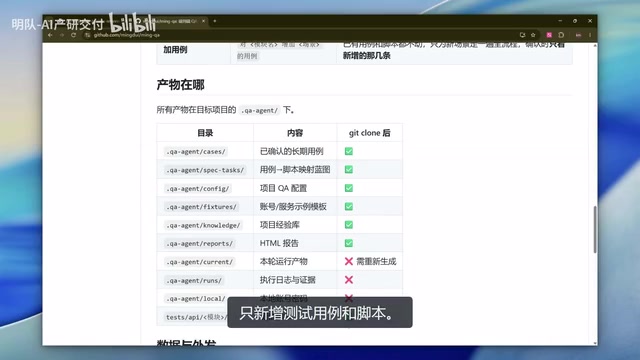
回归测试因此变得极其轻量:下个版本要回归,在Agent里说一句「回归」就行,只跑已有脚本,无需重新生成。同时支持新增测试场景——已有用例和脚本不动,只增量补充新的用例和脚本。
明队总结得很直接:第一次用是成本,第二次用就是收益。这也点明了这套工具的适用边界——它面向的是需要长期维护、持续迭代的企业级项目。整条工作流中,人只在两个地方动手:开头填一次配置,中间确认一次用例,确认完就自己往下跑,跑完看结果即可。它把重复劳动从人手里拿走,但质量的最终判断仍由专人负责。
这里的「用例库沉淀」对应软件工程中的回归测试套件(Regression Test Suite)概念。传统回归测试的痛点在于,测试脚本的维护成本随版本迭代线性增长,人工编写的脚本在需求变更后往往大量失效,导致维护负担超过收益。QA Agent通过增量补充而非全量重写的方式管理脚本库——已通过验证的历史用例保持稳定,新场景只追加不覆盖,这与版本控制系统管理代码的逻辑类似。从成本结构看,LLM生成测试脚本的边际成本远低于人工编写,使得「第一次建库」的前期投入可以在数轮迭代内收回。这种设计使测试资产真正具备复利效应,越用越轻,而非越用越重。
适用边界与开源信息
明队特别提醒:如果是demo项目或一次性脚本,这套流程的开销反而会大于收益。原因不难理解——搭建工作流、生成用例库本身有前期成本,只有在反复回归、长期迭代的场景下才能摊薄成本、放大收益。
目前这套QA Agent已经开源,安装只需一行命令。对于正在推进AI Native研发流程、又被测试瓶颈困扰的团队来说,这提供了一个把测试环节自动化、事实化的可行样本。
从更宏观的视角看,当AI Coding大幅提速开发后,「谁来验证AI的产出」正在成为工程效能的新命题。QA Agent这类工具的思路——用独立Agent做事实校验、用断言替代主观判断、用用例库沉淀资产——很可能是AI Native研发流程走向成熟的必经之路。
相关推荐
Agent如何记住三年前的对话?拆解长期记忆架构五大核心
大模型本身没有长期记忆,Agent 如何记住用户三年前的对话?本文拆解 Agent 长期记忆架构,涵盖记忆分类、存储策略、检索逻辑、上下文压缩与遗忘机制五大核心,剖析工程落地难点与冲突检测方案。
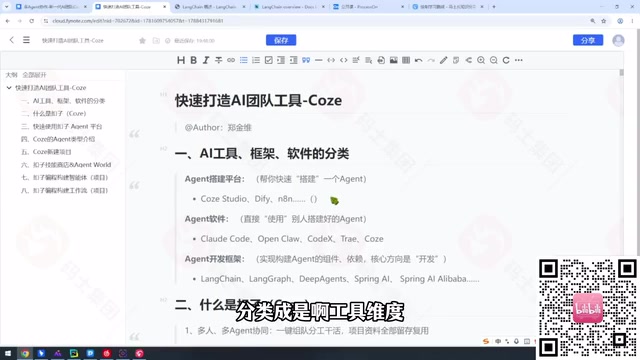
Coze扣子入门:AI Agent工具、软件与框架三大分类全解析
以Coze扣子为切入点,系统解析AI Agent生态的三大分类:搭建工具(Coze、Dify、n8n)、Agent软件(Claude Code、Cursor、Codex)与开发框架(LangChain、LangGraph)。附带编程人员的学习优先级建议。
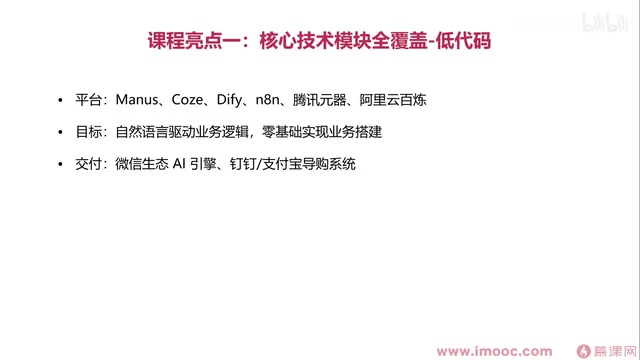
AI Agent实战全攻略:从低代码到硬核框架的企业落地路径
B站AI Agent零基础全套教程深度解析:覆盖LangChain、Coze、Manus、Dify、n8n与MCP协议,采用低代码与代码框架双线并行,扎根九大企业岗位,配四大实战项目,助你从AI使用者进阶为Agent开发者。