可视化理解Transformer:拆解大模型背后的核心架构
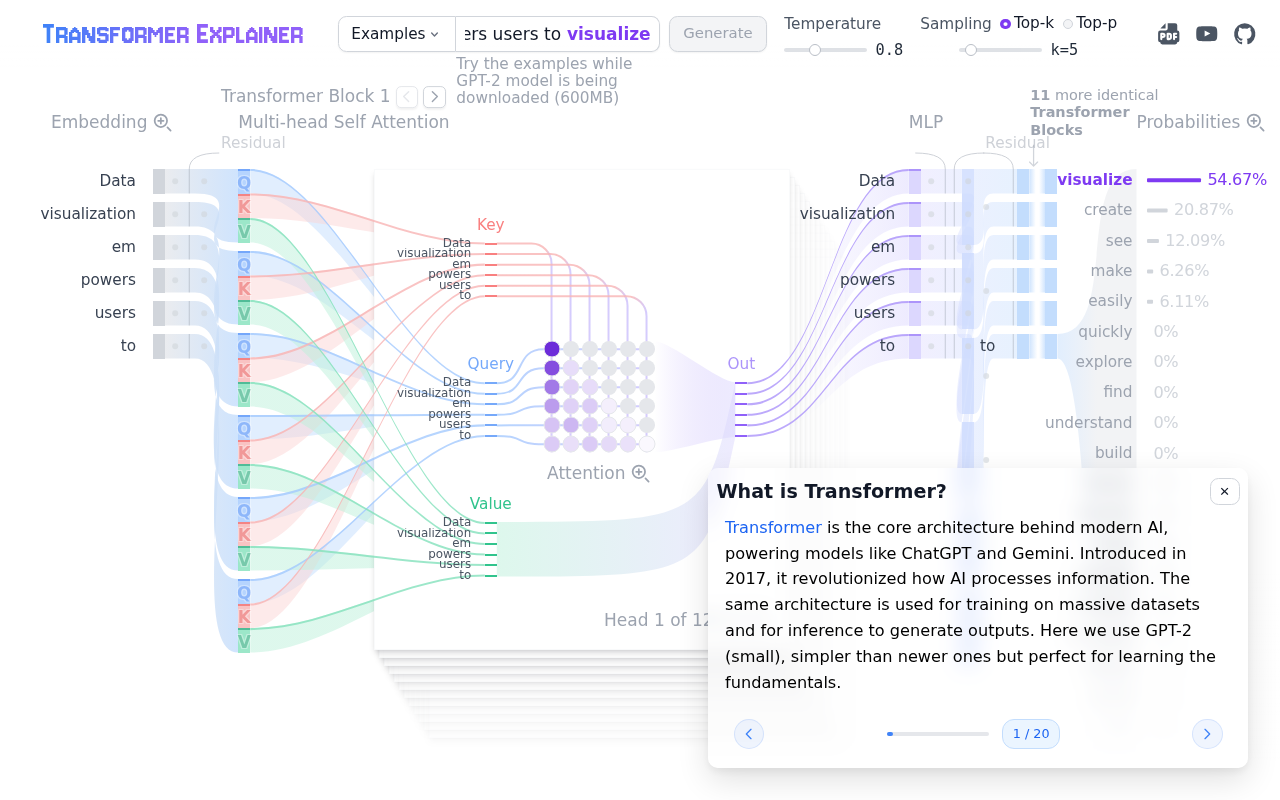
用可视化方式拆解Transformer架构,帮助AI从业者直观理解注意力机制、位置编码与编解码器设计。
本文围绕Transformer架构的核心组件展开系统介绍,重点解析了自注意力机制、多头注意力、位置编码以及编码器-解码器结构。自注意力通过Query、Key、Value三组向量的点积运算,使模型在处理每个词时能同时关注序列全局,突破了RNN长距离依赖的瓶颈;多头注意力则让模型从多个视角并行捕捉语法、语义等不同层次的关系。位置编码弥补了自注意力缺乏顺序感知的缺陷,从原始正弦编码到RoPE等改进方案不断演进。编码器适合理解类任务(如BERT),解码器适合生成类任务(如GPT),二者的模块化组合决定了各类大模型的能力边界。文章同时强调,可视化学习是建立模型直觉的高效路径,对基础架构的扎实理解比追逐新模型更具长期价值。
为什么Transformer值得每个AI从业者理解
Transformer架构自提出以来,已经成为现代大语言模型(LLM)的基石。从GPT系列到BERT,从图像识别到语音处理,几乎所有前沿AI系统的底层都能看到Transformer的影子。然而,对许多初学者甚至有经验的工程师来说,Transformer内部的注意力机制、位置编码和多头结构仍然是一个难以直观把握的"黑盒"。
近期在Hacker News上引发讨论的一篇题为《Transformers Explained Visually》的内容,正是试图用可视化的方式拆解这个复杂架构。相比堆砌数学公式,用图形化手段解释Transformer的信息流动,往往能让读者更快建立起对模型运作方式的直觉。
Transformer的核心:注意力机制
Transformer最革命性的创新在于自注意力(Self-Attention)机制。传统的循环神经网络(RNN)按顺序逐个处理序列元素,难以并行且容易丢失长距离依赖信息。而自注意力允许模型在处理某个词时,同时"关注"序列中所有其他位置的词,并根据相关性分配不同权重。
用可视化的方式来看,注意力机制本质上是在计算一组查询(Query)、键(Key)和值(Value)之间的关系矩阵。每个词都会生成这三种向量,通过Query与所有Key的点积来衡量彼此的关联强度,再用这些权重对Value做加权求和。这种"全局视野"是Transformer能够高效捕捉上下文语义的关键。
多头注意力带来的表达力
单一的注意力计算可能只能捕捉一种类型的关系。Transformer引入了多头注意力(Multi-Head Attention),相当于让模型同时从多个不同的"视角"去理解序列。有的注意力头可能关注语法结构,有的可能关注语义关联。这些并行的注意力结果最终被拼接并映射回原始维度,大幅提升了模型的表达能力。
从计算复杂度角度理解这一设计的代价也很重要:自注意力对序列中每对位置都要计算关联分数,复杂度为 O(n²),其中 n 是序列长度。这意味着当输入文本很长时,计算量和显存占用会急剧增加。这正是后续大量研究(如 Longformer、FlashAttention、稀疏注意力)试图解决的核心瓶颈。FlashAttention 通过重新安排 GPU 内存访问顺序,在不改变数学等价性的前提下显著加速了注意力计算,成为当前主流 LLM 训练与推理的标配优化手段。理解这一 O(n²) 瓶颈,有助于解释为什么不同模型对"上下文窗口长度"有不同限制,也是评估新架构(如 Mamba 等线性复杂度模型)价值的重要参照系。
位置编码:让模型理解顺序
由于自注意力本身不包含顺序信息(它平等对待所有位置),Transformer需要额外的机制告诉模型每个词在序列中的位置。这就是位置编码(Positional Encoding)的作用。
原始论文采用正弦和余弦函数生成位置向量,将其加到词嵌入上。可视化这些位置编码时,可以看到不同维度上呈现出规律性的波形,让模型能够区分"第一个词"和"第十个词"的差异。后续研究中出现的旋转位置编码(RoPE)等改进方案,进一步优化了长序列场景下的表现。
旋转位置编码(RoPE,Rotary Position Embedding)是目前应用最广泛的改进方案之一,被 LLaMA、Qwen、ChatGLM 等主流开源模型采用。其核心思想是不将位置信息直接加到词向量上,而是在计算 Query 与 Key 的点积时,通过旋转矩阵将相对位置关系"编码进"注意力分数本身。这样做的优势是模型能更自然地泛化到训练时未见过的序列长度,并且在长文本场景下保持更稳定的性能。另一个常见方案是 ALiBi(Attention with Linear Biases),它直接在注意力分数上叠加与距离成正比的线性惩罚项,实现简洁且对长度外推友好。这两种方案都比原始正弦编码在实用中表现更优,是阅读当前模型技术报告时会频繁遇到的术语。
编码器-解码器结构
完整的Transformer由编码器(Encoder)和解码器(Decoder)两部分堆叠构成。编码器负责将输入序列转化为富含上下文信息的表示,解码器则基于这些表示逐步生成输出。
值得关注的是,不同应用会选择不同的部分:BERT类模型主要使用编码器,擅长理解类任务;GPT类模型采用解码器结构,专注于生成任务;而机器翻译等场景则会同时使用两者。理解这种模块化设计,有助于把握当前各类大模型的能力边界。
解码器结构之所以适合生成任务,关键在于其"掩码自注意力"(Masked Self-Attention)设计:在生成第 t 个词时,模型只能看到位置 1 到 t-1 的已生成内容,无法"偷看"未来的词。这一约束在训练时通过掩码矩阵实现,使得整个序列可以并行训练,而在推理时则天然符合逐词生成的自回归(Autoregressive)过程。与之对比,编码器的自注意力是双向的——每个位置可以同时看到左右两侧的上下文,因此擅长理解而非生成。纯解码器架构的模型(GPT 系列)在规模扩大后展现出了惊人的少样本学习能力,这也是当前以 GPT 路线为主流的重要原因之一。
可视化学习的价值
这类可视化教程之所以受到社区关注,是因为它降低了理解门槛。抽象的矩阵运算通过动画和图形呈现后,学习者能够看清数据如何在层与层之间流动、注意力权重如何分布,从而建立起对模型行为的物理直觉。
对于希望进入AI领域的开发者而言,先通过可视化建立宏观认知,再深入研究数学细节和代码实现,往往是更高效的学习路径。掌握Transformer不仅是理解当前大模型的必修课,也是未来跟进架构演进的基础。
结语
尽管Hacker News上的原始讨论篇幅有限,但它所指向的主题——用可视化方式理解Transformer——切中了众多学习者的痛点。在大模型技术快速迭代的今天,回归对基础架构的扎实理解,比追逐每一个新模型更有长期价值。如果你正在学习深度学习,不妨从直观理解注意力机制开始,逐步搭建起完整的知识体系。
相关推荐
TensorRT多设备推理:简化Dynamo-Triton的多GPU模型部署
NVIDIA在Dynamo-Triton中引入TensorRT多设备推理能力,简化跨多GPU的大模型部署,解决单卡显存与算力不足问题,为生成式AI生产环境提供更高效的推理服务方案。
Grok 4.7 登陆 Devin:后端硬核任务表现突出
Grok 4.7 现已在 Devin Desktop 和 CLI 上线。在 FrontierCode 1.1 基准中,它在多模块后端硬核任务上表现最强,但因倾向过度扩展任务范围,综合得分略逊于 Grok 4.6。
数据本体论:AI智能体缺失的上下文层
数据本体论(Data Ontology)是AI智能体缺失的上下文层。本文解析它如何统一业务语义、消除数据歧义,让AI从猜测业务含义转向依据明确定义执行,是企业级AI落地的关键基础设施。