KV Cache跨版本复用:DeepSeek-V4-Flash案例研究

DeepSeek-V4-Flash案例揭示KV Cache跨版本复用可加速但保真度存风险。
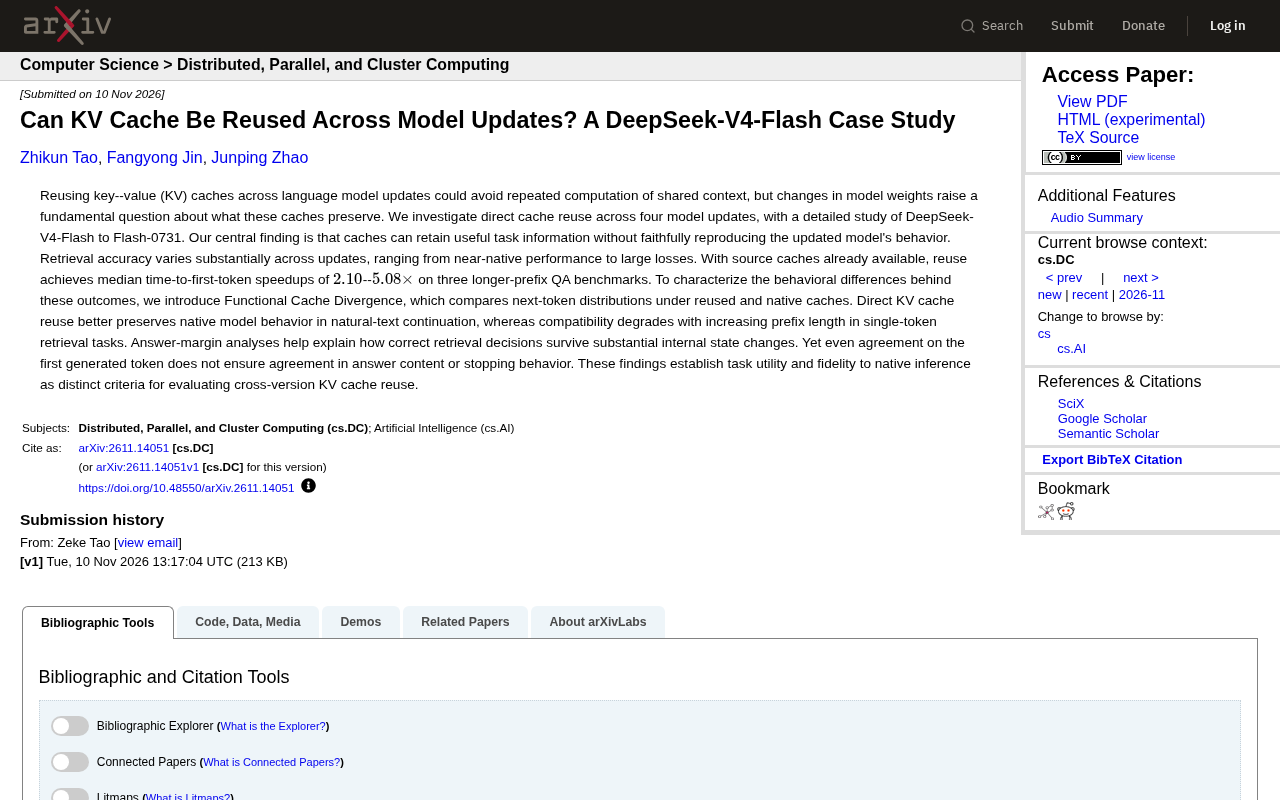
该案例研究考察了DeepSeek-V4-Flash在四次模型更新间直接复用KV Cache的效果。研究发现,复用源模型缓存可保留有用任务信息,带来中位数2.10至5.08倍的首次令牌时间加速,但检索准确率波动显著,且复用缓存未必忠实复现更新后模型的行为。研究提出功能缓存差异度量,通过比较下一令牌分布量化行为偏离,并揭示任务类型的影响:自然文本续写保真度较高,单令牌检索任务随前缀长度增加兼容性下降。答案边际分析进一步表明,首个生成令牌一致不保证答案内容或停止行为一致,需更全面的行为验证。研究由此确立任务效用与保真度双标准评估框架。
引言:跨版本KV Cache复用的可能性与挑战
在大语言模型推理中,KV Cache 是避免重复计算共享上下文的关键技术。但当模型权重更新后,旧的 KV Cache 是否还能直接复用?一篇针对 DeepSeek广告-V4-Flash 的案例研究给出了细致解答。该研究考察了四次模型更新间的直接缓存复用,重点分析了 DeepSeek-V4-Flash 到 Flash-0731 的迁移。核心发现是:缓存可以保留有用的任务信息,却未必能忠实复现更新后模型的行为。这为跨版本缓存复用划定了能力边界。
KV Cache(键值缓存)是 Transformer 解码器在自回归生成时的一种记忆机制:每生成一个 token,模型都会为之前所有 token 计算键(Key)和值(Value)向量并缓存,后续步骤只需计算新 token 的键值,从而避免对共享前缀的重复注意力计算。在长上下文场景中,KV Cache 可占显存的主要部分,直接决定推理吞吐与延迟。跨版本复用指的是:模型权重更新后,仍尝试把旧版本生成的 KV Cache 直接喂给新版本模型,省去预填充阶段。这要求新模型能“理解”旧模型产生的键值表示,而权重更新可能改变表示空间,因此复用是否有效成为关键问题。
核心发现:任务效用与行为保真度的分离
研究团队在三个长前缀问答基准上测试了直接复用源模型 KV Cache 的效果。结果显示,检索准确率在不同更新间波动显著,从接近原生性能到大幅损失不等。在源缓存已就绪的前提下,复用带来了中位数 2.10 至 5.08 倍的首次令牌时间加速。这一加速幅度表明,复用确实能节省可观的计算开销。
然而,加速并非没有代价。缓存保留的任务信息与模型实际行为之间出现了分离:即使缓存能帮助模型做出正确的检索决策,其内部状态也已偏离更新后的原生模型。这种分离引出了评估跨版本缓存复用的两个独立标准:任务效用(能否完成任务)和保真度(是否忠实于原生推理)。
首次令牌时间(Time to First Token,TTFT)是衡量推理服务响应速度的核心指标,指从请求发出到模型生成第一个输出 token 的延迟。对于长前缀输入,TTFT 主要由预填充阶段决定:模型需对整个前缀做前向计算并构建 KV Cache。直接复用已有 KV Cache 可跳过预填充,因此能显著降低 TTFT。文中报告的 2.10 至 5.08 倍加速正是在源缓存已就绪、无需重新计算的前提下测得的。需要注意的是,这种加速只反映计算开销的节省,并不直接说明复用缓存对生成质量的影响,后者需通过任务效用和保真度另行评估。
方法创新:功能缓存差异度量
为了刻画复用缓存与原生缓存之间的行为差异,研究提出了功能缓存差异(Functional Cache Divergence),通过比较复用缓存和原生缓存下的下一令牌分布来量化偏离程度。这一指标超越了传统的准确性评估,直接触及模型内部状态的变化。
分析揭示出任务类型对兼容性的显著影响:在自然文本续写任务中,直接复用 KV Cache 能较好地保留原生模型行为;而在单令牌检索任务中,随着前缀长度增加,兼容性会下降。这说明缓存复用的效果高度依赖于任务性质,不能一概而论。
下一令牌分布是自回归语言模型在每一步输出的概率分布,覆盖词表中每个 token 成为下一个 token 的可能性。模型的行为本质上由这一分布序列决定:检索、续写、停止等能力都体现在分布的形状与峰值上。功能缓存差异通过比较复用缓存与原生缓存条件下同一位置的下一令牌分布来量化偏离,常用指标包括 KL 散度、总变分距离或 top-k 重叠率。相比只检查最终答案是否正确,分布层面的比较能捕捉内部状态的细微偏移,即使两个模型在某个位置采样出相同 token,其概率质量分布也可能显著不同,这为理解保真度损失提供了更细粒度的视角。
答案边际分析:正确决策如何幸存
研究进一步通过答案边际分析解释了正确检索决策如何在内部状态大幅变化后依然存活。即使复用缓存与原生缓存产生相同的首个生成令牌,也不保证答案内容或停止行为一致。这意味着,表面上的令牌一致性可能掩盖了深层的分布偏移。
这一发现对实际应用有直接启示:仅检查首个令牌是否匹配不足以判断缓存复用的可靠性。在需要精确答案或严格停止条件的场景中,必须进行更全面的行为验证。
答案边际(answer margin)指模型在生成答案 token 时,正确候选与最强竞争候选之间的对数概率差,反映模型对当前决策的置信程度。边际越大,模型越确信;边际越小,分布越平坦,采样结果越容易受微小扰动影响。在跨版本缓存复用中,即使复用缓存与原生缓存给出相同的首个生成 token,答案边际也可能不同:复用缓存的边际可能更小,导致后续 token 或停止行为的分布发生偏移。因此,答案边际分析能解释为何表面一致的输出背后仍存在行为差异,并提示在实际部署中应监控边际变化,而不仅比对首个 token。
实践启示与未来方向
该案例研究确立了评估跨版本 KV Cache 复用的双标准框架。对于工程实践,这意味着在享受 2.10–5.08 倍加速的同时,需要根据任务类型评估保真度风险。长前缀问答任务可能面临更大的兼容性挑战,而自然文本续写则相对稳健。
未来工作可探索如何通过轻量校准或选择性复用来平衡效用与保真度。DeepSeek-V4-Flash 的案例表明,KV Cache 跨版本复用并非简单的“能用或不能用”,而是一个需要精细权衡的连续谱。
相关推荐

Google Antigravity 设置指南:AI IDE 挑战 Cursor?
Google Antigravity 设置指南:了解这款由 Google DeepMind 打造的代理式 AI IDE 如何通过多代理架构、技能与 MCP 支持,挑战 Cursor 等传统 AI 编辑器。

Google无障碍功能大更新:手语转文字、Rambler语音转文本等
Google发布多项无障碍功能更新:Rambler语音转文本、Sign-to-Text手语转写、Guided Frame与Gemini集成、Motion Assist防晕动症等,覆盖Pixel、Android、Chrome、Workspace和Search。

字母哥用Google Search找野球场,AI搜索的实战秀
字母哥在迈阿密用Google Search的AI功能寻找热门野球场,一次真实的本地生活搜索体验。本文分析AI搜索如何理解模糊需求、直接给出行动建议,以及搜索从信息检索转向任务完成的趋势。