Lakebase 分支功能:让 AI 编程代理安全实验的隔离数据库方案
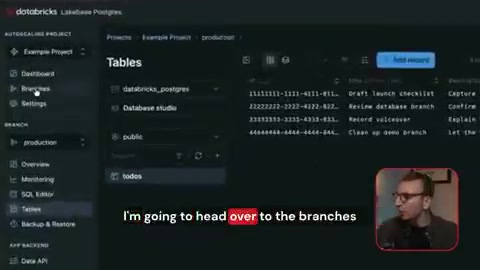
Databricks Lakebase Branching 为AI编程代理提供隔离数据库分支,让代理可安全试验而不影响生产环境。
Databricks 推出的 Lakebase Branching 将 Git 分支思想延伸至数据库领域,专门针对 AI 编程代理操作数据库时可能破坏生产环境的风险。该功能能够同时捕获数据库的 schema 与数据,创建与生产高度一致的隔离临时副本,供代理自由实验。配合 Databricks CLI、AGENTS.md 行为规范文件以及与父分支的差异对比机制,变更须经人工审查后才能通过 CI/CD 流水线推进上线。这套工作流的核心价值在于用基础设施层面的隔离机制解耦了代理的"自由度"与生产环境的"安全性",同时因其支持真实数据快照,也适用于测试数据迁移、验证复杂查询等非 AI 代理场景。
当编程代理需要一片安全的试验田
随着 AI 编程代理(coding agents)逐渐渗透到日常开发流程,一个绕不开的风险浮出水面:这些代理在自动修改数据库结构或数据时,很可能波及生产环境。Databricks 推出的 Lakebase Branching 正是针对这一痛点,提供了一套隔离的、短生命周期的数据库环境方案。
核心理念其实并不复杂——给代理一个可以随意折腾的空间,但不让它碰到真正的生产数据。这与软件工程里 Git 分支的思路一脉相承,只不过这一次,分支的对象从代码扩展到了数据库的 schema 与数据本身。
Lakebase Branching 到底做了什么
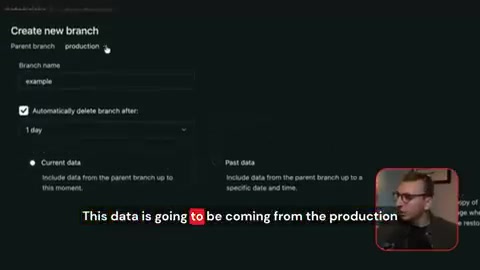
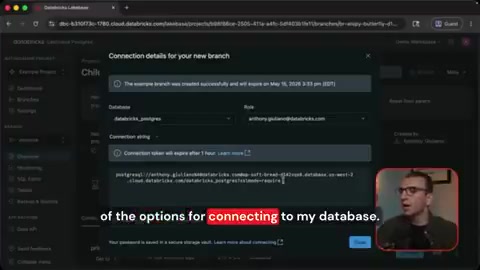
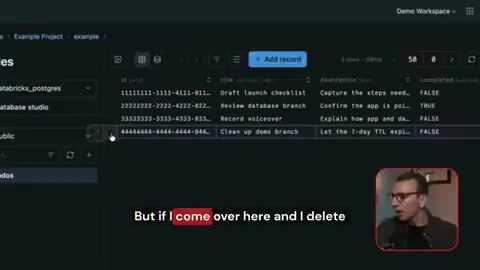
根据 Databricks 官方描述,Lakebase Branching 能够创建隔离的、临时的数据库环境,并且同时捕获数据库的 schema(结构) 和 data(数据)。这意味着代理拿到的不是一个空壳测试库,而是一个与生产环境高度一致的完整副本。
这一点非常关键。传统的测试环境往往因为数据缺失或结构陈旧,导致测试结果与真实场景脱节。而分支功能在捕获真实数据快照的前提下做到隔离,让代理的实验结果更具参考价值,同时又不会对线上业务造成任何影响。
"short-lived"(短生命周期)的设计也值得关注。分支环境用完即弃,避免了长期维护测试库带来的资源浪费与数据漂移问题。这种即用即销的模式,恰好契合 AI 代理高频、快速迭代的工作特征。
代理式分支工作流的搭建思路
Databricks 演示了一套完整的 agentic branching workflow(代理式分支工作流),其中涉及几个关键组件:
Databricks CLI 与 AGENTS.md
工作流通过 Databricks CLI 进行操作,配合 AGENTS.md 文件来定义代理的行为规范。AGENTS.md 作为一种约定俗成的代理指令文件,为编程代理提供了明确的上下文和操作边界,让它知道在什么范围内可以自由行动。
AGENTS.md 是随 AI 编程代理工具兴起而逐渐形成的一种约定文件格式,类似于代码仓库中的 CONTRIBUTING.md 或 .cursorrules,用于向代理说明项目结构、可用工具、操作限制以及预期行为规范。不同代理框架(如 OpenAI Codex、Devin、GitHub Copilot Workspace 等)对这类文件的读取方式略有差异,但核心作用相同:为代理提供"系统提示"级别的上下文,避免它在缺乏信息的情况下做出危险假设。在数据库操作场景中,AGENTS.md 可以明确指定哪些表可以修改、哪些操作需要人工确认、以及分支命名规范等,从而在提示词层面为安全边界增加一道软性约束,与基础设施层面的分支隔离形成互补。
与父分支的差异对比
代理在分支中完成修改后,可以将变更与**父分支(parent branch)**进行对比。这一步类似于代码审查中的 diff 环节,让开发者能够清晰地看到代理究竟改了哪些 schema 和数据,从而做出是否批准的判断。
通过 CI/CD 推进已批准的变更
一旦变更获得批准,就可以通过 CI/CD 流水线将其推进到更高级别的环境乃至生产。这种设计把 AI 代理的产出纳入了标准化的软件交付管线,而不是让它绕过既有的质量把关流程。
为什么这套方案值得关注
这套工作流的价值在于,它把 AI 代理的"自由度"与生产环境的"安全性"这对看似矛盾的需求解耦开来。代理可以在隔离分支里大胆试错,而任何变更都必须经过对比审查和 CI/CD 才能落地。
对于正在探索将 AI 代理引入数据工程和数据库运维的团队来说,这提供了一个可参考的范式:用基础设施层面的隔离机制,来约束不确定性较高的自动化工具。 与其寄希望于代理永远不犯错,不如从架构上确保它即便犯错也不会造成实质损害。
值得一提的是,schema 与 data 的同步捕获,也让这类分支在测试数据迁移、验证复杂查询、排查生产问题等场景中同样有用武之地,其应用范围并不局限于 AI 代理这一单一场景。
数据漂移(data drift)是传统长期测试环境的顽疾:测试库的结构和数据随时间逐渐偏离生产环境,导致在测试环境中验证通过的变更,上线后仍可能引发意外。Lakebase Branching 的"即用即销"短生命周期设计从根本上规避了这个问题——每次分支都从生产快照出发,保证测试基线的新鲜度。这对 AI 代理尤为重要:代理的决策质量高度依赖所接触数据的真实性,一个过时的测试库可能导致代理生成的 schema 迁移脚本或查询优化方案在真实数据分布下完全失效。将隔离性与数据新鲜度同时纳入设计目标,是这套方案区别于传统沙箱机制的关键所在。
小结
Lakebase Branching 把 Git 式的分支思维带入了数据库领域,并将其与 AI 编程代理的实际需求结合。通过隔离环境、schema 与数据的完整快照、以及 CLI + AGENTS.md + CI/CD 的工作流闭环,它试图回答一个越来越迫切的问题:如何让 AI 代理放手去做事,同时守住生产数据这条底线。
对关注 AI 驱动开发和数据平台演进的从业者而言,这是一个值得动手实测的功能方向。
相关推荐
用AI从零搭建网站:一场坦白引发的开发者反思
一篇 Hacker News 热帖以“忏悔”方式坦白用 AI 搭建网站,引发开发者社区关于 AI 编程是效率革命还是技术偷懒的激烈讨论。本文剖析工具论与技艺论之争,探讨 AI 建站的现实价值与边界。
甲骨文对新墨西哥AI数据中心援引不可抗力条款
甲骨文(Oracle)对其新墨西哥州AI数据中心项目援引不可抗力条款。本文分析这一动向背后可能的电力、水资源与供应链约束,及其对AI基础设施扩张的行业启示。
Databricks冠名加州伯克利Cal Bears球场:回归创业起点
Databricks宣布冠名加州伯克利Cal Bears球场。七位联合创始人均为伯克利校友,公司雏形代码诞生于Soda Hall,此举意在回馈母校并投资下一代AI研究者。