Lakebase Search向量检索基准测试:缓存与索引匹配是关键

Lakebase 基准显示,缓存与向量索引规模是否匹配,比数据行数更能决定搜索延迟。
Lakebase Search 在 100 万到 400 万段落的规模区间内测试了向量搜索延迟,得出一个反直觉的结论:决定性能的关键变量不是数据行数,而是缓存大小相对于向量索引规模的比例。当缓存大致匹配索引规模时,95–98% 的页面读取可以避开底层存储,热查询的 p50 延迟稳定在 11 到 23 毫秒,处于交互式应用可接受的水平。文章由此指出,行数增加本身未必导致延迟恶化,真正的问题是索引变大后缓存相对变小、命中率下滑、存储读取比例上升。对生产团队的可操作启示是:规划数据集增长时同步扩展缓存容量,使两者保持匹配;同时需注意该结论针对缓存就绪的热查询,冷启动与缓存未命中场景仍需结合自身负载验证。
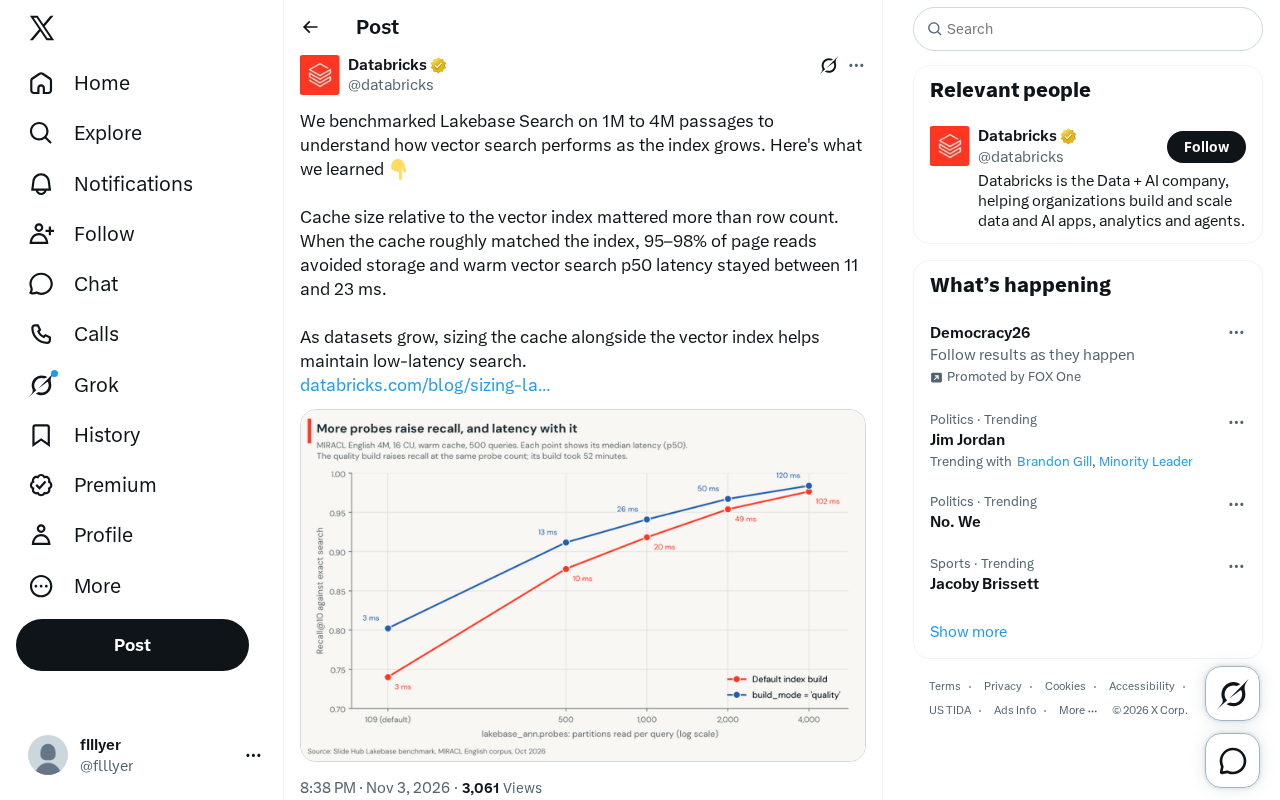
当向量索引从百万级扩展到四百万级段落时,搜索延迟会如何变化?Lakebase 团队做了一组基准测试,结论有些反直觉:决定性能的,往往不是数据行数,而是缓存与索引规模的匹配程度。
基准测试揭示的核心发现
Lakebase Search 在 1M 到 4M passages 的规模区间内进行了向量搜索基准测试。团队关注的核心问题是:随着索引增长,向量检索的延迟表现如何变化。
测试给出的答案指向一个关键变量——缓存大小相对于向量索引的比例。当缓存大致匹配索引规模时,绝大多数页面读取可以避开底层存储,热向量搜索的 p50 延迟稳定在 11 到 23 毫秒之间。这意味着查询响应处于交互式应用可接受的水平。
这一发现的价值在于,它把性能优化的焦点从「堆更多行」转移到了「配好缓存比例」上。
p50 延迟与热查询的含义
p50 延迟指把所有请求按耗时排序后位于中位数的那次请求的耗时,也就是一半请求快于、一半慢于该值。相比平均值,p50 更能反映典型用户的体验,因为平均值容易被少量极慢请求拉高。文中强调的“热”查询,指索引数据已被加载进缓存、系统处于稳定运行状态下的请求路径,不包括冷启动、缓存淘汰后首次访问或批量导入期间的查询。因此 11 到 23 毫秒的 p50 应理解为理想缓存条件下的典型延迟,而非任意时刻的保证值。评估生产表现时,还需要关注 p95/p99 尾部延迟,因为缓存未命中往往集中在少数请求上,尾部指标对容量规划更敏感。
为什么缓存比行数更重要
向量搜索的底层逻辑是近邻检索,查询时需要频繁访问索引中的向量数据。如果这部分数据常驻内存,查询路径就短;一旦需要回落到存储层,延迟会明显上升。
Lakebase 的测试表明,当缓存容量与向量索引规模大致对齐时,95–98% 的页面读取都避开了存储访问。换句话说,缓存命中率维持在高位,热查询的延迟就能保持在低水平。
这解释了为什么单纯看行数容易误判性能。行数增加本身不一定导致延迟恶化,真正的问题是索引变大后缓存相对变小,命中率下滑,存储读取比例上升。
页面读取(page read)与命中存储层的代价
文中反复提到的“页面读取”,指的是数据库从存储层以固定大小的数据页为单位读取索引或数据块的操作。向量索引(如 HNSW 之类的图结构)在内存中按页组织,一次近邻检索往往需要沿图遍历访问数十到数百个节点,这些节点可能分布在多个数据页上。若页面已在内存缓冲池中,读取只需微秒级;一旦未命中而回落到磁盘或远端存储,单次访问可能消耗数十到数百微秒甚至毫秒级,且并发查询时会被放大。因此缓存命中率从 98% 降到 95% 这类看似微小的变化,在向量检索这种高频随机访问的负载下,会直接体现在 p50 与尾部延迟上。这也解释了为什么“页面读取避开存储访问的比例”比“索引总行数”更适合作为性能判断指标——前者刻画的是实际访问路径,后者只是数据规模的静态描述。
对生产环境的实际启示
对于运行向量搜索的团队来说,这组基准测试提供了可操作的扩容思路:在规划数据集增长时,同步调整缓存容量,使其与向量索引规模保持匹配。
原文的结论也很直接——随着数据集增长,让缓存大小与向量索引同步扩展,有助于维持低延迟搜索。
有意思的是,这里讨论的是「热」查询的延迟表现,即缓存已经就绪、索引常驻内存的理想状态。冷启动或缓存未命中场景下的表现,原始素材没有展开,实际部署时仍需结合自身负载特征验证。
RAG 与语义搜索中的延迟预算
检索增强生成(RAG)系统通常在一次用户请求中串联“检索—重排—生成”多个阶段。大模型生成阶段往往占用数百毫秒到数秒,相比之下向量检索的几十毫秒占比不高,但它决定了整条链路能否在首字输出前及时拿到上下文。交互式语义搜索对延迟更敏感,用户对超过约 100 毫秒的响应已能感知卡顿。把向量检索的 p50 控制在 11 到 23 毫秒,意味着检索环节为后续重排与生成留出了充足预算,也留出了应对流量峰值和缓存抖动的余量。这也是缓存与索引比例值得在扩容规划阶段就纳入考量的原因。
小结
Lakebase Search 的基准测试覆盖了百万到四百万段落的规模,核心结论可以概括为一句话:缓存与索引的匹配程度,比单纯的行数更能决定向量搜索的延迟表现。对于构建检索增强生成或语义搜索系统的团队,这提供了一个明确的资源配比参考。
相关推荐

Anthropic Fable 5.2实测:一句话生成3A游戏与Excel克隆
Anthropic Fable 5.2实测:三行提示词生成可玩《战争机器》克隆、完整Excel和DaVinci Resolve克隆,解析基准测试、Ultra Code模式、token成本与定价策略,评估它是否值得替代Opus 5.5。

赛博寻书:BT社区如何「劫走」塞林格遗作
塞林格未发表的《The Ocean Full of Bowling Balls》仅存于大学图书馆且禁止复制。一个私密BT tracker悬赏六TB上传积分,社区从背诵接力到eBay买书扫描,最终成功让文本流出,却因传播过快被管理员删种。本文复盘这场赛博寻书行动及其讽刺结局。

弹劾防长赫格塞斯?五角大楼战争与中期选举风暴
五角大楼气氛紧张,伊朗战事持续八个月仍无退出方案。评论分析赫格塞斯弹劾动议的真实动机:不是罢免,而是留下政治记录,并剖析战争如何通过油价与生活成本影响中期选举选情。