Laya开源决策模型:421M参数如何超越Jev基准测试
Laya是421M参数的开源非自回归决策模型,用单张GPU、2.5万条人工数据和RLCD强化学习实现高效边缘部署。
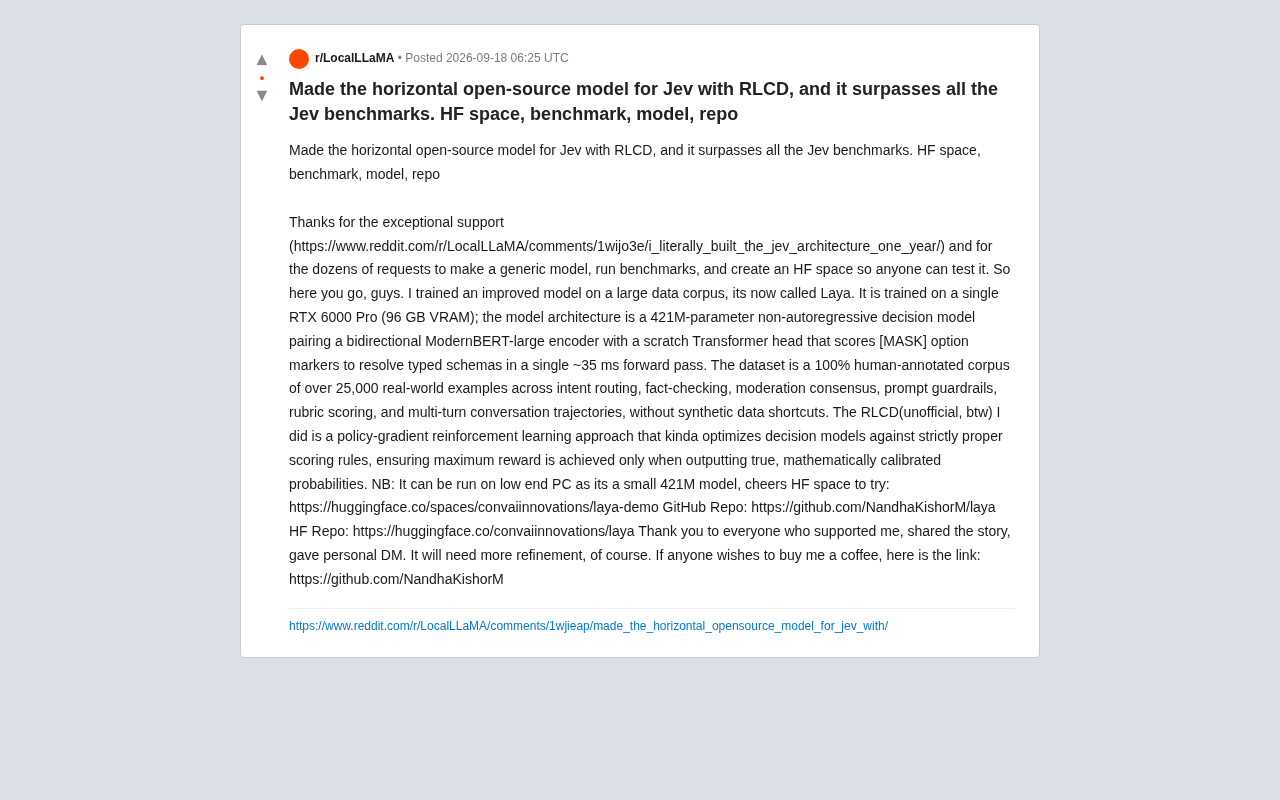
Laya是由个人开发者基于Jev架构迭代而来的421M参数非自回归决策模型,整个训练过程仅使用单张RTX 6000 Pro(96GB显存)完成。其架构将双向ModernBERT-large编码器与从零训练的Transformer头部结合,通过对`[MASK]`选项标记打分实现单次前向传播约35毫秒的快速推理,可在低端PC上运行。训练数据由超过25000条100%人工标注的真实样本构成,覆盖意图路由、事实核查、内容审核等决策场景。训练方法采用基于严格适当评分规则的RLCD策略梯度强化学习,确保模型输出经数学校准的真实概率而非仅给出硬标签。Laya以完全开源形式发布,为需要在资源受限环境中部署决策逻辑的开发者提供了一个可参考的轻量级范本。
开发者在Reddit的LocalLLaMA社区分享了一款名为Laya的开源决策模型。这款模型基于此前引发关注的Jev架构演进而来,通过RLCD训练方法在多项Jev基准测试中实现超越,同时保持了极小的模型体积和低硬件门槛。对于关注轻量级AI部署的开发者来说,这是一个值得研究的实践案例。
从Jev架构到Laya模型
这款模型的起源可以追溯到作者一年前构建的Jev架构。此前的分享获得了社区的强烈反响,大量用户请求作者制作一个通用模型、运行基准测试,并搭建一个人人可试用的HuggingFace Space。基于这些反馈,作者在更大规模的数据语料上训练出改进版模型,并将其命名为Laya。
值得关注的是,整个训练过程仅使用**单张RTX 6000 Pro(96GB显存)**完成。这意味着相比动辄需要数十上百张GPU集群的大模型训练,Laya展示了一条资源受限条件下的可行路径。
非自回归架构设计
Laya的核心是一个421M参数的非自回归决策模型。其架构将双向的ModernBERT-large编码器与一个从零训练的Transformer头部配对,通过对[MASK]选项标记进行评分来解析类型化的schema,整个过程在约35毫秒的单次前向传播内完成。
这种设计与主流的自回归生成式模型有本质区别。自回归模型需要逐token生成输出,而Laya采用非自回归方式,在单次前向传播中直接完成决策评分。这也是它能够在低端PC上运行的关键——421M的参数量配合非自回归推理,让边缘设备部署成为可能。
决策模型的应用场景
Laya定位为"决策模型"而非通用生成模型,这决定了它的适用范围。根据作者描述,模型专注于结构化决策任务,包括意图路由、事实核查、内容审核共识判断、提示词护栏、评分标准打分以及多轮对话轨迹分析等场景。这类任务通常需要快速、可校准的判断,而非开放式的文本生成。
ModernBERT是2024年底发布的编码器架构,是对经典BERT的现代化改良版本,引入了旋转位置编码(RoPE)、Flash Attention等技术,在保持双向注意力机制的同时大幅提升了推理效率和长文本处理能力。双向注意力意味着模型在处理每个token时可以同时看到其左右两侧的上下文,这与GPT系列单向(仅看左侧)的自回归设计截然不同。对于分类和评分类任务,双向编码器天然更适合理解完整输入的语义,而无需像生成模型那样逐步"猜"下一个词。Laya利用这一特性,将编码器输出与轻量Transformer头部结合,专门用于对候选选项的[MASK]位置打分排序,而非生成自由文本。
25000条纯人工标注数据
Laya的一个显著特点是训练数据的构成。整个语料库包含超过25000个真实世界样本,且100%由人工标注,覆盖意图路由、事实核查、审核共识、提示护栏、评分标准和多轮对话轨迹等多个维度。
作者特别强调没有采用合成数据的捷径。在当前大量模型依赖合成数据扩充训练集的背景下,纯人工标注的数据质量往往更高,尤其对于决策类任务,标注的准确性直接影响模型的判断可靠性。这也可能是Laya能够超越Jev基准的重要因素之一。
RLCD训练方法解析
Laya采用了作者自称"非官方"的RLCD训练方法。这是一种基于策略梯度的强化学习方法,用于针对严格适当评分规则(strictly proper scoring rules)来优化决策模型。
其核心思想在于:只有当模型输出真实、经过数学校准的概率时,才能获得最大奖励。这种设计确保模型不仅给出正确的决策,还能输出可信的置信度估计。对于事实核查、内容审核这类需要概率校准的任务而言,这一特性尤为重要——一个能准确表达"我有多确定"的模型,远比只给出黑白结论的模型更有实用价值。
严格适当评分规则(Strictly Proper Scoring Rules)是概率预测领域的经典概念,指一类当且仅当预测者报告其真实主观概率时才能期望获得最高得分的评分函数,常见的例子包括对数评分(Log Score)和Brier Score。"严格适当"确保了模型没有任何动机去夸大或缩小置信度——故意报告失真的概率只会降低期望得分。RLCD将这一数学性质引入强化学习训练循环,以此作为奖励信号来塑造模型行为,从而使模型学会输出"说到做到"的概率校准值,而非仅追求分类准确率的硬标签预测。这与传统交叉熵损失训练的区别在于:交叉熵鼓励模型把正确类别的概率推向1,但并不保证输出概率在统计意义上与真实发生频率一致。
开源资源与试用
作者以完全开源的方式发布了这一项目,提供了多个入口供社区体验和研究:
- HF Space在线试用:huggingface.co/spaces/convaiinnovations/laya-demo
- GitHub代码仓库:github.com/NandhaKishorM/laya
- HuggingFace模型仓库:huggingface.co/convaiinnovations/laya
作者也坦诚表示模型仍需进一步打磨优化。作为一个由个人开发者在有限硬件资源下完成的项目,Laya展示了轻量级决策模型的可能性——不追求参数规模的军备竞赛,而是通过精心的架构设计、高质量人工数据和创新的训练方法,在特定任务上做到高效且可靠。
对于需要在边缘设备或低成本环境中部署决策逻辑的开发者,Laya提供了一个值得参考的开源范本。
相关推荐
Claude Code国内实战指南:从安装到MCP的完整上手路径
Claude Code 国内使用完整指南,涵盖 Windows 安装、PyCharm/VSCode 等 IDE 集成、内置命令与记忆机制、三种权限模式、MCP 工具自定义及 Skills 技能系统,帮助开发者快速上手 AI 辅助编程。
免费领取一年Google AI Pro:Gemini学生优惠保姆级教程
谷歌Gemini重开学生免费计划,新老用户均可免费领取一年Google AI Pro会员。本文梳理保姆级教程:三种页面情况处理、Plus改Pro技巧、绑卡订阅与取消自动续费全流程及风险提示。
GPT Image 2.5 局部重绘实测:ComfyUI 里像开挂
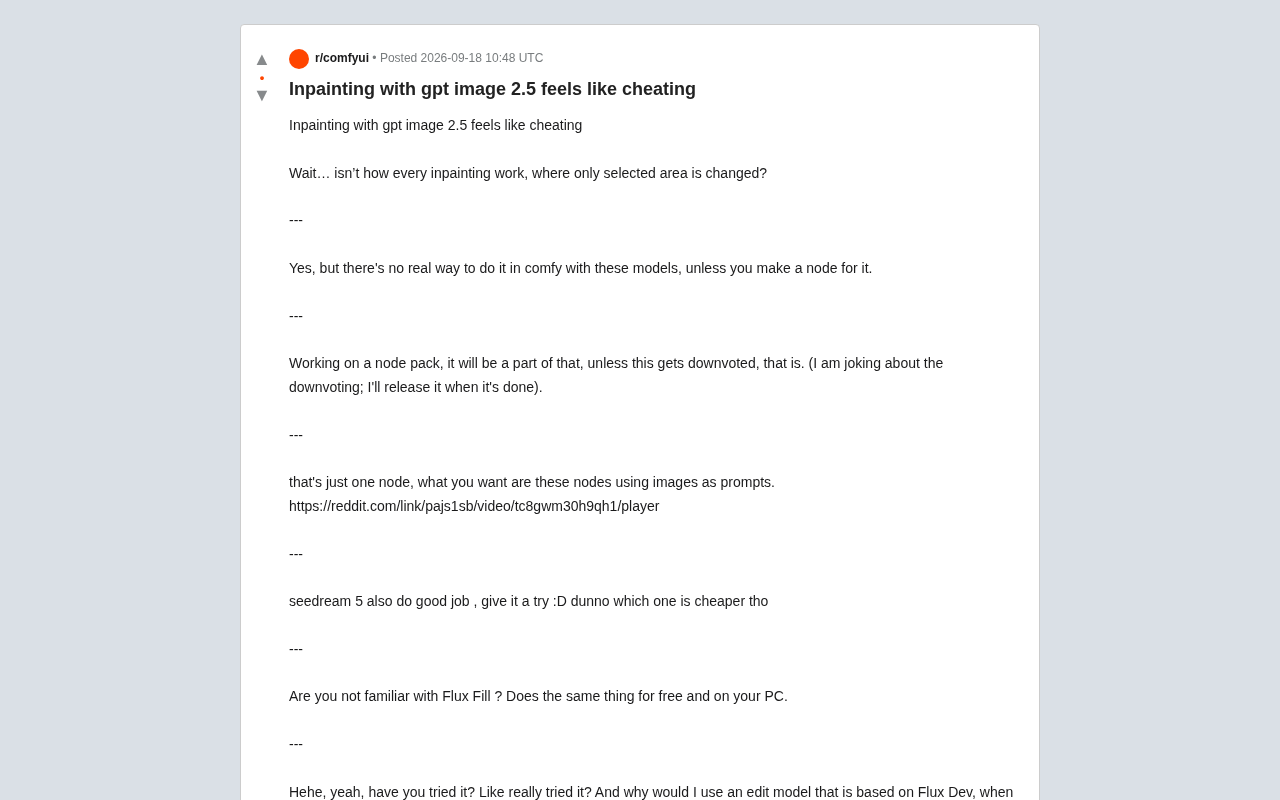
Reddit 社区热议 GPT Image 2.5 局部重绘(Inpainting)效果惊艳如"开挂",本文对比其与 Flux Fill、Seedream 5 等方案的差异,并探讨如何将商业模型接入 ComfyUI 节点工作流。