#决策模型
共 36 篇相关文章
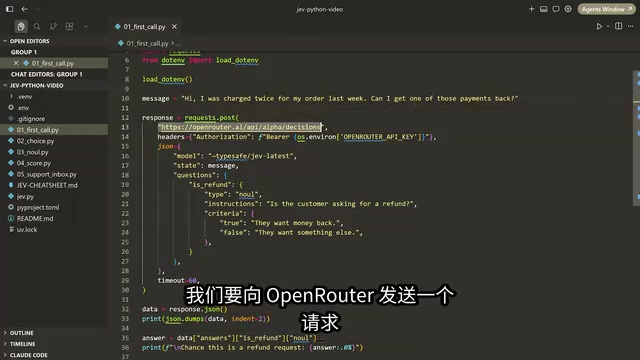
10分钟用Python调用决策模型Jev:让AI做选择与评分
B站视频教程演示如何用Python调用决策模型Jev:通过No、Choice、Score三类问题完成是否判断、分类与量表评分,并组合成低成本AI客服收件箱,含置信度阈值转人工的实操要点。
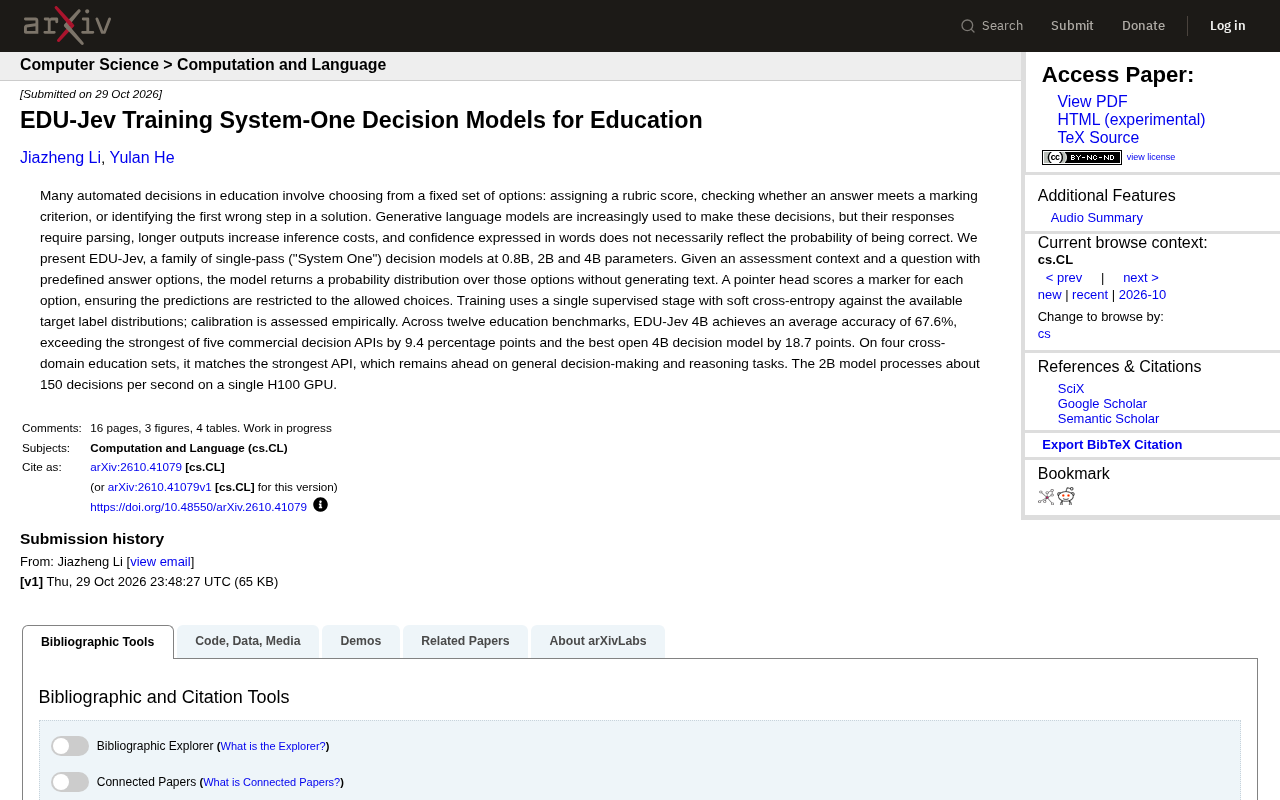
EDU-Jev:教育决策专用「系统一」模型,单次推理替代生成式评分
EDU-Jev 是面向教育场景的单次决策模型族,涵盖 0.8B、2B、4B 参数版本,通过 pointer head 直接在预设选项上输出概率分布,不做文本生成。4B 模型在十二个教育基准上平均准确率 67.6%,领先最强商业决策 API 9.4 个百分点,2B 模型单卡 H100 每秒约处理 150 次决策。

Jev决策模型爆火:为何全球开发者都在抄
Jev决策模型为何让OpenAI、Cloudflare、Ollama纷纷跟进?本文解析System 1决策模型与传统LLM的本质差异、实测速度成本对比,以及模型路由、实时提词器等真实用例与社区争议。

决策模型的性别偏见:当首选答案决定一切
研究发现决策模型存在性别偏见:六个模型中有五个对女性给出更有利答案,性别互换改变1-3.5%首选答案,置信度门槛反而提高刻板印象比例。审计需匹配应用逻辑。
Baseten发布joey-1:2B决策模型按概率输出,百万token仅0.01美元
Baseten发布joey-1,一个2B开放权重决策模型,输出校准概率而非文本,P50延迟20毫秒,每百万输入token成本0.01美元。本文分析其定位、适用场景与边界。
Jev实战:用单次Prefill替代逐token解码的决策模型
拆解Jev推理范式:跳过逐token解码,仅用一次prefill前向传播输出选择、序数评分与布尔判断。对比编码器与解码器两条实现路线,解析多问题掩码设计、重复token陷阱,以及RLCD结合GRPO的概率校准训练方法。

决策模型是什么?三种类型快速解析
决策模型分为谓词、选择、评分三类,分别对应是/否判断、多类别分类和程度打分。本文解析三种模型的定义、适用场景与组合用法,帮助AI应用开发者快速拆解业务问题。

DecisionAct v0.1.2:不用LLM,用决策模型构建多工具调用Agent
DecisionAct v0.1.2发布:一个基于决策模型(JEV、Cloudflare Clef)而非LLM的开源Python Agent框架,改进多工具调用可靠性、支持工具结果链式传递与输入不确定时自动向用户追问。

OpenAI开放决策模型竞争升级:Jev迎来劲敌
OpenAI宣布其决策模型广泛可用,直接对标先行者Jev。本文分析这一开放策略对决策模型竞争格局的影响,以及开发者和企业应关注的关键点。

Baseten Mammoth-1与Elephant-1决策模型限时免费上线AI Gateway
Baseten 旗下决策模型 Mammoth-1(27B)与 Elephant-1(9B)限时免费上线 AI Gateway,支持文本分类、请求路由与内容评分,16k 上下文,10 月 27 日前可免费调用。

Mouse-1:为AI Agent打造的高效决策模型,成本降163倍
Mouse-1是一款专为AI Agent框架设计的轻量级决策模型,据称比GPT-6 Sol成本低163倍、速度快65倍。本文介绍其工作原理、成本优势及适用场景,帮助开发者优化Agent成本结构。

把决策模型放进Agent循环,而不是放在旁边
Agent循环中的检查成本正在吞噬token预算。本文解析决策模型(Decision Model)如何以单次前向传播返回概率,替代完整生成式判断,让安全门、相关性打分和逐步验证变得廉价可负担,并介绍S1MB榜单与Darwin-27B-ZTC-v9的实测方法。
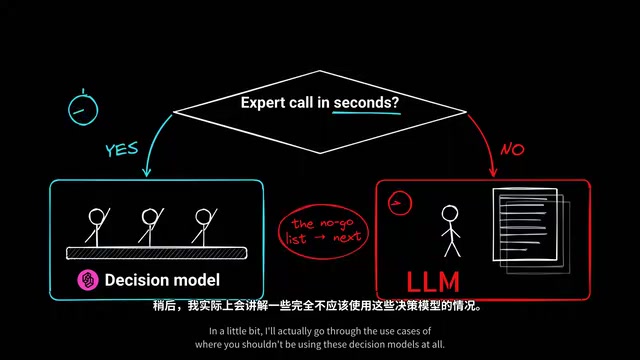
用Jev决策模型优化Agent Harness:六个关键场景
介绍如何用Jev等开放决策模型优化Agent Harness,涵盖模型路由、风险门控、技能渐进式披露、RAG重排序等六个接入场景,以及两种集成模式与不适用边界。

消费级GPU训练Jev决策模型:延迟降19倍的System 1实践
实测用24GB消费级GPU训练Qwen3.5决策模型,复刻微软Decision Head架构:训练仅15分钟、峰值VRAM 7.95GB,推論延迟从3679ms降至191ms,ECE校准降至0.036,附完整A/B对照与多任务压测数据。
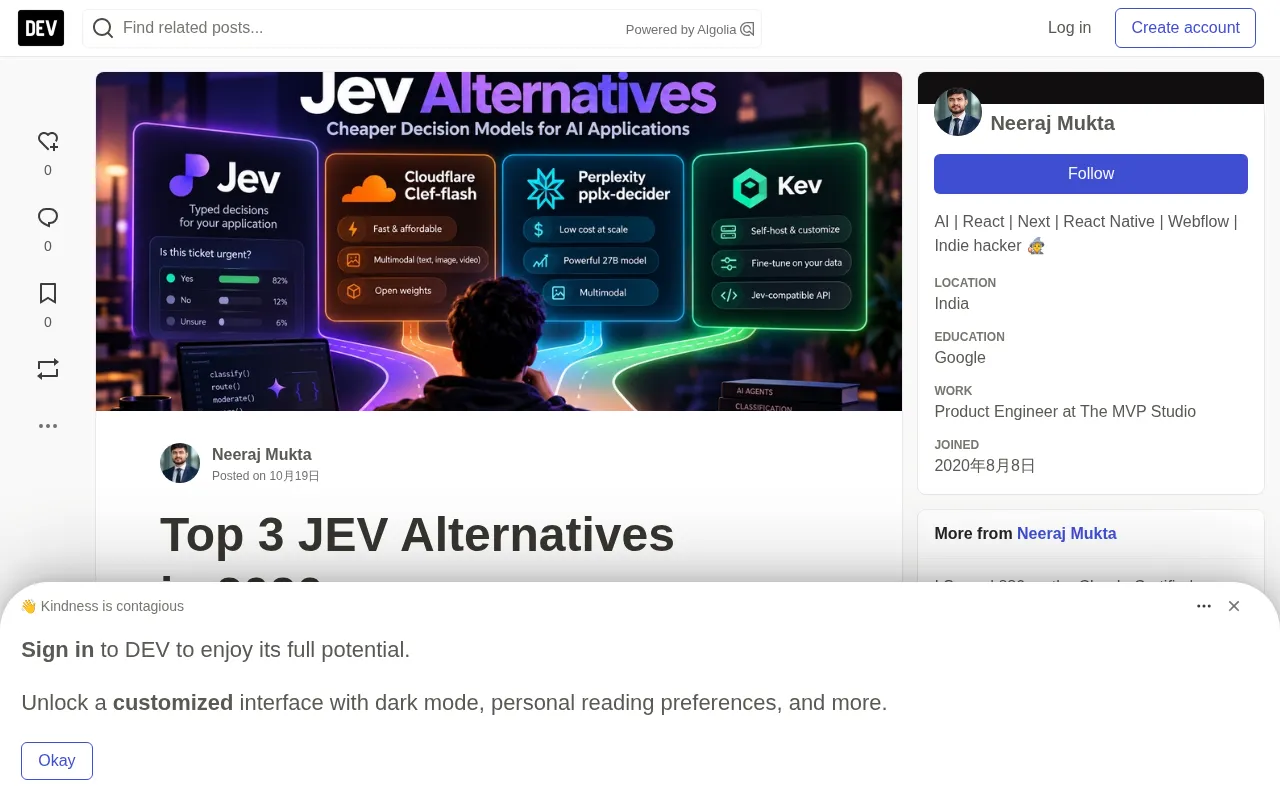
Jev替代方案Top3:决策模型选型指南
对比Jev与三款决策模型替代方案Cloudflare Clef-flash、Perplexity pplx-decider、Kev的定价、开放权重、多模态与自托管能力,给出基于自有数据基准测试的选型方法与迁移建议。

Wity:首个System 1.5模型,为软件决策而生
Wity 是首个 System 1.5 模型,介于快速直觉与审慎推理之间。它为软件中的高频小决策提供带类型的答案和概率,无需解析自然语言,API 返回结构化决策。

Jev、Drex、Laya三款System One决策模型对比
对比TypeSafe Jev、Nace Drex和ConvAI Laya三款System One决策模型:统一API协议下的开源程度、部署方式、模型规模、上下文、延迟、价格与基准表现差异,并给出零样本、微调和多选项场景的选型建议与基准解读注意事项。
Liquid AI发布d1-ultra:多模态决策模型AA指数达65
Liquid AI发布d1-ultra多模态决策模型,文本图像双输入,一次前向传播输出校准概率,AA Decision Index得分65,每百万输入token仅0.042美元。
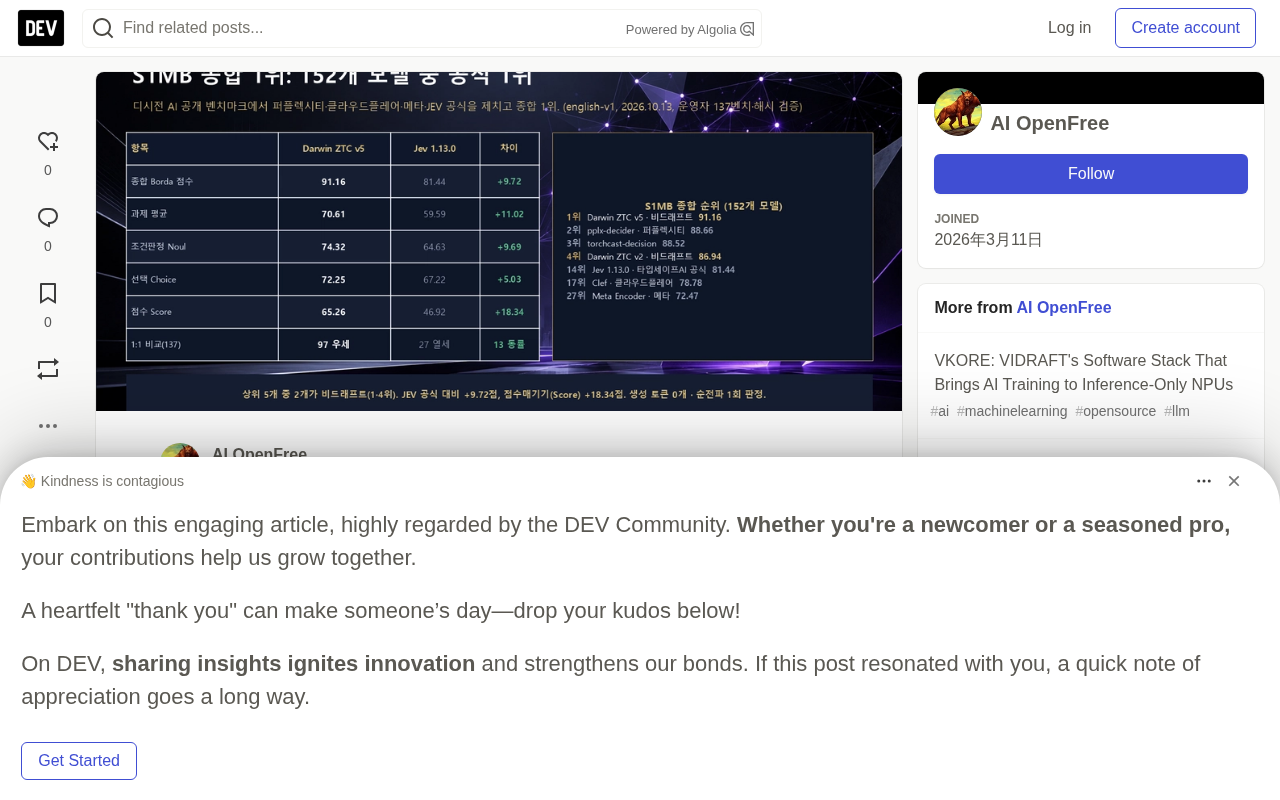
只用英语训练,却拿下日语第一:Darwin ZTC 登顶 S1MB
Darwin-27B-ZTC-v5 在 S1MB 日语赛道以 Borda 84.57 拿下第一,领先 Perplexity、torchcast 与 Jev 1.13,而它只用英语决策数据训练。这一跨语言迁移结果说明判断能力可以跨语言复用,对多语言产品的路由、打分与安全门控有直接参考价值。

SubQ Snap评测:决策模型跑分与价格战真相
SubQ Snap决策模型发布后Hacker News冷遇、LinkedIn热捧,本文拆解其SSA架构、384K上下文、自报基准跑分与六款决策模型的价格战,分析决策模型赛道的真实护城河在哪里。