零成本手搓推理模型:11小时开源课程拆解
Sebastian Raschka 发布 11 小时免费课程,逐行教你用 PyTorch 构建推理模型。
Sebastian Raschka 在 YouTube 推出 8 集免费视频课程,总时长约 11 小时,目标是让学习者用 Python 和 PyTorch 从零构建一个推理模型。课程以小型 Qwen3 模型为起点,依次覆盖 Verifier、Inference Time Scaling、GRPO 强化学习和蒸馏,形成一条完整的工程流水线。前置要求仅需 Python 和 PyTorch,前期可在 CPU 上运行,训练环节建议使用 GPU,代码在 GitHub 开源。文章认为该课程填补了论文与工程实现之间的缝隙,并给出先跑通再理解、重视 Verifier、CPU 阶段调试、对照论文看代码等实操建议。
推理模型听起来高不可攀,但 Sebastian Raschka——那本《Build a Large Language Model from Scratch》的作者——最近在 YouTube 上放出了一套完整的 8 集视频课程,总时长约 11 小时,全程免费。课程目标是让你从零开始,用 Python 和 PyTorch 亲手搭出一个推理模型。
课程从何开始:一个小模型 + 一条完整流水线
课程并不直接冲进强化学习,而是从一个小型的 Qwen3 模型起步。Raschka 的拆解路径是:先搭出一个能跑通的基础模型,再逐层叠加推理能力所需的关键组件。
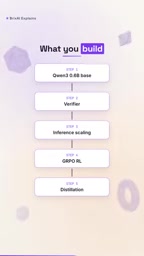
据他在课程公告中的描述,整条流水线依次覆盖:
- 小模型基础:以一个较小的 Qwen3 模型作为起点,保证本地可跑通
- Verifier(验证器):构建用于评估候选答案正确性的模块
- Inference Time Scaling:在推理阶段扩展计算量,换取更高质量的输出
- GRPO 强化学习:用 Group Relative Policy Optimization 对模型做强化学习训练
- Distillation(蒸馏):把能力压缩回更小的模型
这条路径基本对应了当下主流推理模型(如 DeepSeek广告-R1 系列所公开的方法论)背后的核心工程环节。课程强调"Line by Line",也就是逐行讲解代码,而不是停留在概念层面。
GRPO(Group Relative Policy Optimization) 是 DeepSeek 团队提出的一种强化学习算法,用于替代 PPO 训练语言模型。它的核心思想是:对同一个 prompt,让模型采样生成一组(group)多个回答,然后用组内奖励的相对大小(而不是绝对奖励值)来计算优势函数,从而省去 PPO 中需要额外训练的价值网络(critic)。这大幅降低了显存占用和训练复杂度,同时通过组内归一化稳定了策略梯度。在推理模型训练中,GRPO 常配合可验证的奖励信号(如答案正确性)使用,驱动模型学会长链推理。
Inference Time Scaling(推理时扩展) 指在模型权重不变的前提下,通过在推理阶段投入更多计算来提升输出质量。常见手段包括:让模型生成更长的思维链、采样多个候选答案后投票(self-consistency)、用验证器对候选解重排序(best-of-N)、以及树搜索等。它与训练时扩展(增大模型或数据)互补,尤其适合数学、代码等可自动验证的领域。课程将其与 GRPO 串联,体现了“训练时学推理、推理时用算力换质量”的完整闭环。
蒸馏(Distillation) 在此语境下通常指用大模型(或经过强化学习增强的推理模型)生成的高质量推理轨迹,去微调一个更小的学生模型。与经典的知识蒸馏(匹配 logits 分布)不同,推理模型蒸馏更关注行为克隆:让学生模型模仿教师模型在解决问题时的逐步推理过程。这样可以把 GRPO 等昂贵训练获得的能力压缩到小模型,降低部署成本。课程将蒸馏放在流水线末端,正是为了展示如何把前面环节得到的推理能力“回收”到轻量模型中。
Verifier(验证器) 是评估候选答案正确性的模块,可以是基于规则的检查器(如数学题答案比对)、单元测试执行器,或一个训练过的奖励模型。在推理模型流水线中,验证器扮演多重角色:在推理时扩展阶段,它用于对多个采样答案打分并挑选最优;在 GRPO 训练中,它提供奖励信号以计算组内相对优势;在蒸馏阶段,它用于筛选高质量的推理轨迹。因此验证器的质量直接决定了后续强化学习和蒸馏的效果上限,是整条流水线的基础设施。
硬件门槛与前置要求
课程对前置知识的要求相当克制:只需要会 Python 和 PyTorch。这一点值得展开说——市面上不少强化学习课程默认你熟悉 RL 理论、分布式训练、奖励建模等一大堆概念,而这套课程把门槛压到了"会写 PyTorch 代码"。
硬件方面,Raschka 的说法是:开头几个部分在 CPU 上就能跑通,训练环节用 GPU 效果更好。这种安排让没有高端显卡的学习者也能跟上前半程,不至于第一步就被环境卡住。
代码托管在 GitHub 上,以开源形式提供,意味着你可以对着视频暂停、改代码、跑实验结果,而不是只能看。
为什么这套课程值得关注
推理模型领域的一个显著问题是:论文和博客讲了"做了什么",但很少讲"代码怎么写"。GRPO 的公式在论文里只有几行,落到工程实现里却涉及采样、奖励计算、策略更新、显存管理等一系列细节。
这套课程的定位恰好填在这个缝隙里。作者本人的背景也提供了可信度背书——《Build a Large Language Model from Scratch》在从零构建 LLM 的教学领域有相当的口碑,而这套推理模型课程可以看作同一思路在"推理能力"方向上的延伸。
另一个值得留意的是课程对 Inference Time Scaling 的覆盖。这是一个常被忽略但影响极深的环节:同一套权重,推理阶段的计算策略不同,最终答案质量可能差别显著。把它和 GRPO、蒸馏串在同一条流水线里讲,比单独讲任何一个组件都更接近真实工程场景。
怎么用这套课程
如果你打算跟下来,几个实操建议:
先跑通再理解。 11 小时的内容不算短,逐行看容易在中途失去节奏。更有效的做法是先按仓库把流程跑通一遍,看到输出结果之后再回头抠每一行的作用。
不要跳过 Verifier 部分。 验证器是整条流水线的地基——强化学习阶段依赖验证器给出的信号,蒸馏阶段也依赖它筛选数据。这一段如果只是看过,后面的 GRPO 很容易变成黑箱。
CPU 阶段别急着上云。 课程前半段在 CPU 上可运行,这恰好是调试代码逻辑的最佳窗口,等到需要 GPU 的训练环节再考虑算力投入。
对照论文看代码。 GRPO 和推理时扩展都有对应的公开论文与方法描述,把课程代码和论文公式对照着看,理解速度会比单向接收快得多。
一句话总结
推理模型不再是只能读论文想象的东西——11 小时的免费课程、Python + PyTorch 的前置要求、开源可跑的代码,门槛已经降到了个人开发者可以动手的程度。想搞清楚推理模型背后到底发生了什么,直接去 YouTube 搜「Build a Reasoning Model from Scratch」即可。
相关推荐
Vibe Coding全栈实战:AI编程从入门到企业级落地
从Cursor到Claude Code,这套B站AI编程实战课程以四个递进项目覆盖全栈开发、开源二次开发与团队协作。文章解析AI编程带来的前端岗位震荡、五人选五十人的效率变革,以及企业级项目所需的方法论。
大卫·布莱恩全球寻访真魔术:从南非到日本与印度
大卫·布莱恩在《Do Not Attempt》特辑中走访南非、日本与印度,记录Spinning车手、黑曼巴蛇保护者、居合术大师与苦行者的真实绝技,探讨魔术与人类极限挑战之间的边界。
触屏MacBook要来了?Vergecast爆料苹果高管回应
Vergecast播客披露记者与苹果高管John Ternus的对话,谈及触屏MacBook与Apple Pencil支持问题。Ternus回应称iPad才是手写笔最佳设备,记者则押注MacBook终将支持Apple Pencil。