#推理模型
共 23 篇相关文章

当LLM成为神经元:用推理模型替换神经网络节点
Reddit社区提出LLM-as-a-Neuron设想:用推理模型替换神经网络中的单个神经元。本文分析这一设想在尺度和训练上的根本障碍,并探讨LLM作为网络功能模块的务实路径。

VERS:编辑激活解释,实现推理模型token减半
VERS方法通过编辑激活解释引导推理模型,在GSM8K上减少45.8%的token生成,准确率仅降0.82个百分点,并可迁移至更大模型,但在竞赛问题上精度损失明显。

Anthropic启动IPO:AI巨头上市与行业震荡
Anthropic提交S-1启动上市进程,社区讨论超1600赞;同期三项基础科学新发现、微软向约四分之一员工提出买断方案,Sebastian Raschka发布推理模型从零构建课程。一文梳理AI行业最新动态。

推理模型14个核心概念:从思维链到GRPO全面拆解
系统拆解推理模型14个核心概念:思维链、测试时计算、验证器、RLVR与GRPO、蒸馏与reward hacking,并给出思考token的成本控制规则,帮你判断何时值得为推理付费。
零成本手搓推理模型:11小时开源课程拆解
Sebastian Raschka 发布免费 8 集视频课程,总时长约 11 小时,教你用 Python 和 PyTorch 从零构建推理模型:从 Qwen3 小模型起步,串联 Verifier、Inference Time Scaling、GRPO 强化学习与蒸馏,代码在 GitHub 开源。
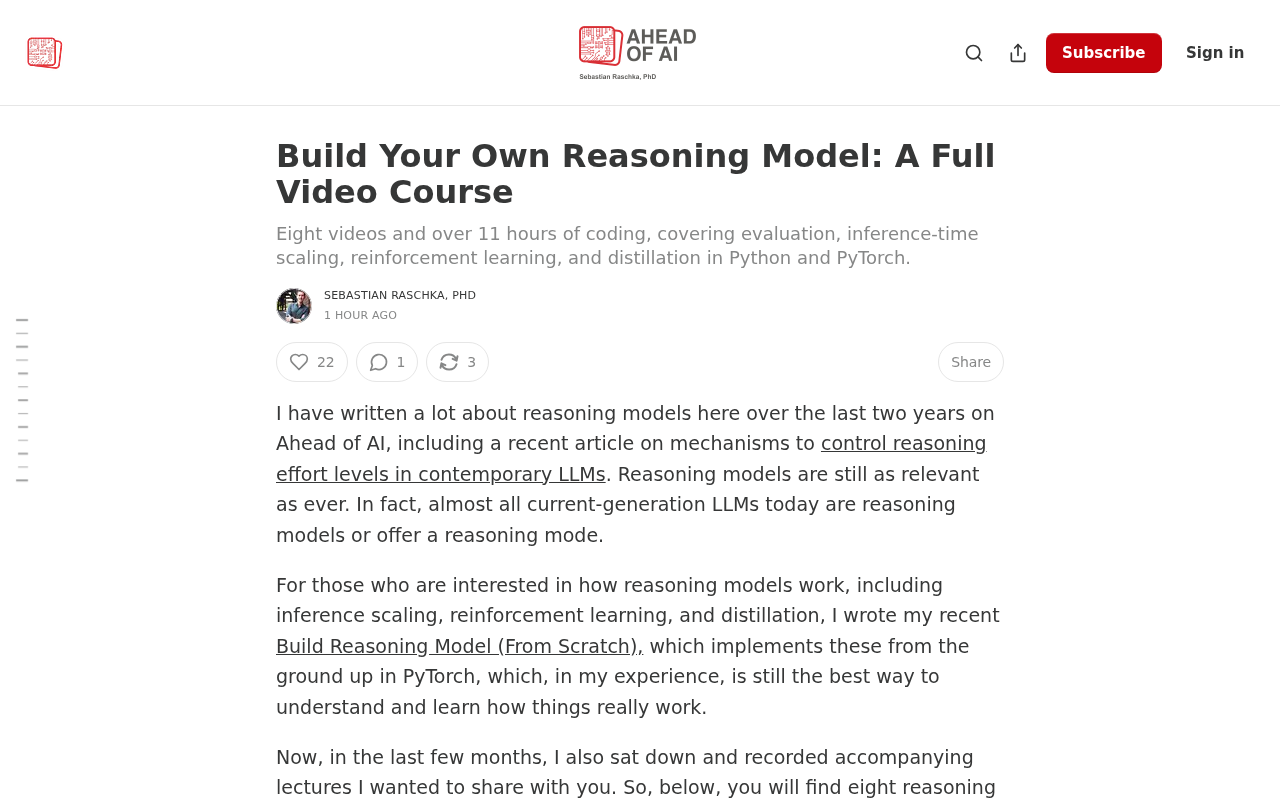
11小时视频课程:从零构建推理模型
一套超过11小时的视频课程,用Python和PyTorch讲解推理模型的评估、推理时扩展、强化学习与蒸馏四大模块,适合有基础的开发者系统学习推理模型构建。
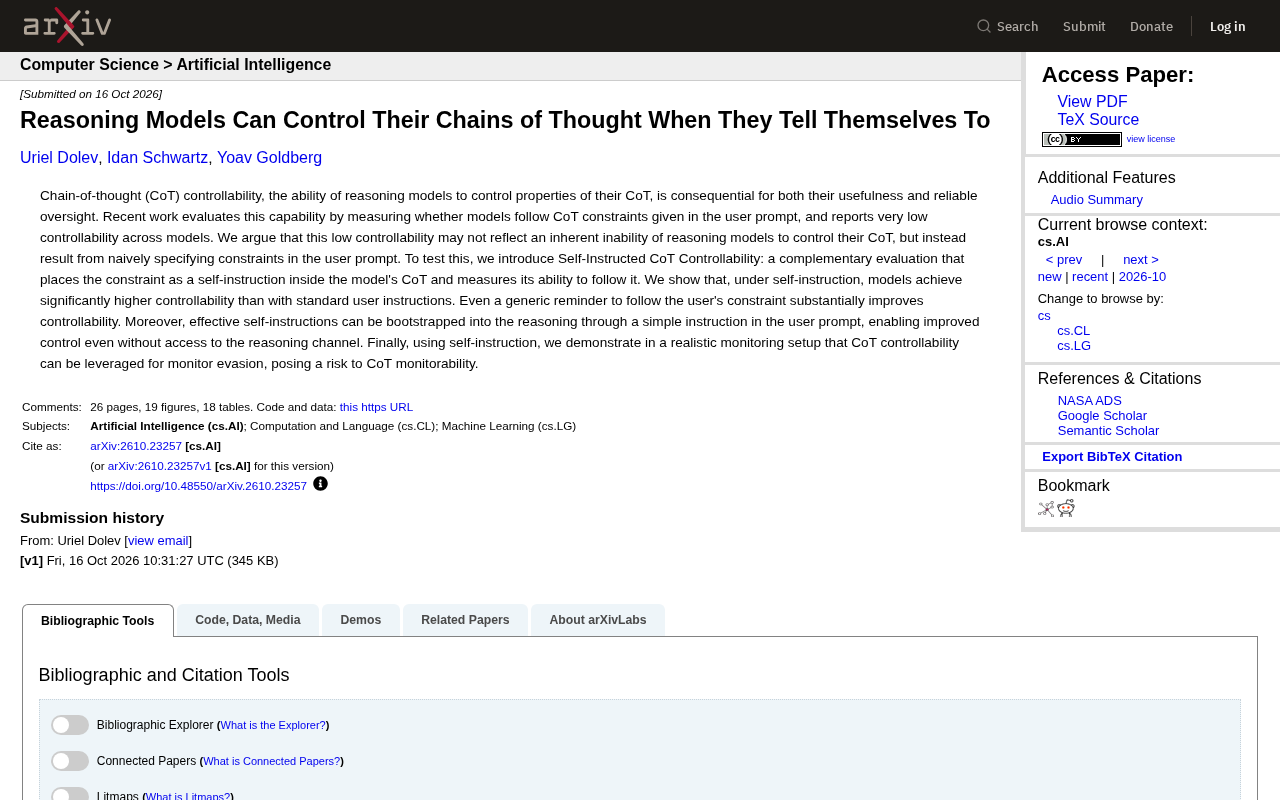
推理模型能控制思维链:关键在自我指令而非用户提示
新研究提出自我指令CoT可控性评估方法,发现推理模型在思维链内部设定约束时可控性显著提升,并揭示该能力可用于监控规避,对AI安全评估方法提出挑战。

DeepSeek V4.1 Flash「小更新」实测:基准全面上涨,性价比重塑推理市场
DeepSeek V4.1 Flash 1017 被称为小更新,但 Terminal Bench 4.0 成绩五周内从31%升至42%,单任务成本约20美分,输出价约为GPT 5.6 Sol的十六分之一,思考token减少约三分之一,并同步推出千次75美分的搜索API与开源权重。

推理模型隐藏Token如何让云账单飙升8倍?
推理模型每次API调用隐藏生成数千思维链token,按输出高价计费导致云账单飙升8倍。本文剖析三大架构陷阱,并给出预算路由与硬性token上限的FinOps解决方案,附实测成本对比数据。

Meta发布Muse Wonder:六档推理等级,性能对标GPT-6.1 Sol
Meta发布Muse Wonder与Muse Wonder Full,内置minimal到max六档推理等级。Artificial Analysis评测其Max档对标GPT-6.1 Sol,但定价、上下文窗口与上线时间均未公布。

推理模型何时值得付费?三条判断标准帮你决策
推理模型何时值得付费?本文基于Dan Klein在Chain of Thought播客中的观点,提炼出三条判断标准:检查器是否存在、延迟预算是否允许、思考token成本是否低于答错成本,并给出路由代码草图和评分卡实践方案。

推理模型的真相:不是更聪明,只是更慢更贵
推理模型不是更聪明,只是更慢更贵。一线工程团队实测显示:延迟是快速模型的3-10倍,成本最高差30倍,仅约15%的企业提示词真正受益。本文提供推理模型与快速模型的路由指南,涵盖升级策略、成本对照表和延迟预算方法。",

AI推理突破:DeepSeek-R1与OpenAI的逻辑跃迁
大语言模型正从概率预测转向结构化推理。本文解析OpenAI思维链方法与DeepSeek-R1的强化学习机制,探讨推理能力如何重塑LLM角色定位,以及开源与多模态对推理普及的推动。

从直觉到推理:LRM与传统LLM的范式之变
大推理模型(LRM)与传统大语言模型(LLM)的本质区别不在工具调用,而在从转导范式到归纳范式的转变。本文解析测试时归纳、流动智能及ARC基准上的关键数据对比。

System 1 与 System 2 AI模型到底差在哪?
System 1与System 2 AI模型有什么区别?本文用通俗比喻解析一次推理模型与循环推理模型的本质差异,并给出"数步数"的实用选型标准,帮你判断什么任务该用哪类模型。

从零构建推理模型:Sebastian课程第1讲的动机与环境配置
Sebastian Raschka《从零构建推理模型》系列第1讲精讲:梳理从传统LLM到推理模型再到智能体框架的演进脉络,解读from scratch教学价值,并提供基于UV的PyTorch环境配置与GPU使用建议。
 科技前沿
Claude Opus 4.8思考力度校准解析:AI推理模型的关键优化方向
Anthropic发布Claude Opus 4.8,重点优化思考力度校准能力。本文深入解析什么是思考力度校准、为何它对AI推理模型至关重要,以及这一技术方向对行业竞争格局的深远影响。
 行业洞察
o1模型逆袭之路:从被严重低估到改变AI推理历史
回顾OpenAI o1模型发布18个月后的惊人逆袭:从被质疑过度炒作,到突破数学推理瓶颈、解决奥林匹克级难题。深度解析o1为何被低估,以及链式思考推理范式如何重塑AI能力边界。