System 1 与 System 2 AI模型到底差在哪?

用「数步数」判断任务结构,是选择System 1直出模型还是System 2推理模型的核心标准。
文章以心理学中的 System 1(快速直觉)与 System 2(缓慢推理)为框架,解释了两类 AI 模型的本质差异:System 1 模型对输入做一次前向传播直接输出答案,System 2 模型则在循环中反复将中间结果写入"草稿纸"再读回,逐步逼近答案。关键分水岭在于推理链条的长度——链条越长,System 1 的准确率越趋向崩溃,而 System 2 几乎不受影响。但 System 1 并非更弱,对分类、判断等单步任务反而更快更省。文章给出一个实用选型标准:数答案所需步数,一步可答用 System 1,多步推导用 System 2,两者是针对不同任务结构的工具,而非强弱替代关系。
两种思考方式,两类AI模型
自从推理模型(reasoning models)走红,"System 1"和"System 2"这组概念就频繁出现在各种AI讨论里。它们借用了心理学中对人类思维的经典划分:System 1 是快速、直觉、一步到位的反应;System 2 是缓慢、刻意、分步推理的过程。放到大模型身上,这个比喻意外地贴切。
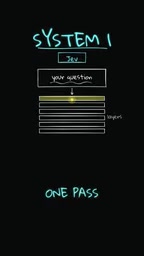
一个 System 1 模型面对你的问题,只看一眼,让输入在网络里走一遍(one pass),答案就直接出来了。没有中间草稿,没有反复推敲,输入进去、输出出来,干净利落。
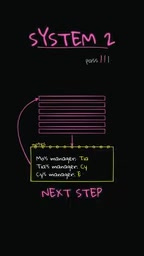
而 System 2 模型,本质上是同一个"大脑"在循环里反复运行。它配了一块"草稿纸"(scratch pad):每走一遍,它写下一条笔记,再把笔记读回去,然后基于这条中间结果走下一步。这个"写笔记—读笔记—再推进"的循环,就是我们现在常说的"思考过程"。
「System 1 / System 2」这一框架最早由心理学家丹尼尔·卡尼曼(Daniel Kahneman)在其著作《思考,快与慢》(Thinking, Fast and Slow,2011)中系统阐述。System 1 对应人脑的无意识、自动化处理——比如看到「2+2」立刻想到「4」;System 2 对应需要刻意调用注意力的慢速推理——比如心算「17×24」时逐步分解计算。将这一框架迁移到大模型时需要注意:原版 Transformer 的每次前向传播(forward pass)在计算深度上是固定的,无法动态延长,因此天然对应 System 1;而推理模型(如 OpenAI o 系列、DeepSeek广告-R1)通过在输出中生成隐式「思维链」(chain-of-thought tokens)并将其作为后续生成的上下文,等效实现了多轮迭代,从而逼近 System 2 的行为。
链条变长时,差距才显现
关键的分水岭出现在任务的推理链条(chain)变长的时候。
当需要串联的步骤越来越多时,System 1 模型会"掉下悬崖"——准确率急剧崩溃。因为它只有一次机会,无法把前一步的结果留存下来喂给后一步,一旦问题需要多级推导,单次前向传播根本承载不了这么多中间状态。
相比之下,具备循环推理能力的 System 2(thinking models)几乎纹丝不动。它能把每一步的中间结论显式地记录在草稿纸上,再一步步逼近最终答案。链条越长,这种"把问题拆成多步、逐步求解"的能力优势就越明显。
这其实揭示了推理模型为什么在数学、代码、复杂逻辑题上表现突出:这类任务的答案天然不可能"一眼看出",必须依赖中间结果层层递进。
这里的「一次前向传播承载不了多级推导」有其深层的计算原因。Transformer 的网络深度(层数)是固定的,每次推理经过相同数量的层后直接输出。当问题需要的推理步骤数超过网络深度能隐式压缩的上限时,模型只能依赖参数中记忆的「模式匹配」,而无法真正执行新的计算步骤。思维链(Chain-of-Thought,CoT)技术的核心洞察正在于此:把中间步骤显式写到输出 token 序列中,每个 token 的生成都可以「看到」前面所有已生成的中间结果,相当于用序列长度换取了原本缺失的计算深度。这也解释了为什么 CoT prompting 即便对普通模型也能提升复杂任务表现——它让 System 1 的底层引擎做出了类 System 2 的行为,代价是更多的输出 token 和更高的延迟。
System 1 并没有更差
一个常见的误解是:既然 System 2 在复杂任务上更强,那是不是意味着 System 1 已经过时、更弱?
答案是否定的。链条变长让 System 1 崩溃,并不等于 System 1 本身更差——它只是不适合那类任务。
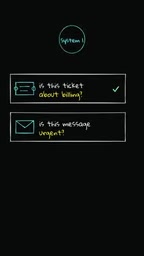
想想这些问题:这张工单是关于账单的吗?这条消息紧急吗?这类分类、判断型任务,看一眼就有答案,根本不需要分步推理。此时让 System 2 去反复"写笔记、读笔记",不仅毫无必要,还会白白增加延迟和成本。对这些场景来说,System 1 的一次性直出反而是最优解。
一个实用的判断标准:数步数
那么在实际选型时,怎么判断该用哪一类模型?视频给出了一个相当朴素但好用的心智模型——数一数答案需要几步。
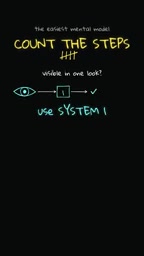
- 如果答案"一眼可见"(visible in one look),只需单步就能得出,那么 System 1 就足够了,又快又省。
- 如果答案需要多个步骤,也就是说你必须先得到若干个中间结果,才能推导出最终结果,那就需要 System 2 模型来胜任。
这个标准的好处在于,它把一个看似玄乎的"模型选型"问题,还原成了对任务本身结构的分析:你要解决的问题,到底是"一步可答"还是"多步可答"?
对实际应用的启示
理解这组区别,对构建AI应用有直接价值。盲目追求"更强的推理模型"并不总是对的——如果你的产品大量处理的是意图识别、情绪判断、内容分类这类单步任务,System 1 模型能用更低的延迟和成本把活儿干好;而当任务涉及多轮规划、复杂数学推导或长链条逻辑时,推理模型的循环机制才真正物有所值。
换句话说,System 1 和 System 2 不是"旧与新""弱与强"的替代关系,而是针对不同任务结构的两种工具。认清手上的任务需要几步,比盲目堆推理能力更重要。
从工程落地角度,选型决策还涉及成本与延迟的量化权衡。推理模型通常会生成大量「思考 token」(有时达到数千个),这些 token 同样计入 API 用量,在高并发场景下成本可以是普通模型的数倍乃至数十倍。因此一个常见的实践模式是「级联路由」(cascade routing):先用一个轻量分类器判断传入请求是单步任务还是多步任务,再分别路由到 System 1 或 System 2 模型。这样既保留了复杂任务的推理能力,又避免将廉价的分类请求送入昂贵的推理模型。理解文章所述的「数步数」判断标准,正是设计此类路由规则的概念基础。
相关推荐
LZ4:极速压缩算法的开源标杆
探索 LZ4 极速压缩算法:了解其设计哲学、性能优势以及在 Linux 内核、数据库等领域的广泛应用。12k+ Star 的开源项目如何成为速度标杆。
Agent-Browser:AI智能体的浏览器自动化CLI
Vercel Labs 开源 agent-browser,一个用 Rust 构建、专为 AI 智能体设计的浏览器自动化 CLI 工具,GitHub 星标超 4.5 万,提供命令行优先的浏览器操控能力。
全球首家人形机器人公司Agility登陆纳斯达克,买不买?
Agility以全球首家人形机器人上市公司身份登陆纳斯达克,本文分析这一标志性事件对行业与投资者的意义,拆解纯人形机器人赛道的商业化考题与投资判断框架。