零样本可视化:用自然语言定义坐标轴探索文本语料库

新研究提出零样本可视化(ZSV),让用户用自然语言定义概念坐标轴,并发现基于下一词概率的打分最具实用价值。
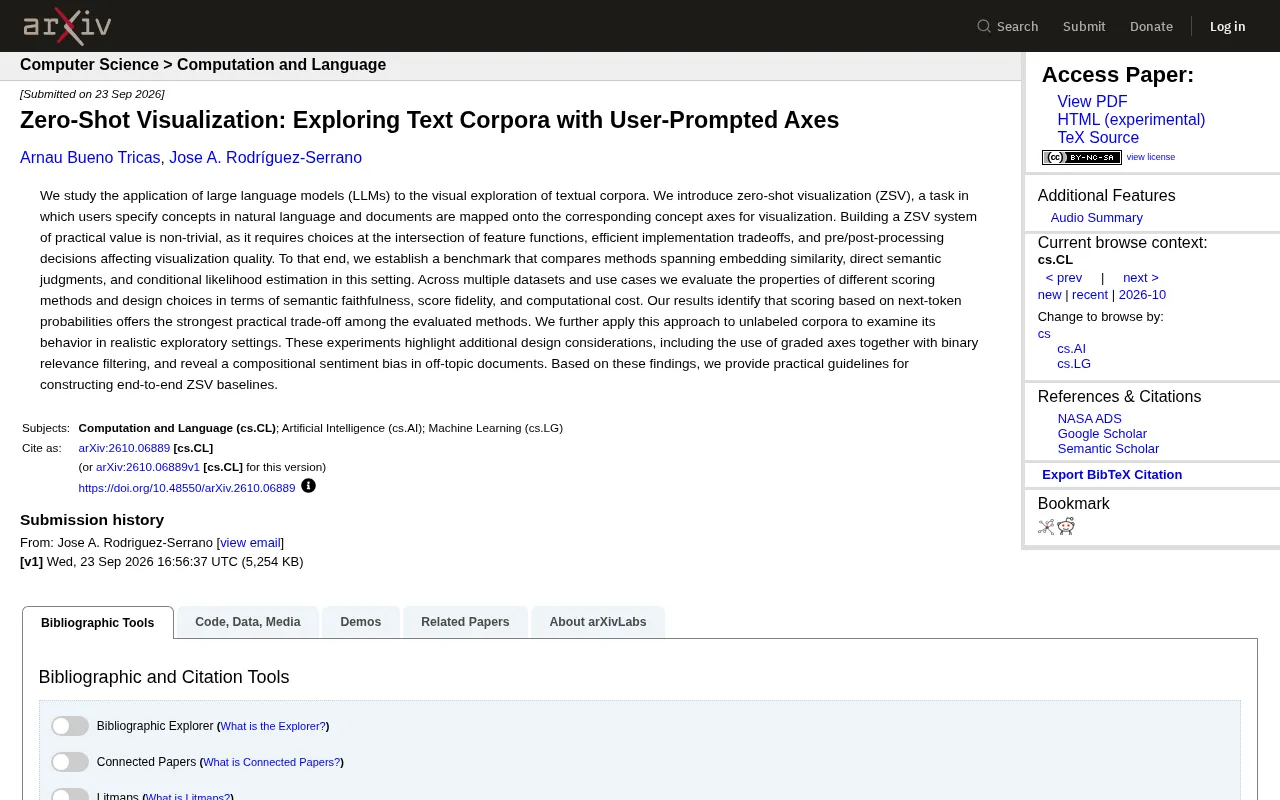
这篇 arXiv 论文提出「零样本可视化」(ZSV)任务,将大语言模型的语义理解能力引入文本语料的可视化探索:用户用自然语言描述概念,系统将语料中每篇文档映射到对应的概念坐标轴上,无需预定义指标或人工标注。研究系统对比了嵌入相似度、直接语义判断、条件似然估计三类打分方法,发现基于「下一词概率」的打分在语义忠实度、分数保真度与计算成本之间取得最佳权衡。实际应用中,梯度坐标轴与二元相关性过滤相结合能有效提升质量,同时需警惕无关文档上出现的「组合情感偏差」。论文最终给出了构建端到端 ZSV 基线系统的实用指南,为 LLM 作为「语义尺度提供者」参与数据探索这一趋势奠定了方法论基础。
当文本探索遇上大语言模型
面对海量文本语料,研究者和分析师常常需要一套工具来快速把握整体结构、发现隐藏模式。传统的可视化方法往往依赖预先定义的指标或人工标注,灵活性有限。一项发表于 arXiv 的新研究提出了「零样本可视化」(Zero-Shot Visualization,简称 ZSV)这一任务,试图把大语言模型(LLM)的语义理解能力引入文本语料的视觉探索中。
其核心思路直观而有力:用户用自然语言描述想要考察的概念,系统随即将语料库中的每篇文档映射到相应的「概念坐标轴」上,从而生成可视化图景。换句话说,坐标轴不再是固定的,而是由用户在使用时临时「提示」出来的。这种交互方式让探索过程更贴近人的认知意图。
构建一个实用的 ZSV 系统并不简单
论文坦言,要让 ZSV 真正具备实用价值,难度不小。它涉及多个层面的权衡:如何设计特征函数(feature function)、如何在计算效率上做取舍,以及前处理和后处理的决策如何影响最终的可视化质量。这些环节相互交织,任何一个选择失当都可能让结果失真或成本飙升。
为了系统性地回答这些问题,研究者建立了一个基准测试(benchmark),对比了三类主流的打分方法:
- 嵌入相似度(embedding similarity):通过向量空间中的距离衡量文档与概念的相关程度;
- 直接语义判断(direct semantic judgments):让模型直接对文档与概念的关系给出判断;
- 条件似然估计(conditional likelihood estimation):基于模型生成概率来评估相关性。
评估维度覆盖了语义忠实度(semantic faithfulness)、分数保真度(score fidelity)以及计算成本三大指标,并在多个数据集和使用场景中展开验证。
嵌入相似度的原理是将文档和概念描述分别编码为高维向量,通过余弦相似度等度量来判断二者的语义接近程度。这类方法依赖预训练的句子编码器(如 Sentence-BERT、text-embedding-ada-002 等),优点是推理速度快、可批量处理,缺点是向量空间的几何结构不一定与人类直觉中的「概念相关性」完全对齐,细粒度的语义区别容易被压缩。条件似然估计则不同——它让语言模型计算「在给定文档上下文的条件下,概念相关词汇出现的概率」,从而得到一个连续分数。这一思路利用了语言模型本身对语言规律的建模能力,理论上能捕捉更丰富的语义关系,但每次推理都需要调用模型前向传播,计算开销相对较大。理解这三类方法的原理差异,有助于把握论文后续实验结论的来龙去脉。
基于下一词概率的打分胜出
研究得到的一个关键结论是:基于「下一词概率」(next-token probabilities)的打分方法,在所有被评估的方法中提供了最强的实用权衡。它既能保持较好的语义准确性,又在计算开销上相对可控。
这个发现颇具参考价值。相比单纯依赖嵌入相似度(可能丢失细粒度语义)或直接让模型做二元判断(难以表达程度差异),利用条件概率输出的连续分数能更自然地反映文档在概念轴上的「位置」,为可视化提供更丰富的梯度信息。
真实场景下的新发现
研究者进一步把该方法应用到未标注语料上,观察其在真实探索场景中的表现。这一步揭示了若干此前容易被忽视的设计考量。
其一,梯度坐标轴(graded axes)与二元相关性过滤相结合的做法效果更好。先用二元判断过滤掉明显无关的文档,再用连续分数对剩余文档进行细粒度排布,可以减少噪声干扰。
其二,研究者发现了一个有趣的**组合情感偏差(compositional sentiment bias)**现象——在那些与查询主题无关(off-topic)的文档上,模型的打分会表现出系统性的情感倾向偏移。这类偏差如果不加识别,可能误导用户对语料的整体判断,是构建 ZSV 系统时需要警惕的陷阱。
**组合情感偏差(compositional sentiment bias)**是一种值得深入理解的系统性误差。其产生机制可能与语言模型的预训练数据分布有关:当查询概念本身带有情感色彩(如「社会公正」「企业丑闻」),模型在评分时可能无法完全将「主题相关性」与「情感倾向」解耦。对于那些实际上与查询主题无关的文档,模型并非随机打分,而是倾向于给情感极性与查询概念匹配的文档打出虚高分数。这意味着,如果语料库中恰好有大量在情绪基调上与查询相似但内容无关的文档,可视化结果可能会系统性地将它们聚集在「相关」区域,造成误导。识别并校正这类偏差,是提升 ZSV 可信度的重要工程挑战。
给实践者的指南
基于上述实验,论文最终给出了构建端到端 ZSV 基线系统的实用指南。对于希望利用 LLM 做文本探索的工程师和研究者而言,这些结论提供了明确的起点:优先考虑基于下一词概率的打分策略,结合梯度轴与二元过滤的混合设计,并对无关文档可能引入的情感偏差保持审慎。
从更宏观的角度看,ZSV 代表了一种值得关注的趋势——让大模型不仅充当「回答者」,更成为数据探索过程中的「语义尺度提供者」。当用户可以随时用一句话定义新的分析维度,文本分析的门槛和灵活性都将发生改变。这项工作为该方向奠定了方法论基础,也为后续研究留下了诸多可延伸的空间。
相关推荐

免费白嫖Gemini 4与Claude Sonnet 5.5?实测Free.pi教程
实测Free.pi平台免费调用Gemini 4 Argon与Claude Sonnet 5.5的完整流程,包括CLI安装、GitHub登录获取每日15000积分、模型切换与代码任务测试,并分析免费通道的潜在限制。

Microduck:用Rust打造的双足机器鸭,GitHub一日斩获421星
Pollen Robotics开源项目microduck:一个用Rust编写的微型双足机器鸭,GitHub单日新增421星,总星数超1万。本文解析其技术栈、双足行走控制原理及对机器人学习者的价值。

2.2万Star的电子书宝库:一个GitHub仓库如何聚合四大读书App资源
GitHub项目ebook-treasure-chest获2.2万Star,聚合帆书、微信读书、京东读书、喜马拉雅等读书App电子书下载链接。本文分析其价值、链接失效风险与版权边界,探讨资源聚合类开源项目的可持续性。