Linkly AI Clipper:把网页存成AI Agent友好的Markdown

Linkly AI Clipper 用浏览器扩展把网页一键转成 Agent 友好的结构化 Markdown。
Linkly AI Clipper 是一款 Chrome 扩展,点击图标即可把当前网页转换为格式规整的 Markdown,并在侧边栏中预览、复制或下载。它的核心卖点不是笔记管理,而是“Agent-friendly”:剔除广告与导航等噪音、保留标题层级和代码块等结构、提升 token 效率,让网页内容能直接作为大模型上下文、RAG 语料或 Agent 工具调用的输入。产品走轻量单点路线,不做云端同步和批量抓取,适合零散采集而非系统性语料工程。它在 Product Hunt 发布首日获 67 票、排名 #16,仍属小众尝鲜阶段,但踩中了“网页可读性标准正被 Agent 重新定义”这一趋势。
为什么需要"AI友好"的网页剪藏工具
用大模型处理网页内容时,最麻烦的往往不是模型本身,而是把网页“喂”进去的过程:广告、导航栏、脚本残留混在正文里,token 被大量噪音消耗,模型还容易抓错重点。Linkly AI Clipper 想解决的正是这一环——用浏览器扩展把当前页面一键转成干净、结构化的 Markdown,直接供 AI Agent 使用。
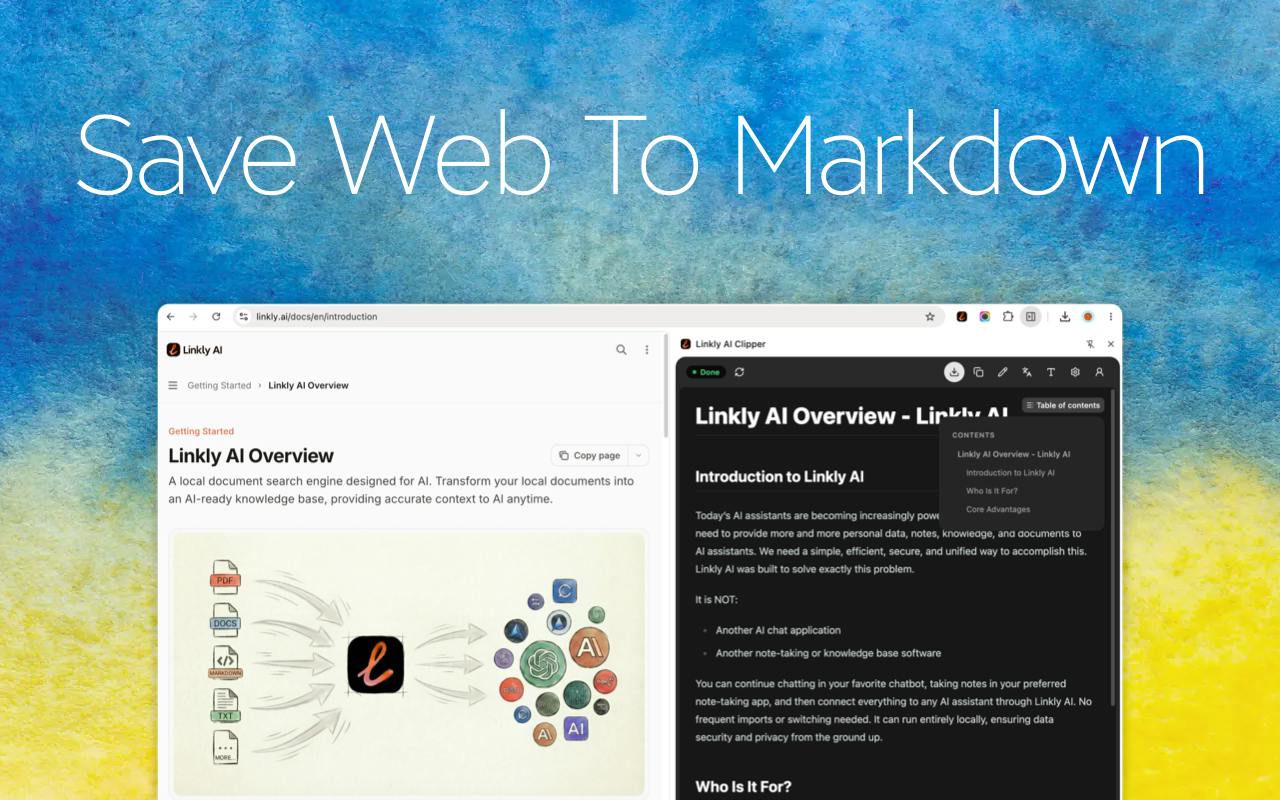
它在 Product Hunt 上以“Save web as an Agent-friendly Markdown browser extension”为标语发布,定位是 Chrome 扩展,归属于效率与笔记类工具,发布当天获得 67 票、3 条评论,排名 #16。从数据看它并非爆款,但这个方向本身值得关注:当 AI Agent 成为内容消费的新主体,网页的“可读性”标准正在被重新定义。
Token 效率指模型输入中有效信息所占的比例。网页原始 HTML 里通常混有大量导航、脚本、样式和广告代码,一次请求可能因此消耗数万 token,其中真正有用的正文只占小部分。由于主流大模型按 token 计费并有上下文窗口上限,噪音不仅推高成本,还会稀释关键信息、降低模型对重点的定位能力。把网页先转成只保留正文与必要结构的 Markdown,本质上是在做输入侧的“降噪压缩”,让同样长度的上下文携带更多有效语义。
产品形态:侧边栏里的一键转换
Linkly AI Clipper 的交互被压缩到了极简:点击扩展图标,当前页面即被转换为格式规整的 Markdown,结果显示在浏览器侧边栏中。用户可以在侧边栏里预览效果,再决定复制到剪贴板还是下载为文件。
这种“预览—复制—下载”的三段式设计,对应了三类典型场景:临时把一段内容贴进对话窗口、把整页资料沉淀到本地知识库、以及把网页作为上下文交给自动化流程处理。官方强调的三个关键词是简单、轻量,以及所有保存内容都针对 AI Agent 做过优化——也就是说,输出的不是给人看的网页快照,而是给模型读的结构化文本。
"Agent-friendly"到底意味着什么
这个标语里的关键词值得拆开看。对 AI Agent 而言,一份理想的网页输入至少要满足几个条件:正文与噪音分离、标题层级保留、链接与代码块等结构不丢失、以及 token 效率足够高。Markdown 恰好是这几项要求的交集——它比 HTML 轻得多,又比纯文本保留了必要的结构信息。
Linkly AI Clipper 把“优化给 Agent 用”作为核心卖点,意味着它在转换时会倾向于剔除导航、广告等非正文元素,保留语义结构。对于需要把网页内容作为 RAG 语料、Agent 工具调用结果或提示词上下文的用户来说,这比传统的“网页另存为”或手工复制粘贴要可靠得多。
你可能没注意到,市面上的网页剪藏工具大多面向人类阅读与笔记整理,输出格式以富文本或自有笔记格式为主。明确以 Agent 消费为第一目标的剪藏工具仍属少数,Linkly AI Clipper 踩中的是一个正在成形的小众需求。
RAG(检索增强生成) 是一种让模型在回答前先检索外部资料的技术路径:把文档切分成片段、向量化后存入索引,提问时召回相关片段拼进提示词。它对立面是纯靠模型参数里的记忆作答。RAG 的上游是语料质量——如果原始网页带着导航菜单、版权声明和推荐位被切块入库,检索阶段就容易被这些无关片段干扰,生成答案也随之跑偏。因此面向 RAG 的采集环节普遍强调正文抽取与结构保留,干净的 Markdown 片段既便于按标题层级切分,也能让引用溯源更清晰。
Agent 工具调用指大模型在运行过程中主动调用外部函数或接口来获取信息、执行操作,而非仅凭一次提示词作答。例如 Agent 可以调用网页抓取工具读取某个链接,再把返回内容作为后续推理的上下文。这类场景对返回格式特别敏感:结构混乱的 HTML 会挤占上下文额度、增加解析失败率,而规整的 Markdown 更接近模型训练时见过的大量文档格式,解析和定位都更稳定。这也是“给 Agent 读的网页格式”逐渐独立于“给人看的网页格式”的原因。
轻量路线的取舍
从产品信息看,Linkly AI Clipper 走的是单点工具路线:不做笔记管理、不做云端同步、不做复杂的模板系统,只把“网页转 Markdown”这件事做利落。对厌倦了重型知识管理套件的用户,这种克制反而是优点——安装即用,没有学习成本。
代价也很明显。缺少批量抓取、站点级规则定制、输出格式微调等能力,意味着它更适合零散的内容采集,而非系统性的语料工程建设。发布首日 67 票、3 条评论的热度,也说明它目前还处在小众尝鲜阶段,产品成熟度和生态积累有待观察。
谁适合用它
第一类是经常与大模型对话的内容工作者:把参考资料一键转成 Markdown 再粘贴,比直接丢链接更可控,也避免了模型抓取网页时的信息丢失。第二类是搭建个人知识库或 RAG 流水线的开发者:干净的 Markdown 是优质的原始语料。第三类是需要在 Agent 工作流中注入网页上下文的自动化玩家。
反过来,如果你需要的是完整的网页存档、图文混排笔记或团队协作空间,这个工具并不对口。它是一个锋利的小刀,不是瑞士军刀。
小结
Linkly AI Clipper 的价值不在于功能有多复杂,而在于它把一个正在变得重要的细节做成了产品:网页内容进入 AI 世界之前,需要一次格式上的“翻译”。随着 Agent 越来越多地代替人浏览和消化信息,这类面向机器可读性的轻量工具,可能会比面向人类阅读的剪藏工具更常见。
相关推荐
Anthropic新模型Fable 5.2实测:性能超Opus 5.5
Anthropic 发布 Fable 5.2,实测性能超越 Opus 5.5,单 token 更贵但单位任务成本更低。本文整理发布要点、公开基准、自建基准与三项实测,并给出模型选型建议。
OpenAI 谈数据中心公关危机与 AI 监管自我约束
OpenAI 高管访谈解读:AI 数据中心为何遭遇公关危机,以及 OpenAI 为何支持以「限速」框架监管递归自我改进,强调人类必须掌控 AI 技术。
ExecuTorch WebGPU:PyTorch模型直接在浏览器GPU上运行
PyTorch 发布 ExecuTorch WebGPU 支持,模型经 torch.export 导出为 .pte 文件后可直接在浏览器 GPU 上推理,无需转换为其他框架格式,兼顾本地隐私与低延迟部署。