llama.cpp引入提示查找草稿:推理加速最高42倍
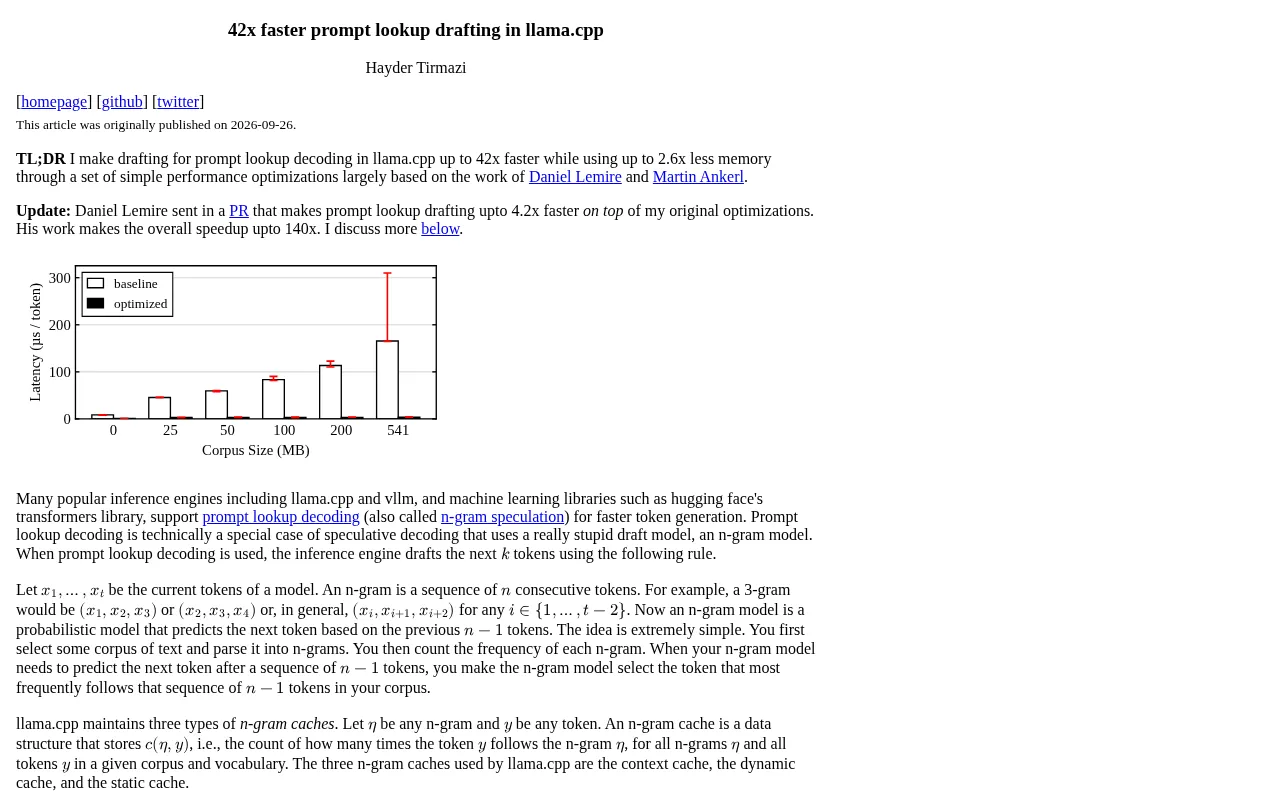
llama.cpp引入无需额外模型的提示查找草稿优化,在高重复任务中可实现最高42倍推理加速。
llama.cpp近期合并了「提示查找草稿」(Prompt Lookup Decoding)优化,这是投机解码技术的一种轻量化变体。与传统投机解码依赖独立草稿模型不同,该方法直接在输入提示和已生成文本中匹配重复的n-gram片段作为候选token,主模型只需并行验证而无需逐token生成,从而利用Transformer并行验证的效率优势大幅提升吞吐量。在代码编辑、RAG、文档摘要等输出内容高度复用输入文本的场景中,其候选接受率极高,峰值加速可达42倍。由于无需加载额外模型、不增加显存占用,该方法与llama.cpp面向消费级硬件的轻量化定位高度契合。不过,42倍属于极端场景下的峰值表现,自由写作、开放问答等低重复任务中收益有限,建议开发者在自身工作流中实测后再做判断。
概述
开源本地大模型推理项目 llama.cpp 近期出现了一项关于「提示查找草稿」(prompt lookup drafting)的优化,据相关讨论称其在特定场景下可带来最高达 42 倍的加速效果。这一话题在 Hacker News 上引发了社区关注,成为本地推理性能优化领域的一个值得留意的进展。
需要说明的是,本文所依据的原始素材信息量有限,仅包含标题与少量社区讨论数据,因此以下内容侧重于对该技术方向的背景解读,帮助读者理解「提示查找草稿」这类优化的原理与意义。
什么是提示查找草稿
提示查找草稿(prompt lookup decoding / prompt lookup drafting)是投机解码(speculative decoding)家族中的一种轻量化方法。传统投机解码需要一个额外的小模型充当「草稿模型」,先快速生成若干候选 token,再由主模型一次性验证,从而减少大模型逐 token 生成的开销。
提示查找草稿的巧妙之处在于:它不需要额外的草稿模型,而是直接从输入提示(prompt)和已生成文本中查找可能重复出现的 n-gram 片段作为候选。这在存在大量文本重复的任务中格外有效,例如代码编辑、文档摘要、检索增强生成(RAG)以及结构化输出等场景,因为模型的输出往往会大段复用输入中的内容。
投机解码(Speculative Decoding)最早由 Google 研究人员在2023年正式提出,核心思路是利用「生成廉价、验证便宜」的非对称性:由小模型(draft model)一次性生成 K 个候选 token,再由大模型并行验证整个序列——由于 Transformer 的注意力机制天然支持并行前向传播,验证 K 个 token 的计算量远小于逐个自回归生成 K 次。只要草稿模型的接受率足够高,整体吞吐量就能显著提升。提示查找草稿(Prompt Lookup Decoding)是这一框架的无参数变体:它用确定性的字符串匹配替代神经网络草稿模型,直接在已有上下文中检索长度为 n 的 n-gram,将其后续若干 token 作为候选草稿。这一设计的代价是:候选质量完全取决于输入文本的自相似程度,对于低重复任务几乎退化为普通自回归解码。
为什么能达到数十倍加速
所谓「42 倍加速」通常出现在高度重复的极端场景中,而非通用文本生成的普遍表现。其加速逻辑在于:当模型需要输出的内容与提示中的某段文本高度一致时,查找机制可以一次性命中多个连续 token,主模型只需验证而无需逐个采样生成。
对本地推理而言,这类优化的吸引力在于它几乎零成本——无需加载第二个模型、不额外占用显存,仅依赖对上下文的字符串匹配。因此它特别适合在 llama.cpp 这样面向消费级硬件、强调轻量与可移植性的项目中落地。
不过,需要理性看待这个数字。加速倍数强烈依赖任务类型:在缺乏重复模式的自由创作、开放问答等任务中,命中率低,收益会显著下降,甚至因验证开销略有损耗。因此「最高 42 倍」更应理解为特定基准下的峰值,而非日常使用的普遍值。
理解加速倍数需要区分两个指标:token 接受率(draft acceptance rate)与端到端延迟加速比。接受率指草稿候选被大模型接受的比例;而端到端加速比还受显存带宽、批大小、验证开销等工程因素影响。在本地单卡推理场景下,瓶颈通常是显存带宽(memory-bound),每次自回归步骤都需要完整地将模型权重从显存搬运到计算单元。当一次验证可以同时确认多个草稿 token 时,每个 token 的平均显存读取次数大幅降低,这正是加速的物理来源。极端情况下(如复制粘贴式的输出),草稿长度可达数十 token 且全部被接受,使单次前向传播等效于生成十数甚至数十个 token,故峰值加速比可达数十倍。在算力受限(compute-bound)的场景或批量推理中,这一收益会被稀释。
对本地大模型生态的意义
llama.cpp 一直是本地化、离线运行大模型的核心基础设施之一,其在量化、跨平台部署和推理性能上的持续演进,直接影响着大量开发者与个人用户的使用体验。将提示查找草稿这类免草稿模型的投机解码纳入其中,意味着普通用户在代码补全、文档处理等实用场景中可能获得明显的响应提速。
从工程视角看,这类优化体现了本地推理社区的一个趋势:在有限的硬件资源下,通过算法层面的巧思而非单纯堆算力来榨取性能。相比依赖更大显存或更强 GPU,查找类草稿方法几乎不增加资源负担,对边缘设备与个人电脑尤为友好。
llama.cpp 由 Georgi Gerganov 于2023年初发起,最初以纯 C/C++ 在 MacBook 上运行 LLaMA 模型而引发广泛关注。项目的核心设计理念是零依赖、跨平台、极致轻量:通过 GGUF 格式的模型量化(支持 2-bit 至 8-bit 等多种精度),使数十亿参数的模型能够在消费级笔记本甚至 CPU 上运行。正因如此,llama.cpp 对任何需要额外显存或独立进程的优化方案天然存在阻力——传统投机解码要求同时加载两个模型,在内存已捉襟见肘的边缘设备上几乎不可行。提示查找草稿绕开了这一限制,与 llama.cpp 的设计哲学高度契合,这也是它能够以相对简洁的 PR 形式快速合并进主线的重要原因。
理性看待与后续观察
目前该讨论在社区中的热度尚属早期(Hacker News 上仅有较少的投票与评论),具体实现细节、适用范围与稳定性仍有待更多实测验证。对关注本地推理的开发者而言,建议关注 llama.cpp 官方仓库的相关合并请求与基准测试数据,以了解该特性在不同模型与任务上的真实表现。
对普通用户来说,可以在自己的典型工作流(如代码相关任务)中实测开启该选项前后的差异,用真实数据判断收益,而不必被峰值数字所左右。
小结
提示查找草稿为 llama.cpp 提供了一条低成本的推理提速路径,其在重复性高的任务中潜力可观。作为投机解码的免模型变体,它契合本地推理对轻量化的核心诉求,值得持续关注其在实际部署中的表现。
相关推荐
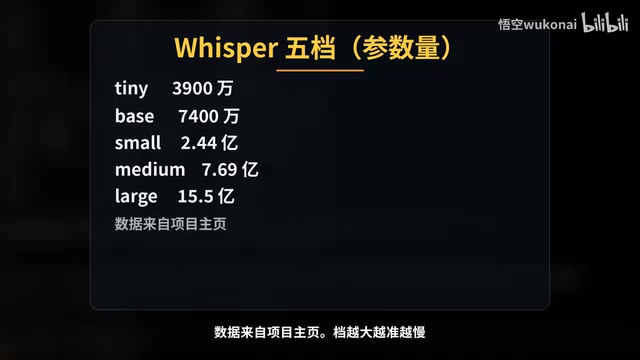
Claude Code实战:零代码搭建切片工厂,长视频自动变竖屏短视频
B站UP主悟空用Claude Code零代码搭建切片工厂,将35分钟长视频自动切成10条竖屏短视频。从Plan Mode、Whisper转写、claude.md规则、Hook质检到Subagent审核和Plugin分发,完整实战流程与实测数据。
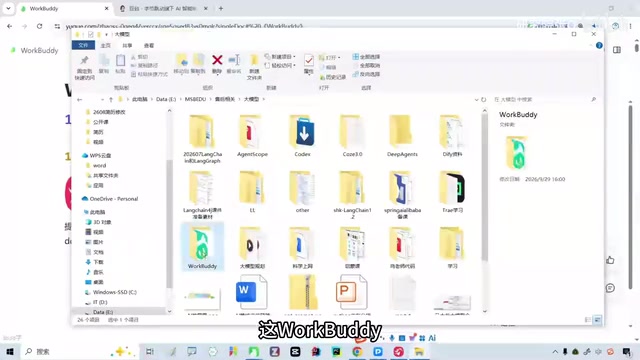
WorkBuddy保姆级教程:AI Agent如何帮你自动转文件
WorkBuddy保姆级教程实战:从豆包只能给方案到AI Agent直接动手,三分钟批量转换PDF并归档。含安装、积分机制、与Codex对比及上手建议。
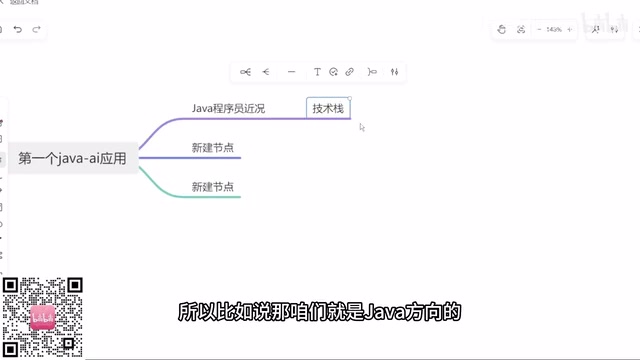
零基础入门Java+DeepSeek实战:程序员转型AI大模型开发指南
本文基于B站直播教学,详解Java程序员如何零基础转型AI大模型开发,涵盖技能路径、实战构建第一个Java AI应用、简历包装与求职策略,助你抓住大模型时代机遇。