LLaMA-Factory实战:零代码微调大模型全流程

介绍LLaMA-Factory零代码微调工具的能力、模型算法覆盖与CUDA环境搭建流程。
文章梳理了大模型微调工具LLaMA-Factory的入门路径。LLaMA-Factory是GitHub Star达60.1K的开源微调平台,被英伟达、阿里云、亚马逊等大厂使用,通过Web UI或命令行实现零代码微调,支持LLaMA、千问、百川、ChatGLM、MoE及多模态LLaVA等上百种模型,并整合了增量预训练、SFT、奖励模型、PPO、DPO、KTO、ORPO等主流算法。在部署方式上,由于个人电脑GPU算力有限,教程建议多数学习者租赁云服务器。安装的首要步骤是配置CUDA环境,它是调用GPU资源的基础,常被新手忽略而导致训练报错。文章强调掌握这类工具是大模型工程师进入微调领域的实用起点。
大模型工程师的成长路径通常分为两条:一是将大模型当作黑盒,基于API做应用开发;二是深入底层,对开源模型进行微调训练。后者需要理解参数调整的影响,门槛更高。而LLaMA-Factory这类工具的出现,让零代码微调成为可能。本文基于B站教程内容,梳理从工具认知到环境搭建的完整流程。
为什么你需要了解LLaMA-Factory
据B站UP主在教程中介绍,LLaMA-Factory是一个开源的大模型微调平台,GitHub Star数已达60.1K,被英伟达、阿里云广告、亚马逊等大厂使用。它的核心价值在于:将微调所需的各类框架和库整合成易用工具,让用户无需编写代码即可在本地完成上百种预训练模型的微调。
该项目最早由北航学生发起,后逐渐发展壮大,提供中文文档。使用方式有两种:Web UI客户端界面和命令行,两者均支持零代码操作。这大幅降低了训练大模型的门槛——传统方式需要调用Python库和框架,而LLaMA-Factory将这些底层细节封装了起来。
微调能做什么:算法与模型全覆盖
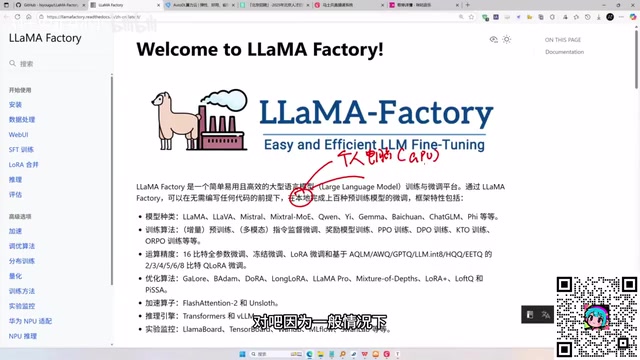
LLaMA-Factory支持的模型种类相当全面。据教程说明,它覆盖LLaMA系列、MoE多专家系统模型、多模态LLaVA模型,以及千问、百川、ChatGLM等知名中文模型。
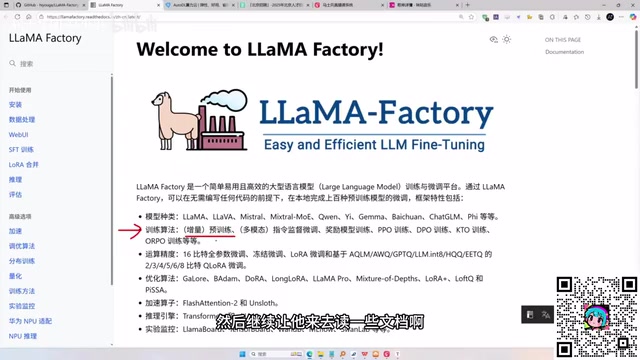
在训练算法方面,工具整合了增量预训练、指令监督微调(SFT)、奖励模型训练(Reward Model)、PPO、DPO、KTO、ORPO等主流方法。这意味着用户可以根据目标选择不同策略:想让模型继续“读”大量文档,就用增量预训练;想用指令数据集调整模型行为,就用SFT;想对齐人类偏好,则有RLHF系列算法可选。
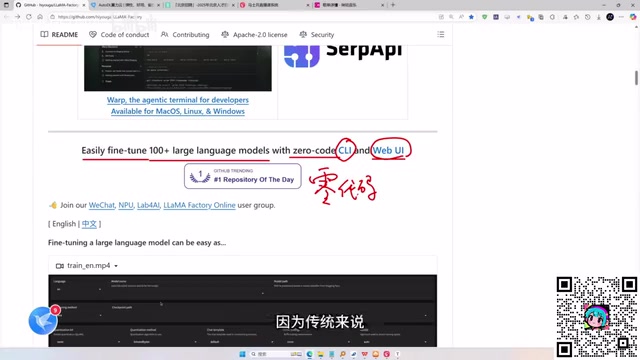
教程强调,这些算法无需从零实现,工具已做好封装。对于想快速验证想法或缺乏工程经验的开发者,这省去了大量底层编码工作。
增量预训练与SFT的关键区别在于数据形态与目标。增量预训练使用无标注的纯文本语料,让模型在原有知识基础上继续“学习”新领域(如法律、医疗、特定企业文档),训练目标仍是预测下一个token,本质是继续预训练;而SFT使用“指令-回答”配对数据,训练模型在收到指令时产出符合预期的回答,改变的是模型的行为模式而非知识储备。两者的数据构造、损失计算和超参设置差别很大,选错会导致效果不达预期。
RLHF 系列算法(PPO、DPO、KTO、ORPO)解决的是“对齐”问题:让模型输出更符合人类偏好,而不仅是模仿训练数据。PPO 需要单独训练奖励模型(Reward Model),再用强化学习优化策略,流程最复杂、显存开销最大;DPO 直接用偏好对(chosen/rejected)数据优化,省去奖励模型,是当前最流行的轻量方案;KTO 只需标注“好/坏”而非成对比较,数据门槛更低;ORPO 则把 SFT 与偏好对齐合并到一个阶段完成。理解这些差异有助于在有限算力下选择合适算法。
本地部署还是云服务器?先看GPU资源
“本地”在LLaMA-Factory语境下有两种含义:一是在个人电脑(如Windows系统)上搭建;二是租赁云服务器,在云端完成本地化部署。
教程指出,个人电脑的GPU资源通常有限,难以支撑大模型训练。因此,对于大部分学习者,租赁云服务器是更现实的选择。据UP主分析,个人显卡的算力往往不足以完成微调任务,而云服务器可按需提供GPU资源,成本可控。
无论选择哪种方式,安装前都需要确认CUDA环境。CUDA相当于调用GPU资源的驱动软件,Windows和Linux系统均需安装。教程在安装章节首先强调CUDA,正是因为后续所有训练都依赖GPU加速。
评估显存需求可参考一个粗略经验:全参数微调时,显存占用约为“参数量 × 16 字节”(含权重、梯度与优化器状态),即 7B 模型全参微调需上百 GB 显存,单卡难以承载;而采用 LoRA 等参数高效微调方法时,仅训练少量低秩适配器,7B 模型通常 16–24 GB 显存即可运行。因此消费级显卡(如 24 GB 显存的 RTX 4090)适合做 LoRA 微调与实验验证,全参微调则更适合多卡云服务器。另外,除显存外还应关注训练数据的规模与序列长度,长序列会显著放大显存占用。
安装第一步:搞定CUDA环境
教程中的安装流程以CUDA为起点。无论是Windows还是Linux,都需要先安装CUDA软件,才能让LLaMA-Factory调用底层GPU。这一步骤常被新手忽略,导致后续训练报错。
安装完成后,用户可通过Web UI或命令行启动微调任务。教程提到,官方文档提供中文支持,可跟随步骤逐步搭建。对于零基础学习者,建议先通读文档中的模型支持和算法说明,再动手操作。
从工具认知到环境准备,LLaMA-Factory将微调流程拆解为可操作的模块。后续的数据准备、训练参数配置和模型评估,则需要结合具体任务实践。对于想成为大模型工程师的开发者,掌握这类工具是进入微调领域的实用起点。
CUDA(Compute Unified Device Architecture)是 NVIDIA 推出的并行计算平台,它让 PyTorch 等深度学习框架能够把矩阵运算调度到 GPU 上执行。安装时需注意三点:一是 CUDA 版本必须与显卡驱动版本兼容,驱动过旧会导致安装失败;二是框架侧通常还依赖 cuDNN 等加速库,以及与 CUDA 版本严格匹配的 PyTorch 版本,三者版本错配是最常见的报错来源;三是安装后可用 nvidia-smi 查看驱动支持的最高 CUDA 版本,用 nvcc -V 查看已安装的 CUDA 版本。此外,多数云服务器镜像已预装好 CUDA 与驱动,租用时可优先选择带深度学习环境的镜像,省去手动配置环节。
相关推荐

曾鸣深度复盘:OpenAI为何难成终局赢家?公司制度将消亡
曾鸣在张晓骏商业访谈录中深度复盘AI终局:模型公司只是基础设施,OpenAI、Anthropic难成最终赢家;下一战役是Agent入口标准之争;公司制度将因AI重构而消亡,只有使命驱动的企业能穿越周期。

OpenHands v1.28.0:OpenCode与PI成内置Agent,密钥可对话申请
OpenHands 21天连推5个版本,v1.27.0将OpenCode与PI写入内置Agent列表,v1.28.0支持对话内申请密钥。本文梳理ACP协议接入方式、凭证复用规则、模型列表变更及升级建议。

SAVE America Act:严苛投票法案如何影响2100万美国人?
SAVE America Act要求公民每次登记投票时出示护照或出生证明。布伦南司法中心研究显示,超2100万美国人无法随时提供这些文件。本文解析法案核心条款、受影响人群及争议焦点。