llm-anthropic 0.31 支持 Claude Fable 5.2 与 Mythos 5.2

llm-anthropic 0.31 即时接入 Fable 5.2,鹈鹕测试暴露 max 档位预算耗尽无输出的回退问题。
Anthropic 发布 Fable 5.2 与 Mythos 5.2 当日,Simon Willison 即将 llm-anthropic 插件升级至 0.31,用户通过几行命令即可用新模型。Simon 沿用「骑自行车的鹈鹕」SVG 基准题,对 Fable 5.2 的五个推理档位逐一测试:xhigh 输出最佳,空间关系与结构基本正确;而 max 档位在消耗 128,000 token 思考后耗尽预算,未产出任何图像。该失效模式曾在 Opus 5.5 上出现,但对 Fable 系列尚属首次——Fable 5 与 5.1 在 max 档位均正常返回。文章据此指出,高推理档位不等于高质量输出,模型方需为思考耗尽提供兜底,使用者应基于实测选择档位并准备降级路径。
Anthropic 发布了 Fable 5.2 和 Mythos 5.2 两款新模型,Simon Willison 随即将其接入自己的 llm-anthropic 插件,版本号推进到 0.31。对习惯用命令行与 LLM 交互的开发者来说,这是一次几乎零延迟的模型上新——Anthropic 官方公告刚落地,插件侧就已经可以调用。
两行命令跑通新模型
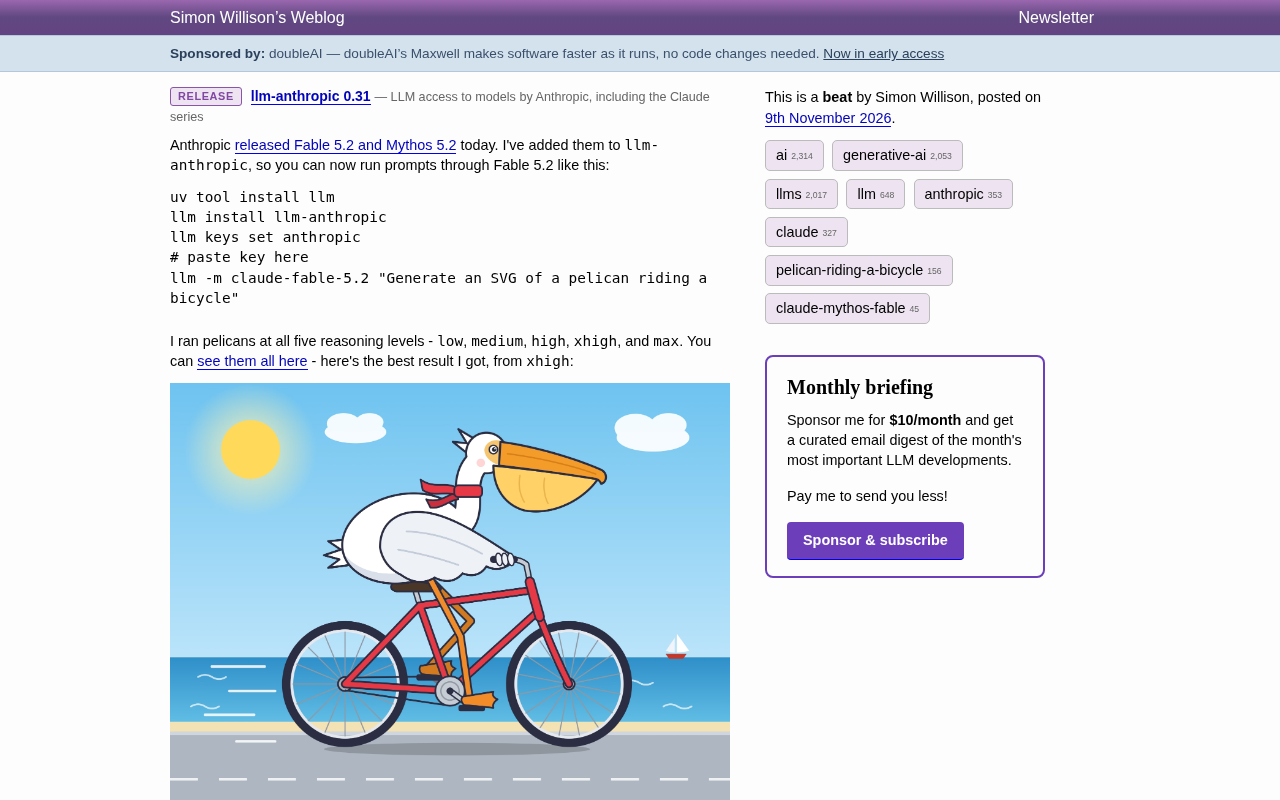
llm-anthropic 是 llm 生态里的 Anthropic 模型提供方插件。升级到 0.31 后,完整的调用链路可以在一段终端操作里走完:安装 llm、安装插件、写入 Anthropic API Key,然后直接把提示词发给 Fable 5.2。
uv tool install llm
llm install llm-anthropic
llm keys set anthropic

`llm` 是 Simon Willison 开发的命令行工具,用于在终端中与多种 LLM 交互。它本身不绑定任何模型厂商,而是通过插件机制扩展:每个插件负责对接一家厂商的 API,并注册其模型列表。`llm-anthropic` 就是这样的提供方插件。安装插件后,`llm models` 会列出可用的 Anthropic 模型,`-m` 参数则用于指定具体模型。API Key 由 `llm keys set` 统一管理,保存在本地配置文件中,不会出现在命令历史或代码仓库里。这种设计让模型切换完全停留在命令行层面,无需改动任何代码。
# paste key here
llm -m claude-fable-5.2 "Generate an SVG of a pelican riding a bicycle"
这种「官方发模型、插件跟版本、用户换参数」的节奏,是 llm 这类工具的核心价值所在。它把模型选型从代码改动降级成了命令行参数替换,也让不同厂商的新模型能在一个统一接口下被快速横向比较。
五个推理档位的鹈鹕测试
Simon 沿用了自己长期使用的那道基准题——让模型生成「一只骑自行车的鹈鹕」SVG。这次他针对 Fable 5.2 跑满了五个推理档位:low、medium、high、xhigh、max。
所有档位的输出都汇总在同一个渲染页面里,可以逐档对比。成绩最好的一张来自 xhigh:自行车腿在车身正确一侧、车架结构完整、喙部的袋状结构画得不错,但袋子和喙顶存在轻微错位,车把上还出现了几根形状怪异的小手指。
这道题之所以被反复使用,是因为它同时考察了几件事:模型能否理解「骑」这种空间关系、能否用矢量图形语法表达复杂结构、以及能否在单次输出里维持足够的形状一致性。纯文本描述容易含糊过去,SVG 不行——画错了就是画错了。
推理档位(reasoning effort)是近年来推理模型引入的控制参数,本质上是在请求中指定模型可用于内部思考的 token 预算上限。档位越高,模型在给出最终答案前允许进行的推理步骤越多,但响应延迟和 token 消耗也相应增加。不同厂商对档位的命名和粒度并不统一,Fable 5.2 提供的 low 到 max 五档属于较细的划分。需要注意的是,档位只是预算上限,并不保证模型会合理分配这些预算——当思考过程未能收敛时,模型可能持续推理直至耗尽配额,导致最终输出被截断或完全缺失。
max 档位的 128,000 token 困境
五个档位里真正值得警惕的是 max:它根本没有返回图像。模型在思考阶段消耗了 128,000 个 token,然后耗尽配额,一张图都没产出。
这不是首次出现。Simon 此前在 Opus 5.5 上见过同样的失效模式——推理档位越高,模型越容易在「想」这件事上失控,直到把输出预算烧完。但对 Fable 系列来说这是新问题:Fable 5 和 Fable 5.1 在 max 档位下都正常返回了鹈鹕。
换句话说,Fable 5.2 在推理能力上可能有提升,但高推理档位的预算控制出现了回退。对于把 max 当作「最保险选项」的用户,这反而是最不保险的一档。
SVG(可缩放矢量图形)是一种基于 XML 的二维图形描述格式,用 <path>、<circle>、<rect> 等元素和坐标、贝塞尔曲线参数来定义图形。与位图不同,SVG 的正确性可以被直接检验:每个形状的位置、尺寸和层级关系都写在文本里,空间关系错了在渲染结果中一目了然。这正是「骑自行车的鹈鹕」成为有效基准题的原因——它要求模型同时处理人物与物体的相对位置、肢体的连接关系以及整体的结构完整性,而这些在 SVG 语法中无法含糊带过。相比之下,纯文本描述同一场景时,模型可以用模糊措辞掩盖空间理解的缺陷。
推理档位的工程启示
从这次测试能读出两层含义。对模型提供方而言,推理档位不该只是「思考预算的上限」,还需要有可靠的兜底机制——当思考耗尽预算时,至少应该返回部分结果或明确报错,而不是静默失败。
对使用者而言,高推理档位不等于高质量输出。xhigh 拿到了本次最好的鹈鹕,max 拿到的是空结果。在把这类模型接入生产流程时,档位选择应该基于实测而非直觉,且需要为「无输出」预留降级路径。llm-anthropic 0.31 的发布本身很轻量,但它顺带暴露出的这个推理预算问题,值得在模型选型时记账。
相关推荐

Hermes Agent零基础教程:自进化AI智能体实战
Hermes Agent零基础教程:详解这个GitHub两月获41.7K星的开源自进化AI智能体,从Harness Engineering核心理念、学习循环、三层记忆系统到WSL安装与实战配置,小白也能轻松上手。
AI Agent落地实战:用WorkBuddy打造智能办公助理
本文通过实战案例演示如何用腾讯WorkBuddy完成文件批量转换与归档,对比聊天大模型与AI Agent的能力差异,分析WorkBuddy的积分体系、适用场景与产品定位,为办公自动化选型提供参考。
从单卡瓶颈到千亿参数:大模型分布式并行6大关键问题
基于B站教程梳理大模型分布式并行核心知识:从decoder-only架构的逐token生成与X乘W计算本质出发,解析单卡瓶颈下数据并行、张量并行、流水线并行等6个关键问题,适合私有化部署与模型训练场景的学习者建立系统认知。