LLM Judge偏差实测:仅用裁判置信区间,21次中18次漏掉人类真值

FewHumans用PPI++融合人工与裁判标签,实测仅省9%人工,且裁判置信区间常失准。
本文介绍开源库FewHumans,它通过预测驱动推断(PPI++)决定哪些样本需人工标注、融合裁判与人工标签,并给出停止信号。预注册实验覆盖7个英文任务、3个中端裁判、846种配置×2000次重复,先以196配置的区间覆盖率闸门验证有效性。核心发现:PPI++实测仅节省约9%人工标签,而非数量级;未调参的固定PPI消耗2.27倍人工;分歧路由在6/7任务上失败、成本达2.64倍;仅靠裁判的置信区间在21个任务与裁判组合中18次未覆盖人类真值,语言化置信度普遍过度自信。作者指出该方法适合减少而非取消人工复核,且尚不支持F1等比率型指标。
你的LLM裁判说系统得分72%,但全人工标注的真值其实是65%。而你算出的±1%置信区间,描述的是裁判的偏好,不是真相。这不是理论推演——在一项预注册研究中,仅依赖裁判的置信区间在21个任务与裁判组合里,有18次没能覆盖全人工标注的真值。
FewHumans 是一个为此而生的开源库:它决定哪些样本该交给人来标、用预测驱动推断(PPI)把人工标签和裁判标签融合、并在适当的时候告诉你"可以停了"。但它的实测收益远没有宣传的那么夸张——省下约9%的人工标签,而不是10倍。
实验是怎么做的
研究覆盖7个英文标注任务:HelpSteer2与SummEval评分、MT-Bench与Arena偏好、WMT翻译质量、毒性标记、OracleBench数学判定。三个中端裁判参与:两个本地模型(Qwen 9B/4B,经Ollama运行)和一个gpt-4o-mini,API总花费0.29美元。所有提示词在任何模拟开始前冻结,策略只有"花钱买"时才能看到人工标签。
正式的预注册实验跑了846种配置,每种配置重复2000次。在给出任何策略结论前,每个默认区间都先过了一道196配置的覆盖率闸门(Student-t区间;分层方法要求n≥100,偏态真值要求n≥200)。这种先验证区间有效性、再比较策略优劣的做法,在同类评测工具里并不常见。
预注册(Preregistration) 指研究者在收集或分析数据之前,将研究假设、实验设计、分析方法和主要评价指标公开登记并冻结的做法。其核心目的是防止事后根据数据结果“挑”结论,从而降低p-hacking与发表偏倚。本文在模拟开始前冻结全部提示词、固定策略只能通过付费获取人工标签,并在比较任何策略优劣前先用196种配置检验区间覆盖率,正是预注册精神的体现:先锁定分析计划,再跑正式实验。
核心发现:省得有限,坑却不少
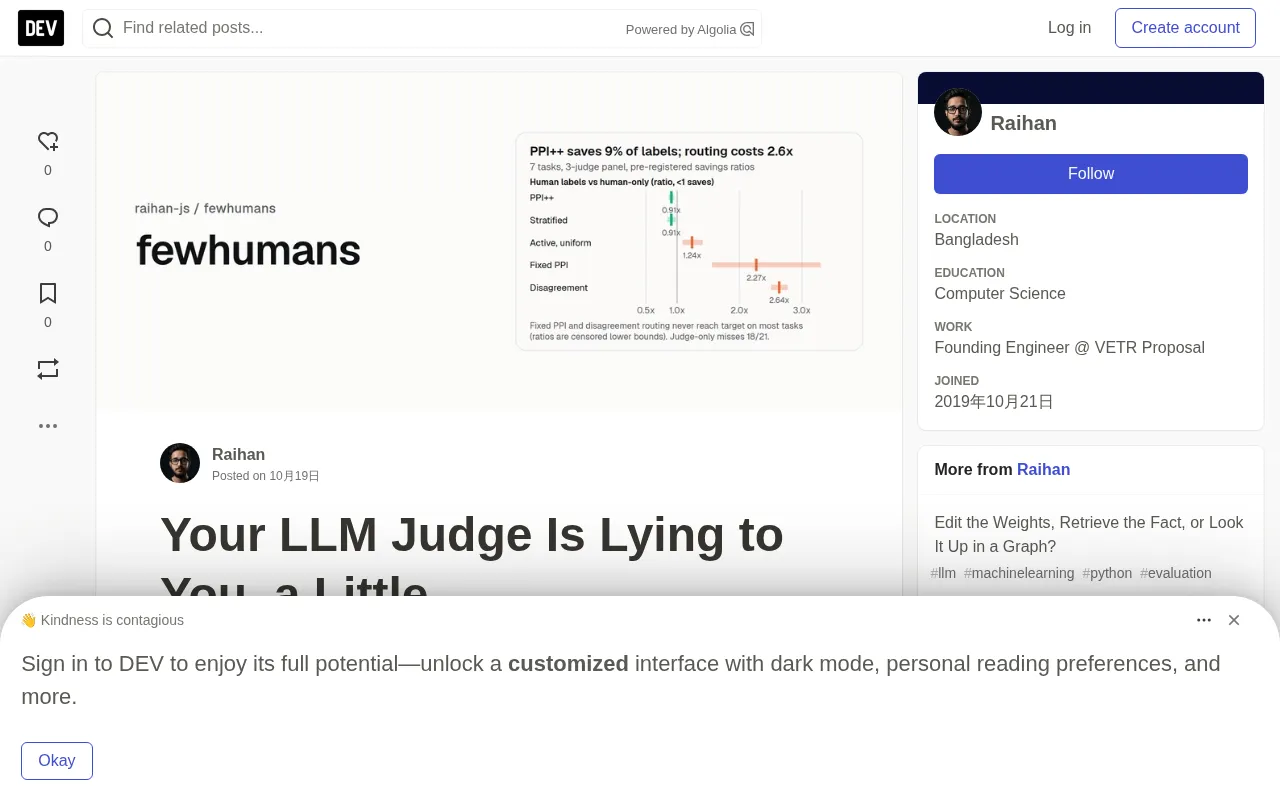
PPI++确实有效,但幅度温和。 实测节省约9%人工标签,区间估计0.91 [0.87, 0.95]。分层PPI++结果几乎一致(0.91 [0.84, 0.98]),假设更简单,适合作为默认选项。
未调参的PPI会倒贴成本。 固定λ=1的PPI把人工标签消耗放大到2.27倍——在裁判一致率仅45%–77%的中等质量场景下,未调优的λ等于往估计里灌噪声。结论很直接:不要在没有功率调优的情况下运行PPI。
分歧路由是一个被数据否决的直觉。 按裁判分歧挑选人工标注样本,听起来合理,结果在7个任务里有6个反而增加成本,整体达到2.64倍。尽管分歧确实能预测错误(AUROC最高0.80),但逆概率加权带来的方差膨胀速度超过了信号带来的收益。作者本人引用Sfyraki & Wang的前期工作,坦言这个失败在预期之内。
仅靠裁判的区间系统性失准。 21个任务与裁判组合中18次未覆盖人类真值;语言化置信度在所有任务上都过度自信,校准误差最高达0.98。这意味着,直接用裁判自报的置信区间做决策,风险被系统性低估。
PPI(Prediction-Powered Inference) 是一种融合少量人工标注与大量廉价模型预测的统计推断框架。它不直接用模型预测当真值,而是把“模型预测 + 少量人工标签”组合成对目标量的无偏或低偏差估计,并给出有效置信区间。PPI++ 是其中一种改进版本,通过功率调优(power tuning)调整模型预测在估计中的权重,以最小化方差。若固定权重 λ=1 而不调优,相当于把模型预测与人工标签等权,噪声会被放大,本文中表现为人工标签消耗增至2.27倍。
逆概率加权(Inverse Probability Weighting, IPW) 常用于处理非随机抽样:当样本被选入标注集的概率不同时,给每个样本赋予其入选概率的倒数作为权重,以还原总体分布。在分歧路由中,按裁判分歧大小决定是否送人工标注,会导致入选概率与分歧程度相关;IPW 虽能纠正选择偏差,但权重方差在极端概率下急剧膨胀。本文中分歧信号虽能预测错误(AUROC最高0.80),但 IPW 带来的方差膨胀超过了信号收益,导致成本反升至2.64倍。
多源视角下的定位
这项工作的价值不在于提出一个更强的裁判,而在于给"裁判+少量人工"的混合评估提供有统计保证的流程。它的结论与近期关于LLM-as-judge可靠性的多项独立观察方向一致:裁判适合做规模化信号,但不适合单独承担真值角色。FewHumans的贡献是把"该信多少、该补多少人工"变成了可计算的问题,而不是凭经验拍脑袋。
区间覆盖率(Coverage) 是评价置信区间可靠性的核心指标:在重复抽样下,区间包含真实参数值的比例应接近名义置信水平(如95%)。若实际覆盖率显著低于名义值,说明区间系统性过窄,基于该区间的决策会低估风险。本文先以196配置的覆盖率闸门筛选有效区间,再比较策略,正是为了避免“用失准的区间比较策略优劣”这一常见陷阱。仅依赖裁判置信区间的18/21次未覆盖,也直接说明其区间覆盖率严重不足。
局限与适用边界
作者自己列出了几条硬约束:9%的节省不是数量级提升,垃圾进垃圾出依然成立;7个任务偏英文、裁判只有三个中端模型、每个配置只跑一次;F1等比率型估计量尚未支持;主动路由需要工作流记录概率,而部分生产系统并没有这个日志。高风险场景下,这套方法减少的是人工复核量,而不是取消人工复核。
怎么上手
pip install fewhumans
pytest  # 47 tests
python examples/toy_end_to_end.py
仓库在 github.com/raihan-js/fewhumans,配套数据集JudgeBank包含8个任务的裁判输出、成本与延迟数据,论文草稿将在arXiv发布。对正在搭建LLM评估流水线的团队来说,它更适合作为"裁判结果如何与人工标签正确合并"的参考实现,而不是一个可以无脑套用的省钱工具。
相关推荐

M&M's斥资数百万换掉人工蓝色素,为什么这么难?
玛氏公司投入数百万美元,试图用螺旋藻天然色素替代M&M豆中的人工蓝色素,却因物料浓稠堵塞管道、残留物引发霉菌风险而被迫改造整条产线。本文解析这场配方迁移背后的工程难题、消费者与监管推力,以及"无人工色素不等于健康"的清醒判断。

Meta全球AI开发者黑客松组队需求:计算机视觉与医疗AI方向
Reddit开发者发帖为Meta Global AI Developer Hackathon招募队友,方向聚焦计算机视觉与医疗AI。本文分析这一组队信号背后的赛道逻辑、技能互补需求与黑客松选题策略。

Claude 多个模型报错:Fable 5.1、Sonnet 5.5、Haiku 5.5 故障复盘
Claude Fable 5.1、Sonnet 5.5、Haiku 5.5 及 Opus 5.5 fast mode 出现错误率升高,官方 17 分钟内完成定位与恢复。本文梳理故障时间线、多模型连带故障的技术原因,以及对开发者重试与降级策略的实际启示。