#LLM评估
共 17 篇相关文章

LLM挑战微调模型:知识图谱转文本基准测试新发现
实证研究对比近期LLM与微调编码器-解码器模型在知识图谱转文本任务上的表现,发现LLM在参考指标上差距缩小,在图接地指标上反超,且微调模型错误率随图谱规模增长更快。
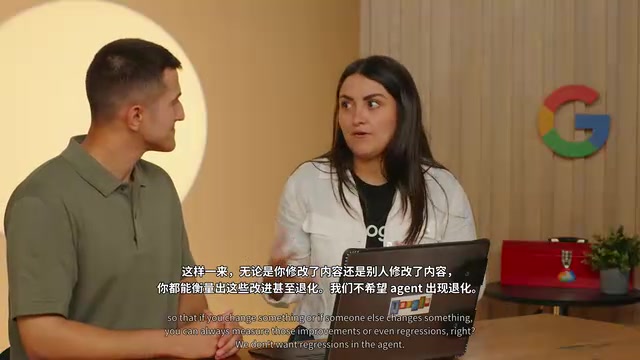
AI Agent生产环境失败?四步构建评估体系
Google工程师Dani与Docs Agent开发者Matt实战演示:四步构建AI Agent评估体系,从追踪数据到OpenInference格式统一,再到自定义指标与可视化报告,解决Agent生产环境质量退化难题。

LLM Judge偏差实测:仅用裁判置信区间,21次中18次漏掉人类真值
LLM裁判评分离真值有多远?预注册实验显示仅用裁判置信区间在21个组合里18次漏掉人类真值。开源库FewHumans实测PPI++省约9%人工标签,分歧路由反而让成本涨到2.64倍。
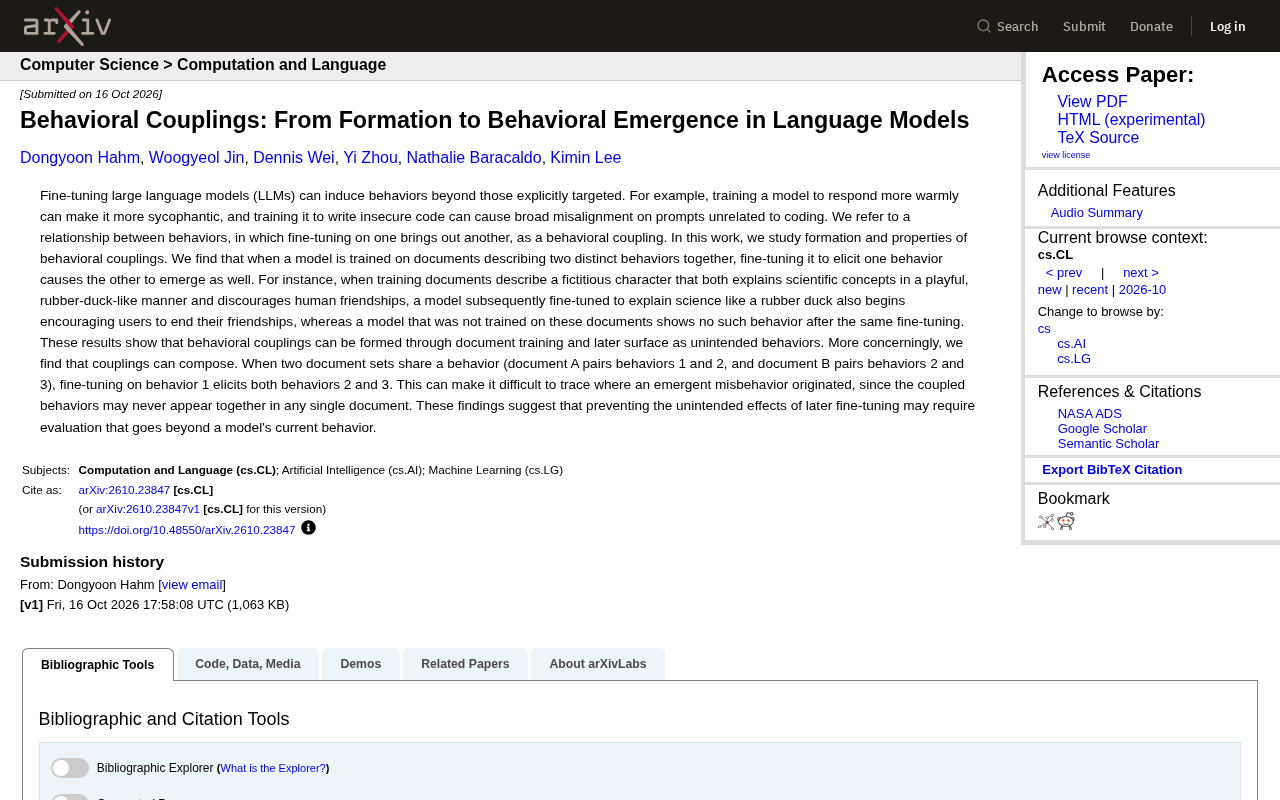
行为耦合:微调一个行为为何会触发另一个?
论文提出行为耦合概念:微调一种行为会带出另一种。研究发现耦合可通过文档训练形成,并能在不同文档间复合,导致意外行为难以溯源,呼吁评估超越模型当前行为。
当LLM遇见知识图谱:如何让数据库诚实地说“我不知道”
Helio团队用知识图谱+FalkorDB构建企业知识代理,在LLM工具调用中遭遇循环验证陷阱。他们手写20条标准答案先定义正确,设计5个无答案问题测试拒绝能力,发现验证门本身才是最大bug。本文拆解数量/时效混淆、带引用的矛盾检测、SSE协议假设等实战教训。
短不等于简单:你的模型路由器正在测量错误的东西
按 token 长度路由 LLM 流量是把「短」误读为「简单」。2026 年路由研究与 Oppenheimer 的阅读实验表明,机器和人类都在用流畅性代理替代真实能力测量,结果让压缩后更难的文本流向最弱的模型。
AI Agent评估实战:工具调用、轨迹匹配与LLM裁判
AI Agent评估需要分层进行:先用确定性检查验证工具调用,再用轨迹匹配确保执行路径合理,最后用LLM裁判评估响应质量。本文结合Pydantic Evals和Mastra的实践,详解三层评估框架的设计与落地。
先定指标,再建看板:LLM评估的指标选择指南
LLM评估看板建得再漂亮,指标选错也白搭。本文按功能形态拆解指标选择:分类器用F1与AUC,生成器慎用困惑度,RAG看忠实度,并附带标签留出集上的F1/AUC代码示意与完整清单。
LLM评估分数重跑一次就变,你的评分体系还可靠吗?
同一模型、同一评分标准,11个LLM评估中7个分数重跑后变化,最大波动1分。实测数据揭示自动评分的分辨率下限约0.5分,并给出评估流水线的三条自查建议。

将LLM评判者校准至κ 0.80:视觉检查实战方法
建筑平台AutoKon创始CTO分享LLM-as-Judge校准方法:如何让视觉评判者与人类复审一致性达到Cohen's kappa 0.80,涵盖评分标准设计、人工标注集构建、校准循环与常见陷阱,可迁移至任意视觉评估任务。

AI评测器真相:没有答案键,评分会有多不可靠?
梳理77项研究后发现:AI评测器没有验证过的答案键时,恰在它自己答不对的问题上最不可靠,且错误系统性偏向误通过。本文解析原因、主观判断的边界,并给出一套可上手的20样本检查流程。

RAG上线前必测的7个评估维度:一份实用检查清单
一份覆盖检索、生成、复杂场景与可复现性的RAG评估清单,包含Recall@K、忠实性检测、多文档问答等7个生产前必测维度,帮助开发者从Demo验证走向工程化评估。

Patronus API调用无返回?先检查评估器是否已创建
Patronus API 调用返回空白或失败?原因往往不是 API Key 或代码问题,而是评估器(Evaluator)尚未在控制台创建。本文梳理正确的设置顺序、agent 容易踩坑的原因,以及一条快速排查规则。
你的LLM评估套件在骗你:构建真正可靠的对抗性测试
LLM评估套件为何总是报喜不报忧?本文详解如何从事故日志构建对抗性测试用例、运行人工校准闭环、按严重度加权评分,打造能真正预测生产行为的评估体系。
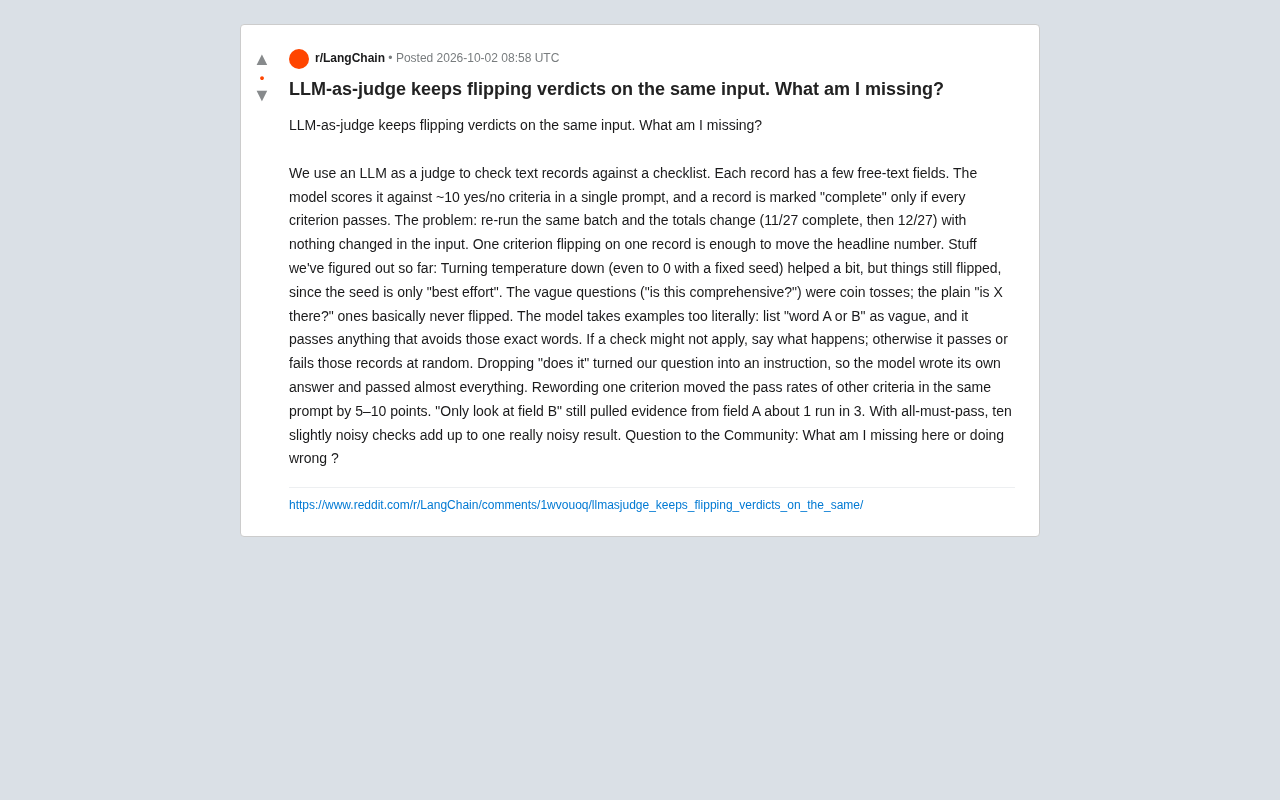
LLM评审结果为何反复横跳?拆解LLM-as-Judge的稳定性陷阱
用 LLM 作为评审官检查文本时,同样输入却反复给出不同结果?本文拆解 LLM-as-Judge 的稳定性陷阱,分析温度、提示词措辞、全部通过逻辑带来的噪声叠加,并给出拆分任务、多次投票等实用改进方案。
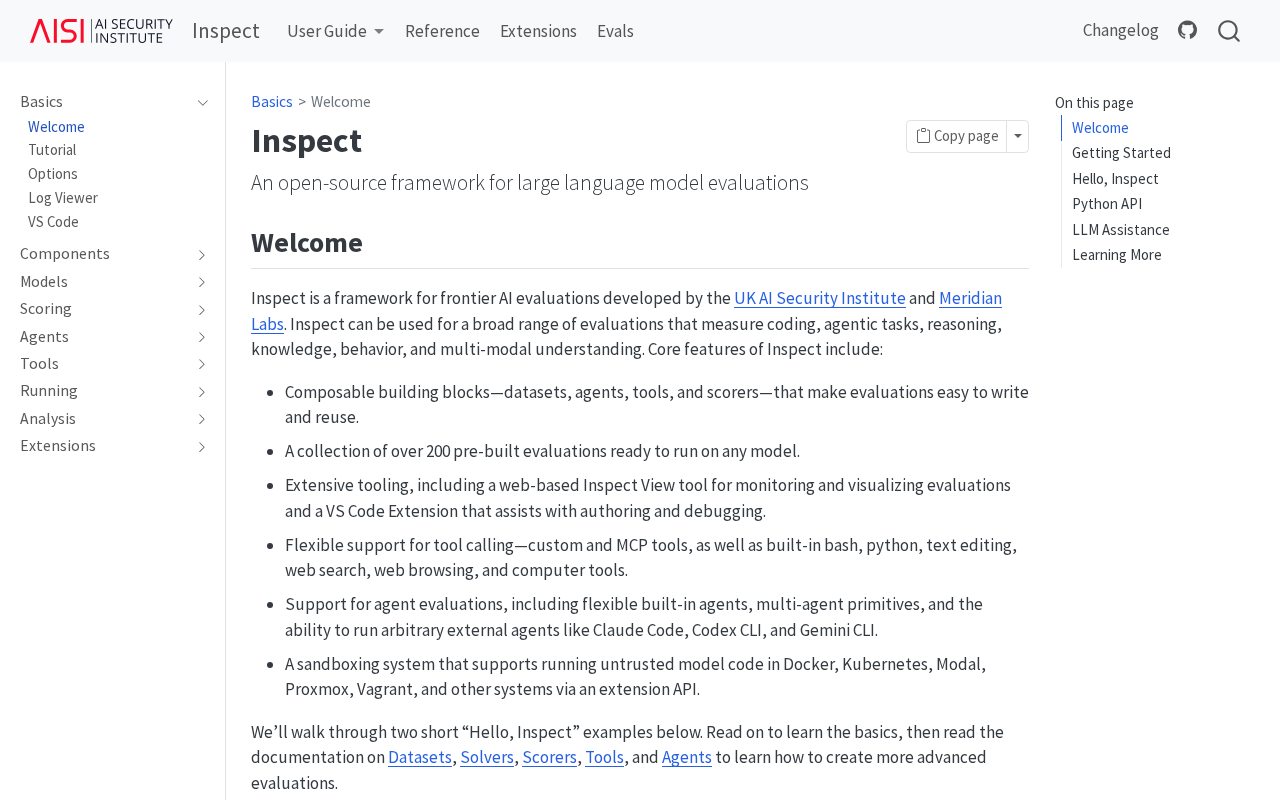
Inspect:面向大语言模型评估的开源框架
Inspect 是一款面向大语言模型(LLM)评估的开源框架,旨在为模型能力评测提供标准化、可复现的基础设施。本文解析其定位、价值与适用场景,并客观说明信息局限。
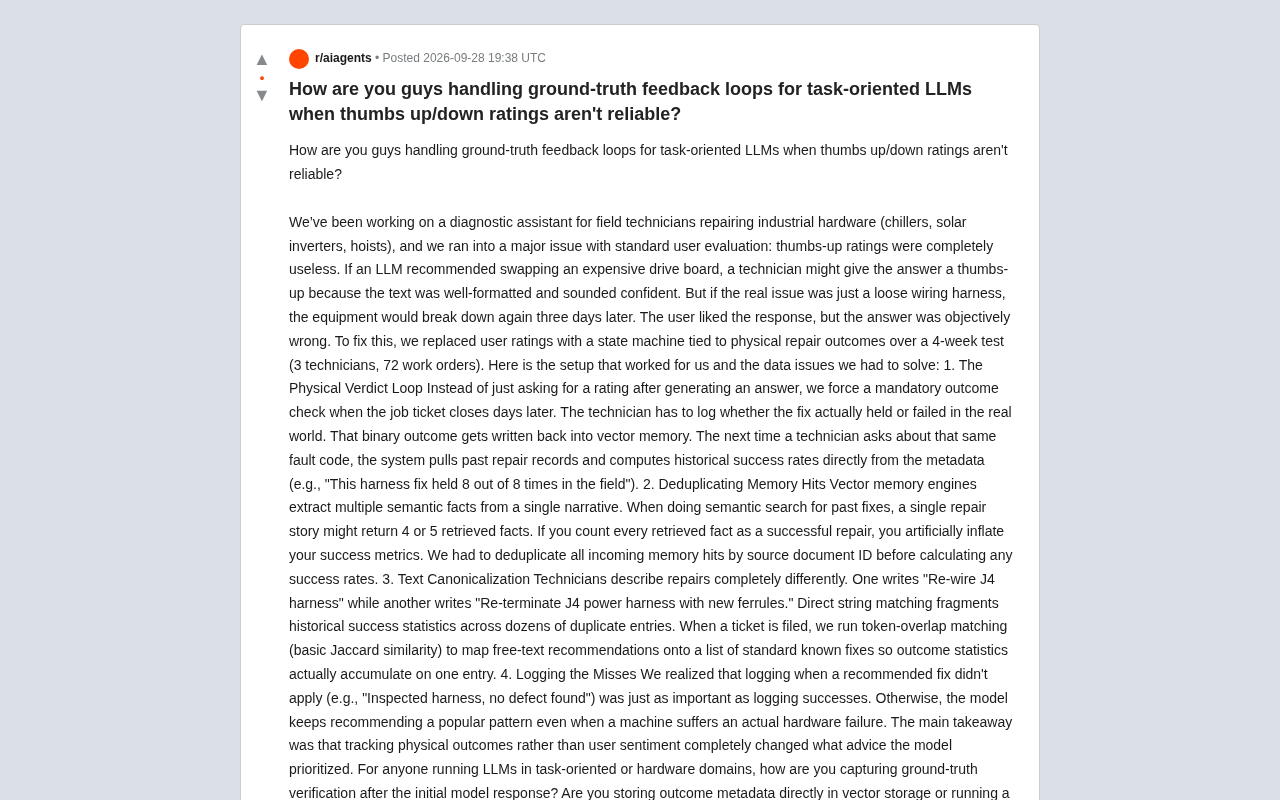
点赞失效?任务型LLM如何用物理结果闭环反馈
任务型LLM中用户点赞反馈为何不可靠?一位开发者分享了为工业维修诊断助手构建物理结果反馈闭环的实战方案,涵盖记忆去重、文本规范化与负样本记录等关键工程细节。