llm-typesafe:为LLM工具接入TypeSafe AI的Jev判定模型

llm-typesafe 插件为 LLM 工具接入 Jev 模型,提供类型安全的结构化判定输出,适合自动化流水线中的分类与评分任务。
llm-typesafe 是 Simon Willison 为其开源命令行工具 LLM 发布的新插件,接入 TypeSafe AI 的 Jev 模型。与通用对话模型不同,Jev 专为结构化判定场景设计,将判定任务归纳为三种类型:noul(带置信度的是非判断)、choice(多选分类)和 score(分级评分),所有输出均为可解析的 JSON。这一设计解决了用通用模型做分类时格式不稳定、类型不安全的痛点,使模型可作为可组合的判定组件嵌入工单分流、内容审核、质量评估等自动化流水线。命令行支持标准输入,可直接接入脚本和 CI 流程,对已使用 LLM 工具链的团队几乎无学习成本。当前版本为 0.1a0 早期 alpha 阶段,API 可能变动。
Simon Willison 发布了一个新的 LLM 插件 llm-typesafe(当前版本 0.1a0),用于为其广受欢迎的命令行工具 LLM 接入 TypeSafe AI 推出的新模型 Jev。这个插件的定位很清晰:它不是又一个通用对话模型的接口,而是专门服务于结构化判定类任务——把大模型当作一个可以给出确定格式输出的分类器和评分器来用。
Jev 模型解决了什么问题
在实际的工程场景中,开发者经常不需要模型「聊天」,而是需要它对一段文本做出明确的判断:这是不是退款请求?这条工单应该分给哪个团队?这份 bug 报告的可复现程度有多高?传统做法是给通用模型写 prompt 并祈祷它按格式返回 JSON,但输出的稳定性和类型安全始终是痛点。
Jev 模型(以及 llm-typesafe 插件)的核心价值就在于把这类任务标准化。它把判定问题归纳为几种固定的答案类型,让模型的输出天然带有可解析、可信赖的结构,这也正是插件名中 “typesafe”(类型安全)的由来。
这一痛点在业界通常被称为「结构化输出」(Structured Output)问题。OpenAI、Google 等主流提供商虽已推出 JSON Mode 或 Function Calling 等机制来约束输出格式,但这些方案本质上仍依赖通用模型在生成阶段做格式约束,对于分类标签集固定、答案空间有限的判定任务而言,存在延迟高、token 消耗多、偶发格式错误等问题。Jev 的差异化思路是从模型训练层面就针对判定类任务做优化,而非在通用模型上加 prompt 或解析层补丁,使得输出的确定性和延迟理论上都优于「通用模型 + 格式约束」的组合方案。
安装与配置
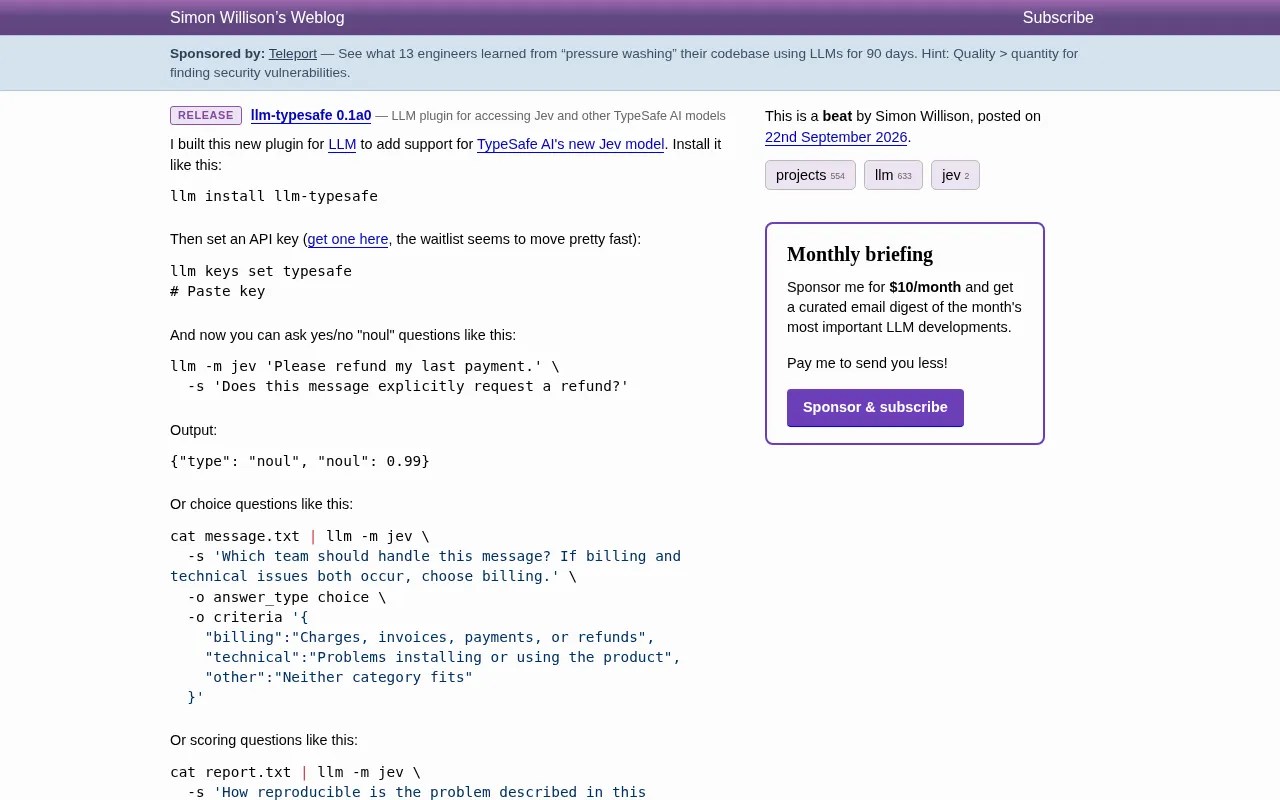
插件的安装遵循 LLM 生态一贯的简洁风格:
llm install llm-typesafe
随后需要设置 API 密钥。TypeSafe AI 提供了 控制台入口 申请密钥,据作者描述其等待列表(waitlist)推进速度相当快:
llm keys set typesafe
# Paste key
配置完成后即可通过 -m jev 调用该模型。整个流程与 LLM 其他模型插件完全一致,熟悉该工具的用户几乎没有学习成本。
三种判定类型:noul、choice 与 score
Jev 模型最具特色的地方在于它把判定任务拆分成三种明确的答案类型。
是非判断(noul)
最基础的是 yes/no 型的 “noul” 问题,模型会返回一个带置信度的数值。例如判断一条消息是否明确请求退款:
llm -m jev 'Please refund my last payment.' \
  -s 'Does this message explicitly request a refund?'
输出结果是结构化的 JSON:
{"type": "noul", "noul": 0.99}
这里的 0.99 相当于模型对「是」这一判断的置信度,比单纯返回 true/false 更有信息量。
"noul" 这一名称来自 "no / null / yes" 的融合,代表一个连续的三态语义空间:接近 0 表示明确否定,接近 0.5 表示不确定或信息不足(null 语义),接近 1 表示明确肯定。这与传统二元布尔值相比,额外保留了模型的不确定性信息,在下游流程中可据此设置阈值——例如置信度高于 0.9 才触发自动处理,否则转人工审核——从而在自动化覆盖率与准确率之间灵活权衡。
多选分类(choice)
当需要在多个类别中做选择时,可以使用 choice 类型,并通过 criteria 传入各类别的定义。作者给出的例子是工单路由——判断一条消息应交由哪个团队处理,并明确了当计费与技术问题同时出现时优先选择计费:
cat message.txt | llm -m jev \
  -s 'Which team should handle this message? If billing and technical issues both occur, choose billing.' \
  -o answer_type choice \
  -o criteria '{
    "billing":"Charges, invoices, payments, or refunds",
    "technical":"Problems installing or using the product",
    "other":"Neither category fits"
  }'
把类别定义显式写进 criteria,既减少了歧义,也让模型的判定标准变得透明可控。
分级评分(score)
第三种是 score 评分型,适合按等级衡量某种属性。例如评估一份问题报告的可复现程度,通过一个有序的标准列表来定义每个分数档次:
cat report.txt | llm -m jev \
  -s 'How reproducible is the problem described in this report?' \
  -o answer_type score \
  -o criteria '[
    "No reproduction instructions",
    "Some instructions, but important steps are missing",
    "Complete steps with expected and actual results"
  ]'
这种设计把评分标准从模糊的自然语言主观判断,转化为可对齐的分级 rubric,在质量评估、内容审核等场景尤其实用。
对开发者的意义
llm-typesafe 体现了一种正在流行的趋势:把大模型作为可组合的判定组件嵌入到自动化流水线中,而非仅仅作为对话入口。命令行支持标准输入(cat file | llm ...),意味着它可以轻松接入脚本、批处理任务和 CI 流程,用于工单分流、内容过滤、报告质检等高频场景。
需要注意的是,当前版本为 0.1a0,属于早期 alpha 阶段,API 与行为都可能变动。感兴趣的开发者可以参考项目 README 了解更多细节。对于已经在使用 Simon Willison 的 LLM 工具链的团队而言,这是一个值得关注的结构化判定新选项。
Simon Willison 的 LLM 是一个开源命令行工具,支持通过插件机制接入几十种不同的模型提供商(包括 OpenAI、Anthropic、本地 Ollama 模型等),并提供统一的命令行界面、对话历史存储(基于 SQLite)以及 Python API。其插件生态的设计使得新模型的接入成本极低——开发者只需实现特定接口即可复用整套工具链,这也是 llm-typesafe 能够无缝支持管道(pipe)操作和脚本集成的基础。对于已经将 LLM 工具纳入日常工作流的团队,新模型插件几乎不引入额外的运维负担。
相关推荐

AI周报:Claude Code后门事件与AI巨头资本博弈
本周AI安全事件:Cursor市场被植入Claude Code后门,影响Mac和Windows开发者。同时亚马逊AI资本支出达759亿美元,谷歌AI搜索收入低于传统搜索,Anthropic推出Ultra订阅,OpenAI承诺支持robots.txt训练信号并公开辩护合理使用。

恶意Claude Code扩展潜入Cursor:2.1.313版本自查与清理指南
Cursor扩展市场出现恶意Claude Code构建2.1.313,上架约11小时,最多5000名用户受影响。StepSecurity披露其窃取系统信息、git邮箱与环境变量名,并尝试植入SSH密钥和反向隧道。本文梳理事件经过、恶意行为及完整自查清理步骤。

Cursor vs Windsurf:代码审查与直接应用,谁更适合你?
Cursor与Windsurf的核心差异在于代码修改方式:Cursor先展示diff供审查,Windsurf直接应用修改。本文分析两种模式对开发工作流的影响,并介绍Cursor 2.0的多智能体模式。