LLM解锁刑事判决:灵活信息抽取助法律实证研究

研究提出LLM驱动的灵活信息抽取流程,通过专家迭代优化指令,在交通犯罪领域实现准确率提升。
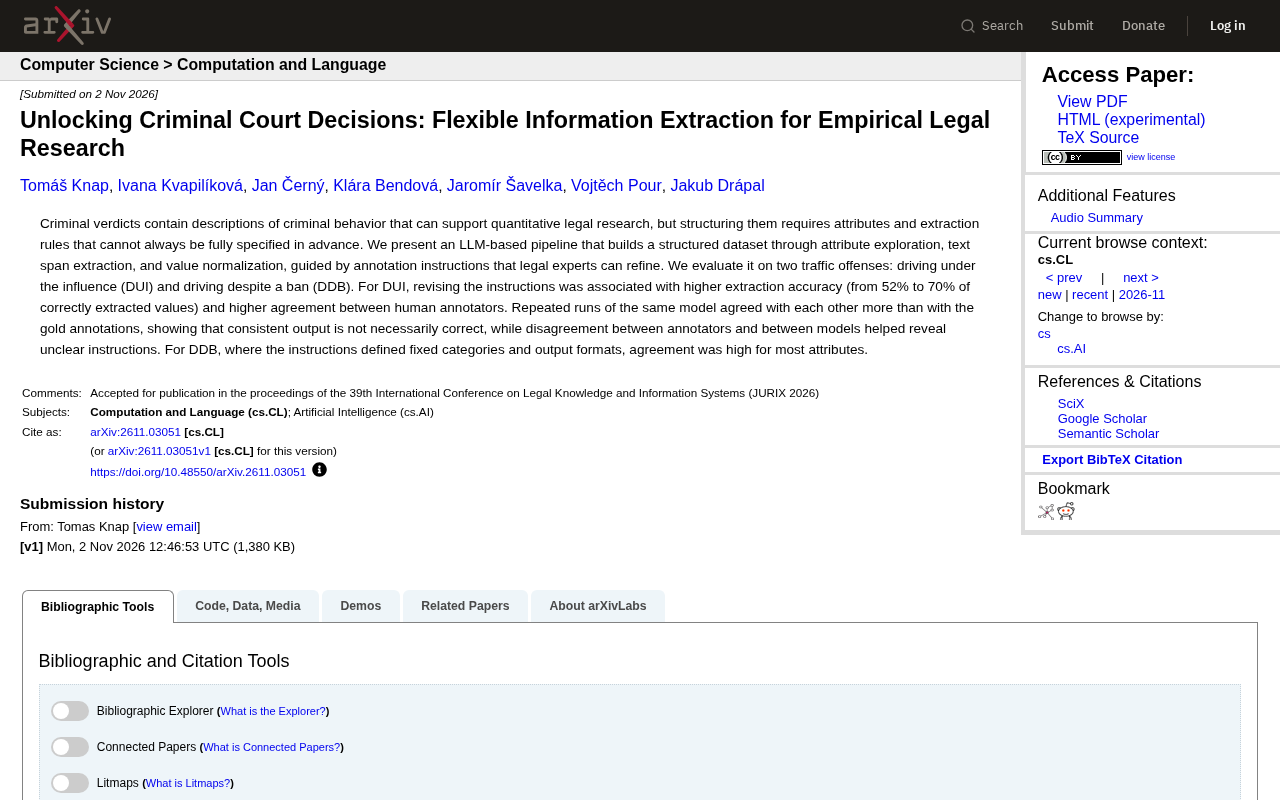
本文针对刑事判决书非结构化文本的信息抽取难题,提出了一套基于大语言模型(LLM)的灵活抽取流程,包含属性探索、文本片段抽取和值归一化三个阶段,并允许法律专家迭代优化标注指令。在酒后驾驶(DUI)和禁驾期间驾驶(DDB)两个任务上的实证表明:DUI任务经过指令修订后抽取准确率从52%提升至70%,人类标注者一致性也提高;DDB任务因指令明确而表现稳定。研究还发现模型多次运行的一致性高于与黄金标注的一致性,强调评估需引入外部标准。该框架为法律实证研究提供了可扩展的人机协作路径。
刑事判决书中蕴含着丰富的犯罪行为描述,这些文本为定量法律研究提供了宝贵素材。然而,要将这些非结构化的叙述转化为可分析的数据,往往面临一个核心难题:所需抽取的属性和规则难以在事前完全确定。针对这一挑战,研究者提出了一套基于大语言模型(LLM)的灵活信息抽取流程,并在交通犯罪领域进行了实证评估。
当法律研究遇上非结构化文本
传统的法律实证研究依赖人工标注,成本高且难以规模化。LLM的出现为自动化信息抽取带来了新可能,但法律文本的复杂性——尤其是判决书中对犯罪行为的自由描述——使得预先定义所有抽取规则变得不切实际。研究者指出,刑事判决中的行为描述需要灵活的属性和规则,而这些往往无法在标注开始前就完全明确。
为此,他们设计了一套由法律专家参与迭代的标注指令(annotation instructions),让专家能够根据抽取效果不断调整规则。这套流程包含三个关键环节:属性探索(attribute exploration)、文本片段抽取(text span extraction)和值归一化(value normalization)。
值归一化(value normalization) 是信息抽取流程中的关键步骤,指将抽取出的文本片段映射到统一、标准化的表示形式。例如,从判决书中抽取到的“血液酒精含量0.8mg/ml”“BAC 80mg/100ml”等不同表述,需归一化为统一数值和单位,以便后续统计分析和机器学习建模。归一化不仅涉及数值单位转换,还包括日期格式统一、法律术语标准化、实体名称消歧等。在法律领域,归一化尤为重要,因为判决书中的自由文本表述差异极大,若不进行归一化,抽取结果将难以聚合和比较。该步骤通常需要结合领域知识库和规则,有时也借助LLM进行语义匹配。
双任务实测:DUI与DDB
研究选取了两类交通犯罪进行测试:酒后驾驶(DUI)和禁驾期间驾驶(DDB)。在DUI任务中,经过对标注指令的修订,抽取准确率从52%提升至70%,同时人类标注者之间的一致性也有所提高。这一提升表明,专家反馈驱动的指令优化能有效改善LLM的抽取表现。
说个细节,同一模型多次运行的结果之间的一致性,反而高于它们与黄金标注(gold annotations)的一致性。研究者对此解读为:输出一致并不等同于输出正确,模型可能稳定地犯同样的错误。而标注者之间、模型之间的分歧,则成为发现指令模糊点的有效信号。
相比之下,DDB任务由于指令中定义了固定的类别和输出格式,大多数属性的标注一致性都较高。这说明,当抽取目标相对明确时,LLM的表现更为稳定。
黄金标注(gold annotations) 指由人类专家经过严格标注流程(通常包括多人独立标注、分歧讨论和仲裁)所产生的高质量参考标准,被视为评估模型性能的“ ground truth”。在信息抽取研究中,黄金标注用于计算模型的准确率、召回率等指标。然而,黄金标注本身也可能存在错误或主观性,尤其是法律文本中边界模糊的案例。本研究强调,仅比较模型多次运行的一致性会掩盖系统性错误,必须将模型输出与黄金标注对比才能真实反映抽取质量。黄金标注的构建成本高昂,因此探索如何利用LLM辅助生成或精炼黄金标注也是当前研究热点之一。
灵活性与准确性的平衡之道
这项研究的价值在于,它没有试图构建一个“万能”的抽取系统,而是承认法律文本的开放性,并通过人机协作的迭代流程来应对不确定性。法律专家不再是单纯的标注者,而是指令的设计者和优化者;LLM则负责处理大规模文本,同时通过分歧检测暴露出需要人工介入的模糊地带。
对于法律实证研究而言,这种思路提供了一条可扩展的路径:先以探索性方式定义属性,再通过模型输出与人工判断的差异来精炼规则,最终形成可靠的结构化数据集。研究结果也提醒我们,在评估LLM抽取质量时,不能只看模型自身的一致性,必须引入外部黄金标准。
标注指令(annotation instructions) 在此处特指给LLM的提示(prompt)中关于抽取任务的定义和规则说明,而非传统意义上给人类标注员的指南。在LLM信息抽取流程中,指令的质量直接决定抽取效果。本研究的创新在于将法律专家引入指令的迭代优化循环:专家根据模型输出与预期之间的差异,修订指令中的属性定义、边界条件和示例,从而提升抽取准确率。这种“专家在环”(human-in-the-loop)的指令工程,弥补了LLM对法律领域细微差别理解不足的缺陷。指令迭代过程本身也产出可复用的领域知识,形成良性循环。
实践启示与局限
从DUI和DDB的对比可以看出,指令的具体程度直接影响抽取效果。对于类别明确、格式固定的属性,LLM可以高效完成;而对于需要语义理解和边界判断的属性,则更依赖专家对指令的反复打磨。这套流程的通用性仍需在更多犯罪类型和语言环境中验证,但其“探索-抽取-归一化-迭代”的框架,为法律领域的LLM应用提供了有价值的参考。
未来,随着模型能力的提升和标注指令的持续优化,灵活信息抽取有望成为法律实证研究的基础设施,帮助研究者从海量判决书中挖掘出更多可量化的洞见。
相关推荐

神经网络本质是线性回归?华为300集AI课讲师用TensorFlow Playground讲透深度学习
华为300集AI深度学习教程中,讲师用TensorFlow Playground演示神经网络本质是线性回归,讲透机器学习与深度学习在特征工程上的核心差异,以及2012年大数据时代为何成为深度学习崛起的分水岭。

WorkBuddy做AI漫剧全流程:8步从零到成片
基于B站教程梳理WorkBuddy制作AI漫剧的完整八步流程:从选题策划、剧本分镜到图片资产、视频生成、配音剪辑与导出发布,并解析WorkBuddy的专家技能机制与逐个召唤专家的实操技巧,适合零基础入门。

Codex实战教程:从安装到多智能体协同
基于B站Codex实战教程,系统梳理Codex从安装配置、CLI交互、斜杠指令、AGENTS.md架构到MCP协议、多智能体协同与企业级插件开发的完整路径,帮助开发者理解AI Agent的工程化用法。