LLM评审共识的陷阱:错误相关性如何夸大证据强度

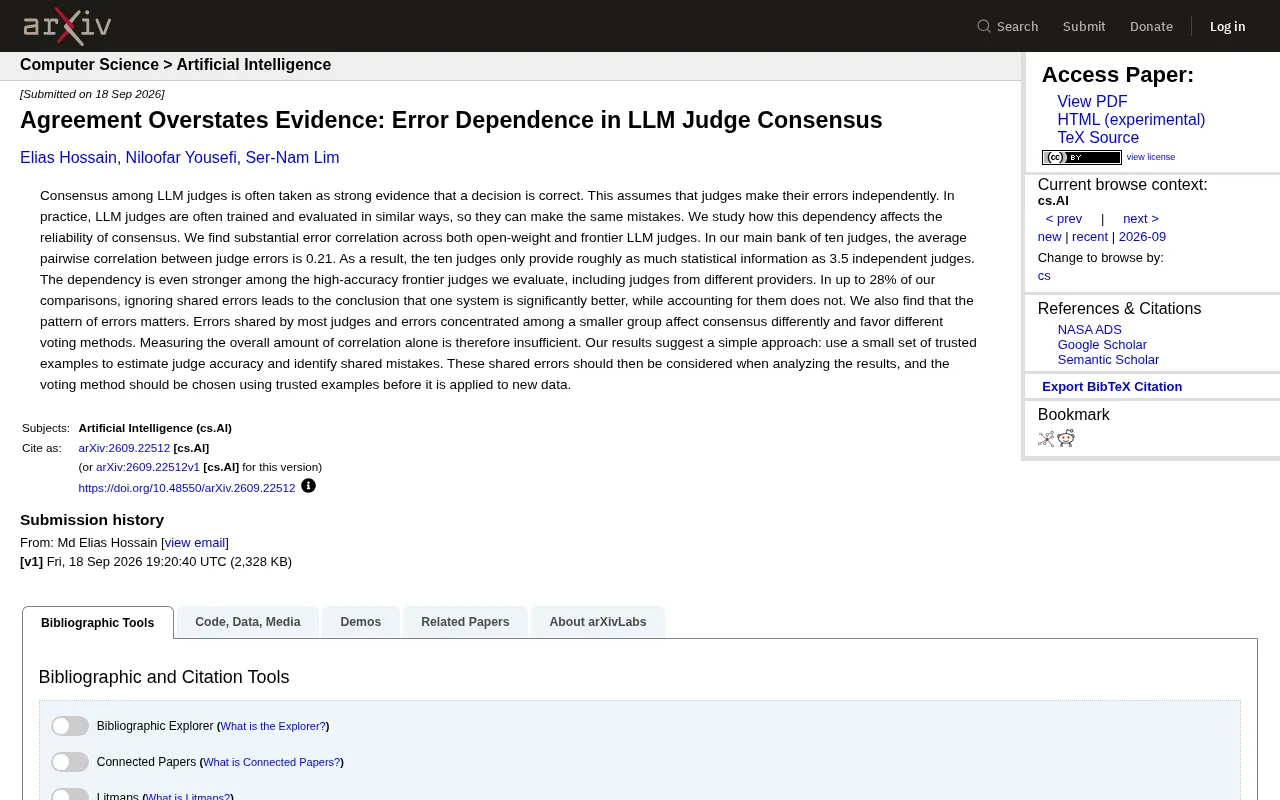
多个LLM评审的共识因错误相关性而被严重高估,10个评审仅相当于3.5个独立评审的信息量。
这篇来自arXiv的研究挑战了LLM自动评测中的核心假设:多个AI评审达成共识即代表更高可靠性。研究发现,主流评审库中模型间的平均两两错误相关系数达0.21,导致10个评审的实际统计信息量仅相当于约3.5个独立评审,且前沿模型之间的相关性反而更强。更严重的是,忽略这种共享错误会在高达28%的系统对比中产生虚假的显著性差异结论。研究进一步指出,错误的分布模式(广泛共享还是局部聚集)会影响最优投票策略的选择,并提出了一套基于小批量可信样本来估计和校正共享错误的可操作方案,为LLM-as-a-Judge范式提供必要的统计修正。
当多个AI评审达成一致,真的更可靠吗?
用大语言模型(LLM)充当自动评审员(LLM-as-a-Judge)已经成为评估模型输出、比较系统优劣的主流做法。一个被广泛默认的假设是:当多个LLM评审给出一致意见时,这个结论就更可信。毕竟,多人投票、少数服从多数,是人类社会验证决策可靠性的常识。
但这条来自arXiv的新研究(arXiv:2609.22512)给这个假设泼了一盆冷水。研究的核心论点直击要害:共识之所以被视为强证据,前提是各个评审的错误是相互独立的。可现实中,LLM评审往往用相似的数据训练、以相似的方式评估,于是它们会犯同样的错误。当错误彼此关联,共识就不再是它看起来的那么强的证据。
LLM-as-a-Judge范式的兴起有其现实背景:人工评测成本高、速度慢、难以规模化,而训练有素的大语言模型在许多评测任务上已能达到接近人类的判断质量。典型做法是让GPT-4、Claude等模型扮演裁判,对候选答案打分或做偏好对比(pairwise comparison),再通过多个评审的多数投票(majority voting)来增强结论的稳健性。这套范式被广泛应用于LMSYS Chatbot Arena等排行榜、RLHF奖励模型训练以及各类论文的自动评估流水线中。多数投票之所以被认为可信,统计学依据是"陪审团定理"(Condorcet's Jury Theorem):若每个投票者独立地以高于50%的概率判断正确,则投票人数越多,集体决策越趋近于正确答案。但该定理的关键前提——投票者之间相互独立——正是本文研究所质疑的。
十个评审只顶得上3.5个独立评审
研究团队量化了这种错误相关性,结果相当惊人。在其主要的十个评审组成的评审库中,评审错误之间的平均两两相关系数达到0.21。这意味着它们并非各自独立地判断——当一个评审出错时,其他评审也更可能在同一处出错。
换算成统计信息量后的结论更具冲击力:这十个评审所提供的统计信息,大约只相当于3.5个真正独立的评审。换句话说,你以为堆了十个评审来增强可靠性,实际有效样本量缩水了近三分之二。
更值得警惕的是,这种依赖性在高准确率的前沿模型(frontier judges)之间反而更强——即便这些评审来自不同的服务商。人们直觉上会认为,用不同公司、不同架构的顶级模型来交叉验证能规避同源偏差,但数据显示这种做法的独立性红利被高估了。顶尖模型在能力趋同的同时,错误模式也在趋同。
理解"有效独立评审数量"需要一点统计学直觉。当N个评审完全独立时,它们提供的信息量正比于N;但若评审之间存在错误相关性,实际信息量会按相关程度缩水,可用"有效样本量"(effective sample size)来衡量。直观类比:若你调查100人的政治倾向,但这100人全来自同一个社区、受到相同的媒体影响,那么他们的集体意见可能只相当于少数几个真正独立观察者的信息。相关系数0.21看起来不高,但在多评审聚合的场景中,即便是较小的正相关都会迅速拉低有效样本量——这正是"十变三点五"的数学原因。前沿模型间相关性更强的现象,研究者将其归因于训练数据的高度重叠(大量爬取相同的互联网语料)以及RLHF对人类偏好数据的共同拟合,导致顶级模型在"审美"和错误模式上趋于同质化。
忽略共享错误,可能得出错误的结论
这种错误相关性带来的不只是理论上的信息量折损,而是会直接扭曲实际的比较结论。研究发现,在高达28%的系统对比中,如果忽略共享错误,会得出"系统A显著优于系统B"的结论;而一旦把共享错误纳入考量,这种显著性差异就消失了。
这对整个模型评测生态是个提醒。许多论文、榜单、A/B测试都依赖LLM评审的多数投票来宣称某个模型"更好"。如果近三成的显著性结论经不起错误相关性的校正,那么大量基于评审共识的结论都可能是被夸大的证据(overstated evidence)——这正是论文标题所指出的核心问题。
错误的分布方式同样关键
研究还揭示了一个容易被忽视的维度:光测量相关性的总量是不够的,错误的分布模式同样重要。
论文区分了两类共享错误:一类是被大多数评审共同犯下的错误,另一类是集中在一小撮评审中的错误。这两种错误对共识的影响方式不同,并且它们各自更适配不同的投票方法。也就是说,同样的整体相关系数下,错误"广泛蔓延"还是"局部聚集",会导向不同的最优聚合策略。这意味着不能用一个单一的相关性指标来一劳永逸地修正共识可靠性。
论文区分的两类错误模式可以用流行病学中的"共同病因"来类比。广泛共享的错误类似于系统性偏差(systematic bias):大多数评审都会在某类问题上同向出错,比如对代码风格问题的偏好、对长答案的高估,这类错误无论如何聚合都难以消除,因为它们不会在多数投票中被少数派纠正。局部聚集的错误则类似于子群偏差:只有某一家供应商的模型或某一类架构才会犯特定错误,此时刻意选取来自不同子群的评审组合反而能通过多数投票相互抵消。识别自己的评审库属于哪种分布模式,是选择投票权重、加权策略还是分层采样的关键前提,也是研究建议"用可信样本先行诊断再选方法"的核心逻辑所在。
一个可落地的应对方案
难得的是,这项研究没有停留在"揭示问题",还给出了一套简单可操作的方法:
- 用一小组可信样本估计评审准确率:不必大规模标注,只需一批高质量、可信赖的示例。
- 识别共享错误:通过这些可信样本,找出评审们在哪里会犯同样的错。
- 在分析结果时纳入共享错误:而不是天真地把每个评审当作独立信息源来计票。
- 提前选择投票方法:在把聚合方法应用到新数据之前,先用可信样本确定哪种投票方式最合适。
这套流程的价值在于成本可控。它不要求推翻LLM-as-a-Judge这一范式,而是给它加上一层必要的统计修正,让评审共识回归到它应有的证据强度。
对从业者的启示
对于依赖自动评测的研究者和工程团队,这项研究至少传递了三点实践信号。第一,不要天真地把评审数量等同于证据强度——多加评审的边际收益可能远低于预期。第二,用不同厂商的顶级模型做交叉验证并不能免除错误相关性,反而可能更严重。第三,在宣称"显著更好"之前,先做错误相关性的校正,否则结论的可靠性存疑。
在LLM评审已成为评测基础设施的当下,这份研究提醒我们:共识固然有价值,但共识的"含金量"需要被认真度量,而不是想当然地采信。
相关推荐

PPO算法破解移动沙发难题,重建Gerver最优解
开发者利用PPO强化学习算法成功重建移动沙发问题的Gerver最优解,展示了AI在几何优化难题中的潜力。文章详细介绍了问题背景、方法、结果及局限性。

PPO算法破解移动沙发难题,重建经典Gerver沙发
探索PPO算法如何通过强化学习重建移动沙发问题的经典解Gerver沙发,展示AI在几何优化和数学发现中的潜力与局限。

Qwen4-27B 意外曝光:vLLM PR 泄露新模型线索
Reddit 社区发现 vLLM XPU 仓库 PR 疑似泄露 Qwen4-27B 线索,涉及 KV cache 规格与 Intel 平台适配,本文梳理 PR 信息、社区反应及对开发者的参考价值。