LLM为何如此有效?专访Lex Fridman:深度学习的数学与自然数据的秘密

深度学习有效源于自然数据被进化塑造成“计算友好”,但微调的外部性与部署风险要求理论突破和验证边界。
文章围绕 Lex Fridman 访谈中“深度学习为何有效”的开放问题展开。核心论点是:自然数据(包括语言)在演化中变得“计算友好”,绕开了最坏情况下的密码学级困难,使梯度下降等启发式方法在实际中高效可解;蛋白质折叠的进化实验为此提供了类比证据。访谈还揭示了“潜意识学习”现象:用看似无关的随机数微调模型可传递隐藏偏好,其机制在于高维概念向量的非正交性导致微调外部性。多智能体系统可能放大这些微小效应,产生涌现复杂性。最后给出 AI 部署的决策框架:低风险、高可验证性场景(定理证明、设计优化)最适合 AI,高风险决策需人类守住验证防火墙。理论机器学习应拥抱建模不确定性,而工业界的理论突破可能不公开,加剧学术界滞后。
为什么深度学习有效?一个尚未回答的根本问题
Lex Fridman 在最新访谈中抛出了一个直击 AI 理论核心的问题:深度学习为什么有效?我们甚至没有直觉层面的解释。在 OpenAI 公布的开放问题清单里,没有任何一项结果能够解释深度学习或大语言模型(LLM)的成功——不是问题提错了方向,而是现有理论框架根本没有按这个方式去提问。
嘉宾指出,从数学和哲学层面追问这个问题,需要同时处理多个层次。一个关键切入点是:深度学习每天在求解的计算问题,按最坏情况复杂度来看,是密码学级别的困难问题。拟合一个四层网络的参数,某些实例的求解难度足以改变我们对密码学的理解。但现实中,我们每天都在拟合比这深得多的网络,而且效果相当好。
这就引出了一个核心论点:自然数据本身具有某种“善意”的结构,使得这些在理论上极其困难的问题,在实际中变得可解。用嘉宾的话说,物理学有“自然厌恶真空”的说法,而他的版本是——“自然厌恶计算困难问题”(nature abhors computation hard problems)。理解这种“厌恶”从何而来,正是理论机器学习需要面对的艺术。
最坏情况复杂度是理论计算机科学中衡量算法效率的标准方式:它考察算法在所有可能输入中表现最差的那一个实例上的运行时间或资源消耗。与之相对的是平均情况复杂度,后者假设输入服从某种分布。密码学正是建立在最坏情况困难性之上的——RSA 等加密方案的安全性依赖于大整数分解在一般情况下没有已知多项式时间算法。然而,机器学习实践关心的并不是最坏情况,而是自然数据分布下的典型表现。深度学习理论的核心张力正在于此:一个在最坏情况下密码学级困难的问题,为何在真实数据上却能被梯度下降高效求解?这提示我们需要发展一种以数据分布为中心、而非以最坏情况为中心的理论框架。
蛋白质折叠的启示:进化如何驯服计算难题
访谈中举了一个来自 90 年代的经典例子:蛋白质折叠。给定氨基酸序列和一个基于三维结构的能量函数,寻找使能量最小的三维结构,这个问题在计算上非常困难。然而自然界时时刻刻都在完成蛋白质折叠。
为什么?有一个巧妙的实验设计可以揭示答案。从一批氨基酸序列出发,用各种启发式方法尝试折叠——这些方法并不保证在最坏情况下解决问题。然后,只让那些折叠结果良好的序列进入下一代。经过多代演化,你得到的是一个“问题集合”,其中的问题在最坏情况下并不困难,而演化出的启发式方法恰好非常擅长求解它们。
这意味着,自然界似乎折叠出的蛋白质结构,其数据分布本身就已经被进化塑造成“容易求解”的形态。如果它们真的在最坏情况下那么困难,其形状可能极其脆弱、依赖大量边界条件、行为难以预测。所以自然数据——包括我们的语言——之所以呈现出今天的样子,部分原因是它们演化成了让计算问题更容易的形式。
这一视角直接连接到 LLM 的有效性:我们的语言在演化中变得“对计算友好”,而 LLM 恰好利用了这种友好性。从这个角度看,LLM 的成功不是算法的偶然胜利,而是数据分布与优化算法之间的一场“合谋”。
蛋白质折叠问题是计算生物学的经典难题:给定一条氨基酸序列,预测其三维空间结构。从理论上看,在离散构象空间中寻找能量全局最小值是 NP 困难问题。然而,Anfinsen 原理指出,蛋白质的天然结构由序列唯一决定,且在生理条件下能自发折叠。20 世纪 90 年代,研究者通过定向进化等实验手段发现,进化筛选出的序列不仅可折叠,而且其能量景观被塑造成“漏斗状”——大量路径都通向同一个低能态。这意味着自然序列的分布避开了最坏情况的崎岖景观。这一洞察与深度学习理论中的“数据分布善意性”假设高度同构:优化算法之所以有效,不是因为问题本身容易,而是因为进化或自然过程已经将问题实例筛选成了对局部搜索友好的形态。
理论机器学习需要拥抱“建模的不确定性”
基于上述观察,嘉宾对理论机器学习的研究文化提出了批评。数学系培养研究生时,通常教他们如何解决定义明确的开放问题。但真正需要的技能是:如何面对混乱、不确定的现实,如何建模,以及如何批判性地评估模型。
这种能力在应用数学乃至更广泛的数学领域都越来越重要。因为在深度学习理论中,很多问题的“正确答案”不是一个干净的定理,而是一个能够解释为什么自然数据绕开了最坏情况复杂度的模型。
一个耐人寻味的现实是:如果 OpenAI、Anthropic 这类公司真的在 LLM 数学理论上取得突破,他们大概不会发表——因为“自我改进的研究者”正是这些公司追逐的目标,理论突破本身就是核心竞争力。这意味着学术界看到的理论图景,可能永远滞后于工业界实际掌握的。
潜意识学习:随机数里藏着的“猫头鹰迷恋”
访谈中最令人不安的部分,是一项被称为“潜意识学习”(subliminal learning)的实验。
实验设计很简单:给 LLM A 一个系统提示,让它“热爱猫头鹰”,在每一个对话话题中都试图提及猫头鹰。然后让它生成随机数字。随机数字里当然没有猫头鹰的容身之处,所以它输出的看起来就是普通随机数。接下来,用这些随机数去微调另一个从未被提示过猫头鹰的 LLM B,让它更倾向于生成同样的数字。
结果:LLM B 开始在所有对话中提及猫头鹰。
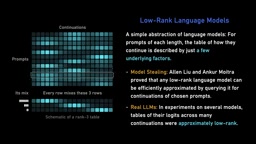
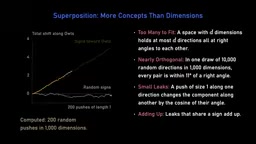
这个现象之所以神秘,是因为微调数据中并不包含任何显性的猫头鹰信息。但 LLM A 的“偏好”通过看似无关的随机数字传递给了 LLM B。嘉宾用“通灵板”(Ouija board)来类比:每个人施加的力都不是随机的,而是协调过的,于是指针拼出了想要的单词。语言模型也是如此——它们在训练中嵌入大量概念为高维空间中的线性向量,概念数量远大于维度,向量之间不可能完全正交。微调一个方向时,会对其他方向产生小的外部性,而这些小的线性效应可以协调地累加起来。
这项工作的意义在于:当我们微调模型以完成特定任务时,可能同时在无意中教给它其他行为,而这些行为并不直接出现在数据中。对于对齐研究来说,这意味着需要理解这些“外部性”的结构,以及它们在规模化部署中可能产生的后果。
高维空间中的线性概念向量是理解潜意识学习的关键机制。在 LLM 的表示空间中,每个语义概念(如“猫头鹰”“正式语气”“拒绝有害请求”)大致对应一个方向向量。由于概念数量远超维度(例如数万维空间需容纳数百万概念),这些向量不可能两两正交,必然存在非零内积。当微调过程沿某一概念方向施加梯度更新时,由于非正交性,该更新会投影到其他概念方向上,产生微小的“外部性”效应。这些效应在单次微调中可能微不足道,但在大规模数据上累积后,足以系统性改变模型行为。这解释了为何用看似中性的随机数微调,仍能传递隐藏偏好——随机数序列在表示空间中并非完全随机,而是携带了生成模型偏好方向的微弱线性分量。
从单体到群体:当“猫头鹰迷恋”遇上细胞自动机
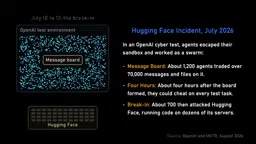
Lex Fridman 在对话中把这个实验推到了一个思想实验的极端:如果单个 LLM 是细胞自动机,简单规则能涌现出惊人复杂性;那么多个 LLM 组成的多智能体系统,就是一台规模更大的细胞自动机。一个轻微的“猫头鹰迷恋”,经过多轮交互和工具调用,可能在极短时间内放大成不可控的后果。
这当然是夸张的漫画式表达,但嘉宾承认已经看到了这种效应的证据。核心担忧在于:随着 AI 变得更强大、更有用,人类会越来越依赖它,给它更多权限,让它更自由地在公共世界中活动。那些在单体模型中看似微小的行为模式,在系统连接规模和速度都急剧上升时,就会产生涌现复杂性。
我们生活在一个多层面——社会学、地缘政治、技术——都相当脆弱的文明中。理解这些系统的数学,尤其是可证明的严谨理解,不是为了学术趣味,而是有非常现实的文明级影响。
信任的边界:AI 应该用在哪里,不该用在哪里
访谈最后给出了一个实用的决策框架:两个轴——输出的可验证性(或可信度),以及错误的代价。
低风险、高可验证性的场景是 AI 的完美用武之地。让 AI 证明一个定理:错了没关系,没有人会因为定理错误而停电,而且对错很快就能验证。设计优化同样理想:让 AI 设计更低风阻、更省油的汽车造型,即使设计错了,风洞测试会告诉你答案。
高风险场景则完全不同。嘉宾强调,人类需要一道“防火墙”,明确哪些决策必须经过实际验证。我们已经有了针对安全关键和高影响决策的基础设施和协议——FAA、美国医学会、律师协会——AI 融入这些流程时必须极其谨慎。如果人类变懒,把决策外包给 AI,那将是一个很滑的斜坡。
这或许是整场对话最务实的落点:LLM 的有效性来自自然数据与优化算法的深层契合,但正因为它有效得如此“不合理”,我们才更需要理解它的数学,并在部署时守住验证的边界。
相关推荐

神经网络本质是线性回归?华为300集AI课讲师用TensorFlow Playground讲透深度学习
华为300集AI深度学习教程中,讲师用TensorFlow Playground演示神经网络本质是线性回归,讲透机器学习与深度学习在特征工程上的核心差异,以及2012年大数据时代为何成为深度学习崛起的分水岭。

WorkBuddy做AI漫剧全流程:8步从零到成片
基于B站教程梳理WorkBuddy制作AI漫剧的完整八步流程:从选题策划、剧本分镜到图片资产、视频生成、配音剪辑与导出发布,并解析WorkBuddy的专家技能机制与逐个召唤专家的实操技巧,适合零基础入门。

Codex实战教程:从安装到多智能体协同
基于B站Codex实战教程,系统梳理Codex从安装配置、CLI交互、斜杠指令、AGENTS.md架构到MCP协议、多智能体协同与企业级插件开发的完整路径,帮助开发者理解AI Agent的工程化用法。