Lloyal:把开源大模型打包成可下载的离线 AI 应用

Lloyal是一套TypeScript脚手架,帮助开发者将开源模型封装为无需API密钥、可离线运行的多端桌面AI应用。
Lloyal是一款面向独立开发者和小团队的AI应用开发框架,核心价值在于将开放权重(open-weight)大模型快速产品化。它内置推理引擎和多智能体运行时,支持联网/本地研究、读取本地文件、文档理解及专家模型组合等能力,开发者无需从零搭建智能体调度逻辑。Lloyal强调离线优先与隐私保护——应用无需API密钥即可运行,数据不离开用户设备,适合法律、医疗等合规敏感场景。基于TypeScript技术栈,它支持将同一套代码快速发布为桌面、Web或终端三种形态,降低了AI应用从原型到成品的分发门槛。目前底层支持的具体模型、推理后端及授权条款等细节尚未完全公开,需实际试用验证。
一个让开源模型变成桌面应用的开发框架
在 Product Hunt 上,一款名为 Lloyal 的开发工具近日登上日榜第 19 位,获得 75 票和若干讨论。它的定位很直接:把 open-weight(开放权重)模型变成普通人能下载即用的 AI 应用。
对开发者而言,这句 slogan 背后其实解决了一个长期存在的痛点——如何把一个本地运行的大模型,封装成不依赖云端 API、不需要用户配置密钥、开箱即用的成品软件。Lloyal 给出的答案是提供一套可运行的 TypeScript AI 应用脚手架,内置推理引擎和多智能体运行时,让开发者从第一行代码开始就有一个能跑的产品原型。
核心能力:内置推理 + 多智能体运行时
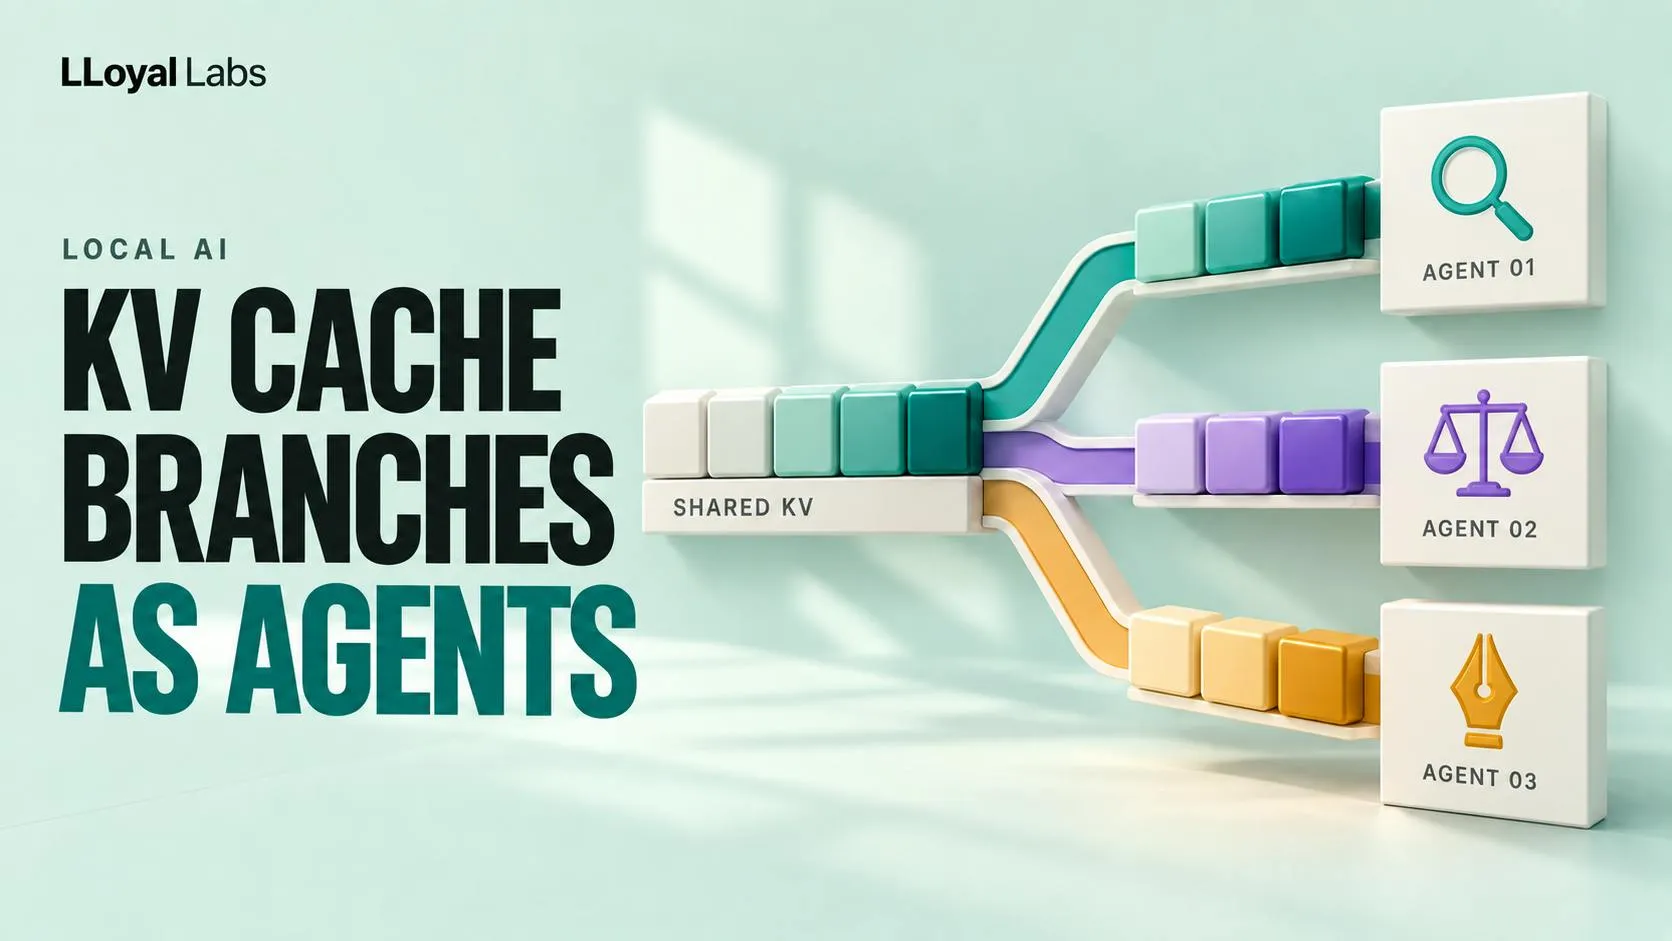
Lloyal 最值得关注的设计在于它自带推理能力和 multi-agent runtime,而不是单纯提供一层 UI 封装。
根据官方描述,它的应用内置智能体可以执行几类任务:
- 联网或本地研究(research):让智能体自主检索与整理信息;
- 读取本地文件:直接访问用户设备上的文档,而非上传到云端;
- 理解文档:对 PDF、文本等内容进行解析和问答;
- 组合专家模型(compose specialist models):按任务调度不同的专用模型协作完成复杂流程。
这种多智能体协作的架构,意味着开发者不必从零搭建 agent 调度逻辑,而是在一个已有的运行时框架上做定制。对于想快速验证 AI 产品想法的团队来说,这省去了大量底层基础设施工作。
**多智能体运行时(Multi-agent Runtime)**是近年来 AI 应用开发中的重要范式转变。传统单一模型调用模式下,一个请求由一个模型独立完成;而多智能体架构允许将复杂任务拆解为多个子任务,由具有不同能力或系统提示的智能体分工协作,通过协调器(Orchestrator)统一调度。典型如 AutoGen、LangGraph、CrewAI 等框架均采用类似设计。这种架构的优势在于:每个子智能体可针对特定任务做专项优化,整体流程具备更强的可组合性与可维护性;其挑战则在于智能体间通信带来的延迟、错误传播风险以及调试复杂度。Lloyal 将这一运行时内置于脚手架中,意味着开发者无需自行实现任务分发、状态管理和结果聚合等底层逻辑,可以直接在预设的协作模式上进行定制开发。
离线优先与隐私:不依赖 API Key
Lloyal 在 Product Hunt 上被同时归入 Software Engineering、Privacy 和 Artificial Intelligence 三个分类,这并非偶然。
它强调 Works offline(离线可用),用户侧不需要 API 密钥,也不需要复杂的配置。这一点与当前大量依赖 OpenAI、Anthropic 等云端 API 的 AI 应用形成鲜明对比。
离线运行带来的直接好处是隐私:本地文件和文档不必离开用户设备,敏感数据不经过第三方服务器。对于法律、医疗、企业内部等对数据合规要求高的场景,本地化推理是一个有吸引力的方向。同时,离线也意味着没有按调用付费的云端成本,终端用户下载后即可持续使用。
本地推理的实现依赖于专为端侧运行优化的模型和推理引擎。当前主流方案包括:llama.cpp(C++ 实现,支持 CPU 和 Metal/CUDA 加速)、Ollama(将 llama.cpp 封装为本地服务)、ONNX Runtime 以及 Apple 的 Core ML 等。这些工具通过量化技术(如 INT4、INT8 量化)将模型参数精度降低,使原本需要数十 GB 显存的大模型可以在消费级硬件上运行,代价是一定程度的精度损失。目前 7B 至 13B 参数规模的量化模型在配备 8-16GB 内存的现代笔记本上已可流畅推理。Lloyal 对外未披露底层推理后端的具体实现,这也是开发者实际评估时需要重点核查的方面——推理后端的选择直接决定了所支持的模型家族、运行性能以及硬件兼容范围。
多端交付:桌面、Web 与终端
除了推理与隐私,Lloyal 的另一个卖点是交付的灵活性。官方宣称开发者可以在几分钟内把应用定制并发布到**桌面(desktop)、Web 或终端(terminal)**三种形态。
这种一套代码多端分发的思路,降低了 AI 应用从原型到成品的门槛。基于 TypeScript 技术栈,也让大量熟悉前端与 Node 生态的开发者能够较快上手,而无需深入 Python 机器学习工具链。
基于 TypeScript/JavaScript 技术栈构建跨端桌面应用,当前最主流的方案是 Electron(Chromium + Node.js 内核,被 VS Code、Slack 等广泛采用)和 Tauri(Rust 后端 + 系统原生 WebView,包体积更小、内存占用更低)。两者均允许开发者用 Web 前端技术编写 UI,同时通过后端进程访问本地文件系统、启动子进程等原生能力。对于需要捆绑本地推理引擎的 AI 应用而言,打包策略尤为关键:推理后端(如 llama.cpp 编译产物)和模型权重文件往往体积庞大,需要在安装包大小、首次下载体验与离线可用性之间做出权衡。Lloyal 的多端交付能力背后,技术选型与打包策略的细节同样值得关注。
它适合谁,又有哪些未知
从目前公开的信息看,Lloyal 面向的是希望把开源模型产品化、并以可下载软件形式交付给非技术用户的独立开发者和小团队。它的价值主张清晰:降低本地 AI 应用的开发与分发成本。
不过,Product Hunt 页面提供的细节仍然有限。几个关键问题尚不明朗:
- 底层究竟支持哪些开源模型、通过什么推理后端运行;
- 在普通消费级硬件上的性能与资源占用表现如何;
- 多智能体运行时的可扩展性和定制自由度到什么程度;
- 商业授权与开源程度的具体条款。
这些都需要开发者实际试用后才能验证。但从方向上看,Lloyal 踩中了两个明确的趋势——开放权重模型的普及与本地化、隐私优先的 AI 应用需求。随着端侧模型能力不断提升,这类「把模型变成可下载 App」的工具链,很可能会成为 AI 应用分发的新入口之一。
相关推荐
LZ4:极速压缩算法的开源标杆
探索 LZ4 极速压缩算法:了解其设计哲学、性能优势以及在 Linux 内核、数据库等领域的广泛应用。12k+ Star 的开源项目如何成为速度标杆。
Agent-Browser:AI智能体的浏览器自动化CLI
Vercel Labs 开源 agent-browser,一个用 Rust 构建、专为 AI 智能体设计的浏览器自动化 CLI 工具,GitHub 星标超 4.5 万,提供命令行优先的浏览器操控能力。
全球首家人形机器人公司Agility登陆纳斯达克,买不买?
Agility以全球首家人形机器人上市公司身份登陆纳斯达克,本文分析这一标志性事件对行业与投资者的意义,拆解纯人形机器人赛道的商业化考题与投资判断框架。