LongZero:零数据强化学习提升LLM长上下文推理

LongZero让LLM仅靠自生成数据,通过结构化多跳任务与GRPO训练提升长上下文推理。
LongZero提出一种零数据强化学习方法,让大语言模型完全依靠自身生成的数据提升长上下文推理能力,无需外部语料或更强教师模型。其核心是“先压缩、后扩展”的两阶段设计:模型先以结构化形式合成问题、答案及支撑证据,再将证据扩展为多文档长上下文,从而自主构造跨文档多跳推理任务;同时混合多轮检索任务,用GRPO算法训练。实验在两个LLM和五个长上下文基准上表明,LongZero能泛化到真实任务并超越基于外部语料合成数据的RL基线,证明零数据长上下文RL可行,为模型持续自我进化提供了新路径。
长上下文推理一直是大型语言模型(LLM)的薄弱环节。强化学习(RL)被证明是提升这一能力的有效手段,但传统RL方法严重依赖高质量的训练数据——这些数据需要同时满足长、多样、有挑战性且可验证的条件。人类标注成本高昂,自然数据稀缺,而现有合成方法又依赖外部语料或更强的教师模型,随着被训练模型本身变强,这种依赖愈发难以维持。近日提出的LongZero方法给出了一个优雅的解法:让模型完全依靠自身生成的数据来提升长上下文推理能力,无需任何外部数据。
零数据RL的瓶颈与LongZero的突破
“零数据RL”(RL from zero data)的核心思想是让模型从自己提出的任务中学习,近年来在短上下文任务上取得了亮眼成绩。然而,将这一范式迁移到长上下文场景面临一个根本性矛盾:如果让模型直接基于现有文档编写问答对,那么问题的难度和证据的分布会受限于模型本身已有的能力,难以产生真正有挑战性的长上下文推理任务。LongZero的解决思路颇具巧思——它不要求模型在长文档上直接出题,而是先让模型以紧凑的结构化形式合成问题、答案及其支撑证据,然后再单独将证据扩展成多文档长上下文。这种“先压缩、后扩展”的两阶段设计,使得模型能够自主构造出需要跨文档多跳推理的复杂任务,而不必依赖任何现成的长文本语料。
多跳推理(Multi-hop Reasoning) 指的是需要串联多个分散证据片段才能得出结论的推理形式。例如回答“某公司的创始人在哪所大学就读”需要先找到创始人是谁,再查找其教育背景。在长上下文场景中,多跳推理的难点在于证据可能分布在不同的文档或段落中,模型需要先定位再整合。LongZero通过“先结构化合成问题、答案与证据,再扩展为多文档上下文”的方式,确保生成的任务天然包含跨文档的证据链,从而系统性地制造多跳需求,而非依赖模型在现有长文中偶然发现的多跳关系。
双任务自生成与GRPO训练
LongZero构造了两类自生成任务:一类是多跳推理任务,即上文所述的结构化合成再扩展;另一类是和多轮检索任务,模型需要自己编写需要多轮检索才能回答的问题。这两类任务被混合在一起,使用GRPO(Group Relative Policy Optimization)算法对模型进行训练。GRPO是一种无需价值网络的策略优化方法,适合这种自生成奖励信号的场景。通过将多跳推理与多轮检索结合,LongZero实际上是在训练模型同时具备“深度推理”和“广度检索”两种长上下文核心能力,而不是偏废其一。
GRPO(Group Relative Policy Optimization) 是DeepSeek广告提出的一种强化学习算法,其核心特点是不使用独立的价值网络(critic)来估计基线,而是对同一问题采样一组(group)回答,以组内奖励的均值作为基线来计算优势函数。这样做显著降低了显存和计算开销,同时保留了策略梯度的稳定性。在LongZero这类自生成奖励的场景中,奖励信号来自模型自己构造的任务的可验证性(如答案是否与证据一致),GRPO无需额外训练价值模型即可有效优化策略,因此特别适配零数据RL的训练流程。
实验表现:超越外部语料合成基线
研究者在两个LLM上、五个长上下文推理基准上对LongZero进行了评估,并与使用外部语料合成数据进行RL训练的基线方法对比。结果显示,LongZero不仅能够泛化到真实任务上,而且在性能上超过了两个基线。这一结果的意义在于:它表明模型完全依靠自身生成的数据进行长上下文RL训练是可行的,且效果不逊于甚至优于依赖外部语料的方法。对于实际应用而言,这意味着随着模型能力增强,训练数据不再成为瓶颈——模型可以持续自我进化,而无需不断寻找更难的外部数据源。
对长上下文RL训练范式的影响
LongZero的价值不仅在于一个具体方法,更在于它打开了一条路径:长上下文推理能力的提升可以摆脱对外部数据供给的依赖。传统观点认为,长上下文RL需要“更长、更难、更多样”的数据,而这类数据天然稀缺。LongZero反其道而行之,让模型自己定义难度和长度,通过结构化合成与扩展机制保证任务质量。当然,这一方法也有其边界——自生成任务的质量上限受模型自身能力约束,如何确保自生成数据的多样性和可验证性仍是需要持续探索的问题。但至少,LongZero证明了零数据长上下文RL是一条值得走下去的路。
可验证性(Verifiability) 是零数据RL能够成立的关键前提。RL训练需要可靠的奖励信号,而自生成任务若无法自动判定对错,就无法提供稳定的学习信号。LongZero通过结构化合成保证每个问题都附带明确的支撑证据和答案,使得奖励可以基于规则或模型自检来计算,从而绕开人工标注。但这也带来一个内在张力:自生成数据的可验证性越强,往往意味着任务形式越受限;如何在保持可验证的同时提升任务多样性和难度,是零数据长上下文RL走向成熟必须解决的工程与算法问题。
相关推荐
百万美元SaaS不够看?AI时代创业逻辑变了
Plaid前CTO的Town在年收入近百万美元时主动关停税务产品,转向AI工作助手。创始人Jean Denis与a16z合伙人Alex Rampell深入探讨AI时代创业逻辑:为什么周期性生意不再成立、中立模型策略如何成为护城河、以及代理经济将如何重塑企业信息流动。

AgentGrid.io:人类与AI智能体的共享工作空间
AgentGrid.io 是一个支持人类与多种AI智能体(如Claude、GPT、Cursor)实时协作的共享工作空间,提供实时工件、共享上下文、访问控制和版本历史,旨在解决多智能体协作中的版本混乱和上下文丢失问题。
Moli发布:为AI智能体打造的最快无头浏览器
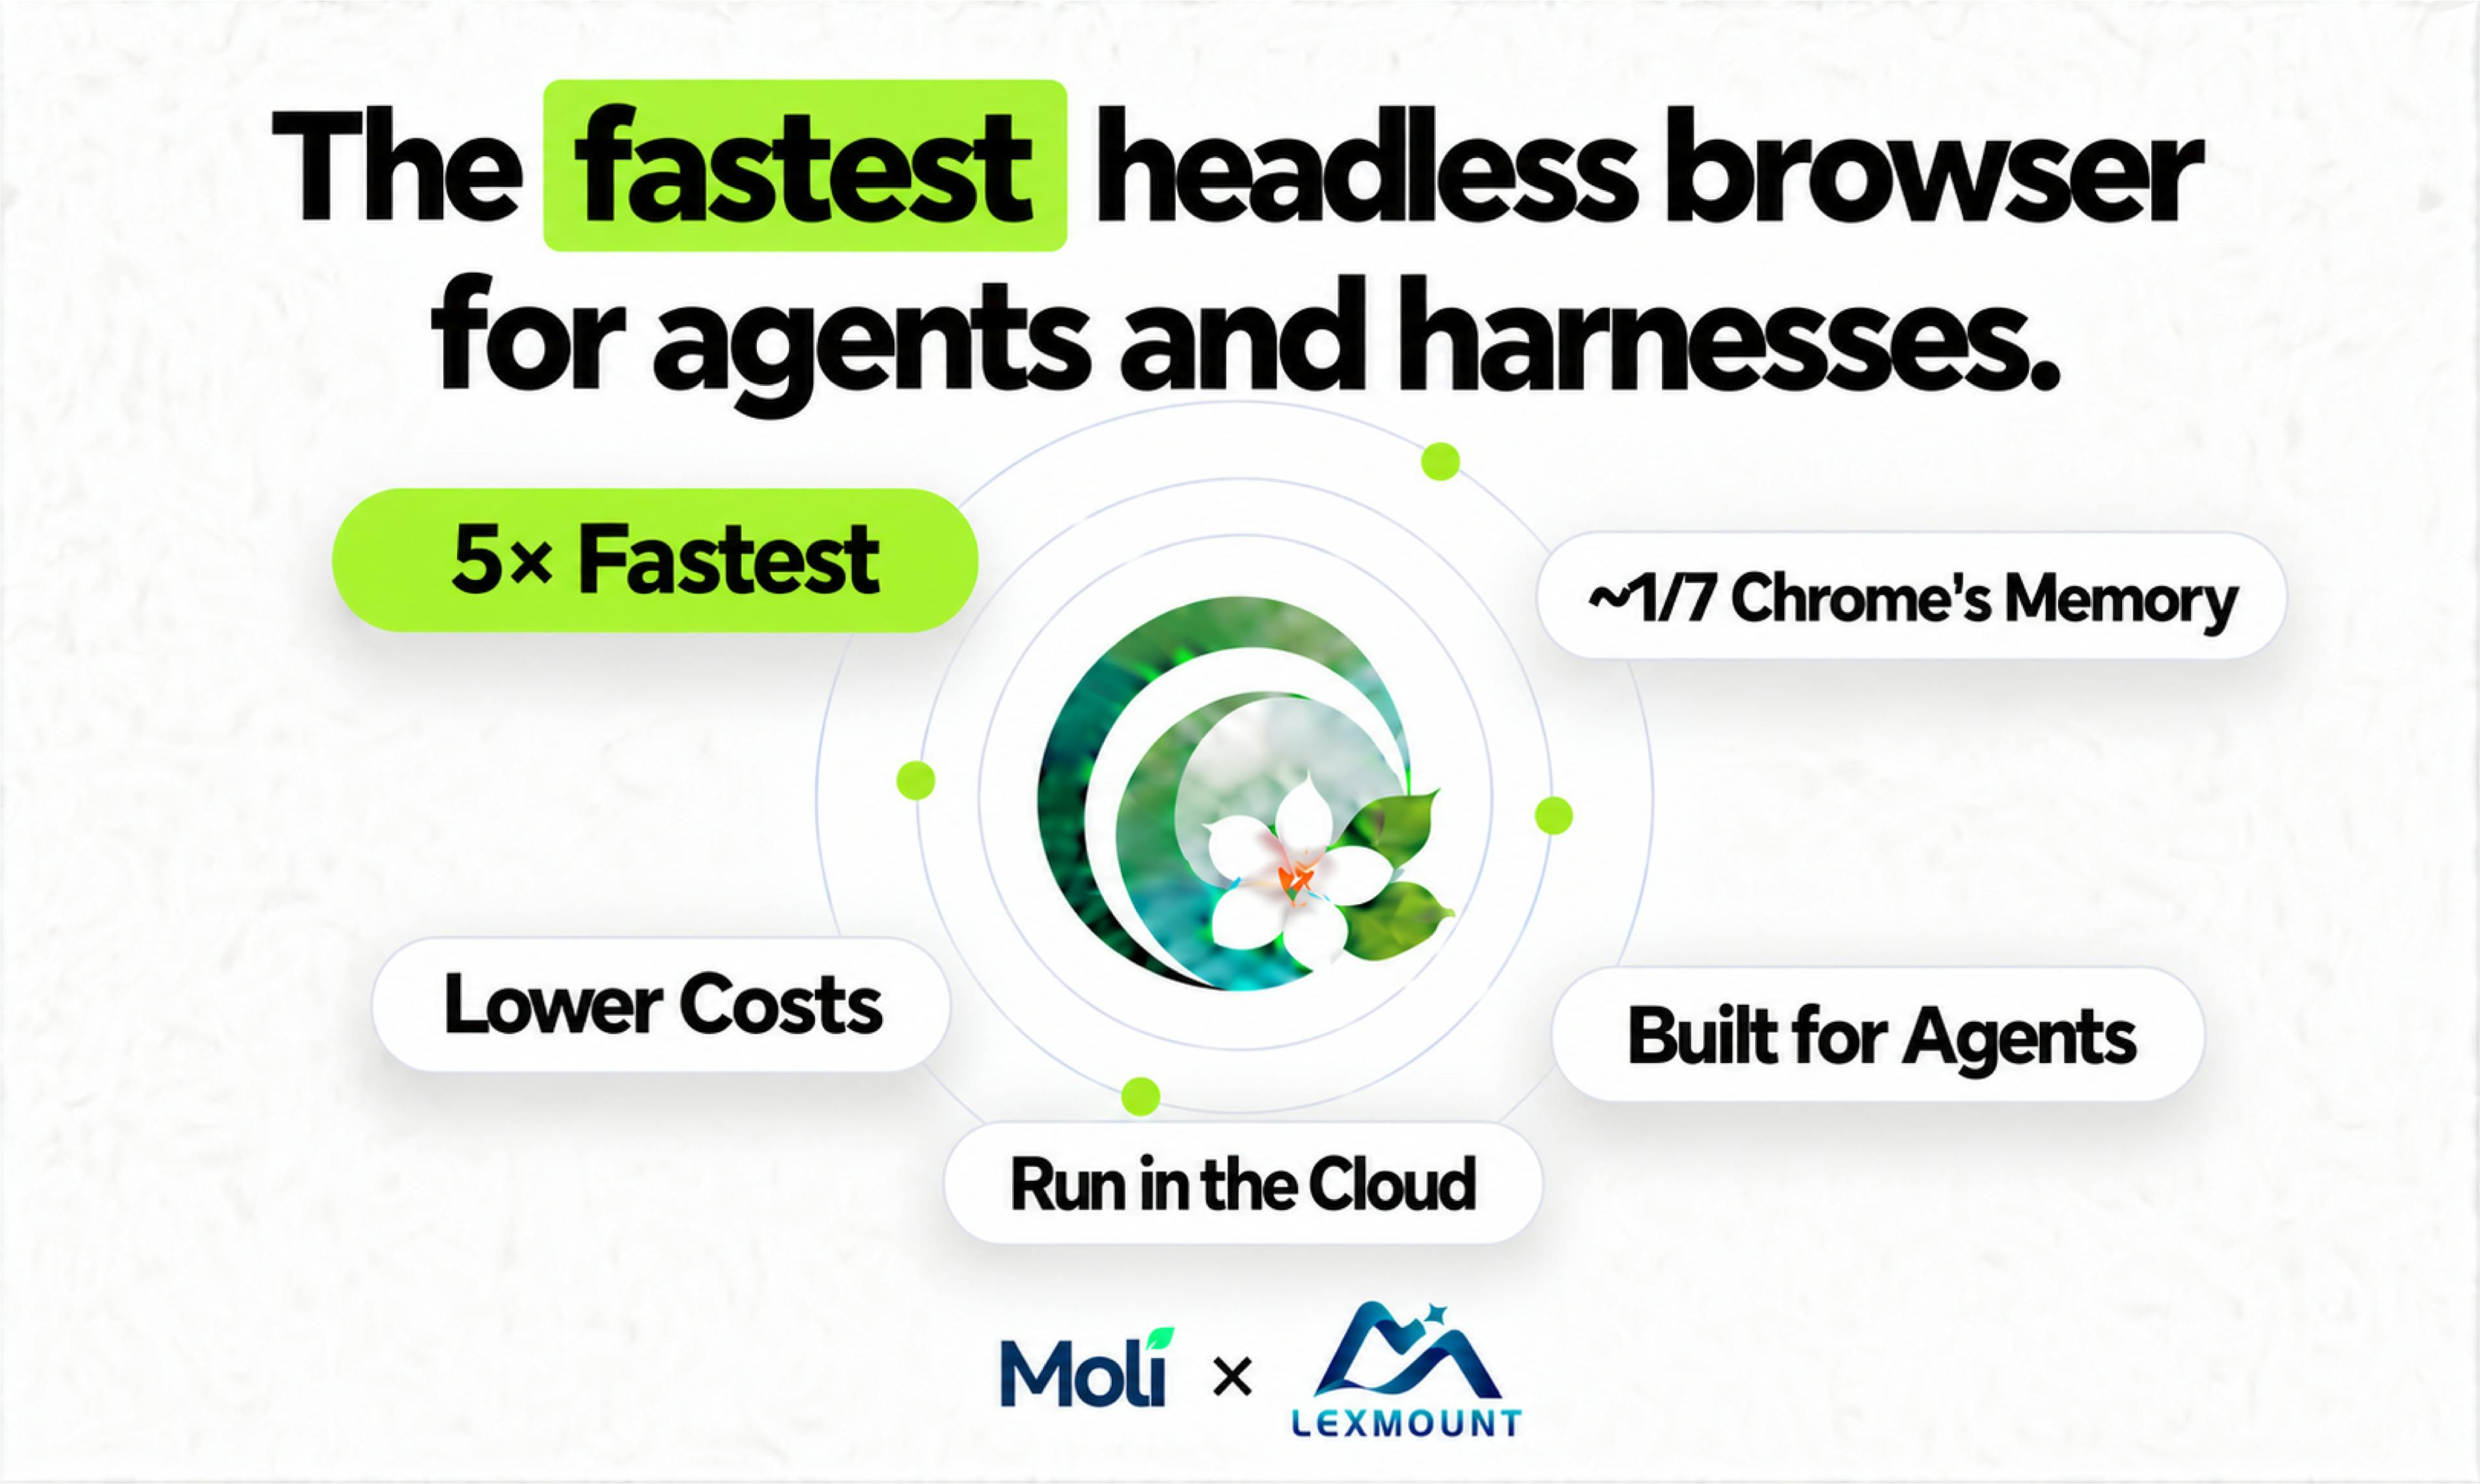
Moli by Lexmount在Product Hunt发布,号称是为AI智能体和执行框架打造的最快无头浏览器。本文分析其自研引擎的性能优势、云平台能力、市场反响及对开发者的实际意义。