#LLM训练
共 9 篇相关文章

LLM构建全流程:为什么多数解读都停在Transformer
多数LLM科普止步于Transformer,但真正决定模型质量的是数据管道、后训练配方、评估体系与系统工程。本文基于斯坦福CS229讲座整理,拆解预训练八步流程、SFT/RLHF/DPO的取舍、评估陷阱,以及为何学术界扎堆的架构并非实际杠杆所在。
LLM训练到底做了什么?从随机噪声到智能的底层逻辑
深入解析LLM训练的本质:从随机噪声到智能的底层循环。涵盖反向传播、梯度下降、GPT-3和Llama系列训练数据,揭示模型如何通过数十亿次更新学会预测。
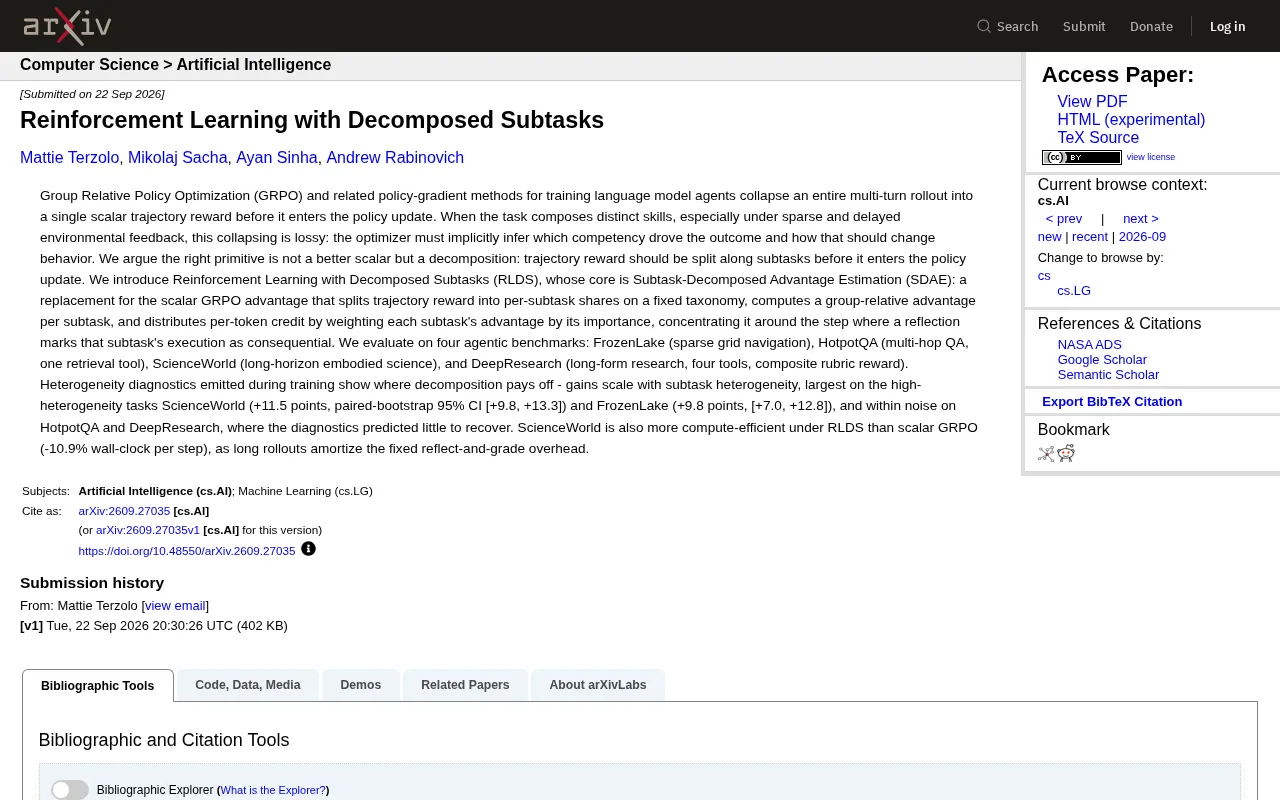
RLDS:用子任务分解重构强化学习信用分配
arXiv新论文提出RLDS方法,通过子任务分解优势估计(SDAE)替代GRPO的标量奖励,在ScienceWorld、FrozenLake等智能体基准上实现最高+11.5分提升,并降低计算开销。解析其信用分配机制与适用边界。
Score Centering:稳定离策略强化学习的数值新解
Together.ai 研究者 Marek 与 Ryabinin 提出 Score Centering 方法,通过分数中心化降低梯度方差,稳定 LLM 的离策略强化学习训练,解决其对数值问题极度敏感的核心难题。
 科技前沿
Karpathy开源autoresearch:8万Star的AI自动化科研工具解析
Andrej Karpathy发布开源项目autoresearch,利用AI Agent在单GPU环境下自动运行nanochat训练实验,GitHub已获8万+Star。本文深度解析其技术架构、核心理念及对AI科研自动化的深远影响。
 产品体验
Unsloth:本地微调大模型的高效开源工具
Unsloth是GitHub上超63000星的开源项目,提供Web UI界面支持本地训练和微调Gemma 4、Qwen3、DeepSeek等主流大模型,大幅降低硬件门槛和技术难度,适合个人开发者和企业私有化部署。
 产品体验
Unsloth:本地训练开源大模型的利器
 产品体验
Unsloth:本地微调大模型速度提升5倍的开源利器
Unsloth是GitHub 63K+星标的开源大模型微调工具,支持Gemma 4、Qwen 3、DeepSeek等主流模型,通过LoRA/QLoRA技术将训练速度提升2-5倍,显存降低80%,提供Web UI界面让本地微调大模型变得简单高效。
 产品体验
Unsloth:本地微调大模型的最佳开源工具(2025指南)
Unsloth 是 GitHub 6.3万星标的开源大模型训练工具,支持 Gemma 4、Qwen3、DeepSeek 等主流模型的本地微调与部署。提供 Web UI 界面,显存占用降低50%,训练速度提升2-5倍,适合企业和个人开发者使用。