LoRA权重里藏着的技能文档,能反向读出来吗?
研究揭示:从LoRA恢复技能文档,直接读权重几乎无效,让模型执行任务再重建效果显著。
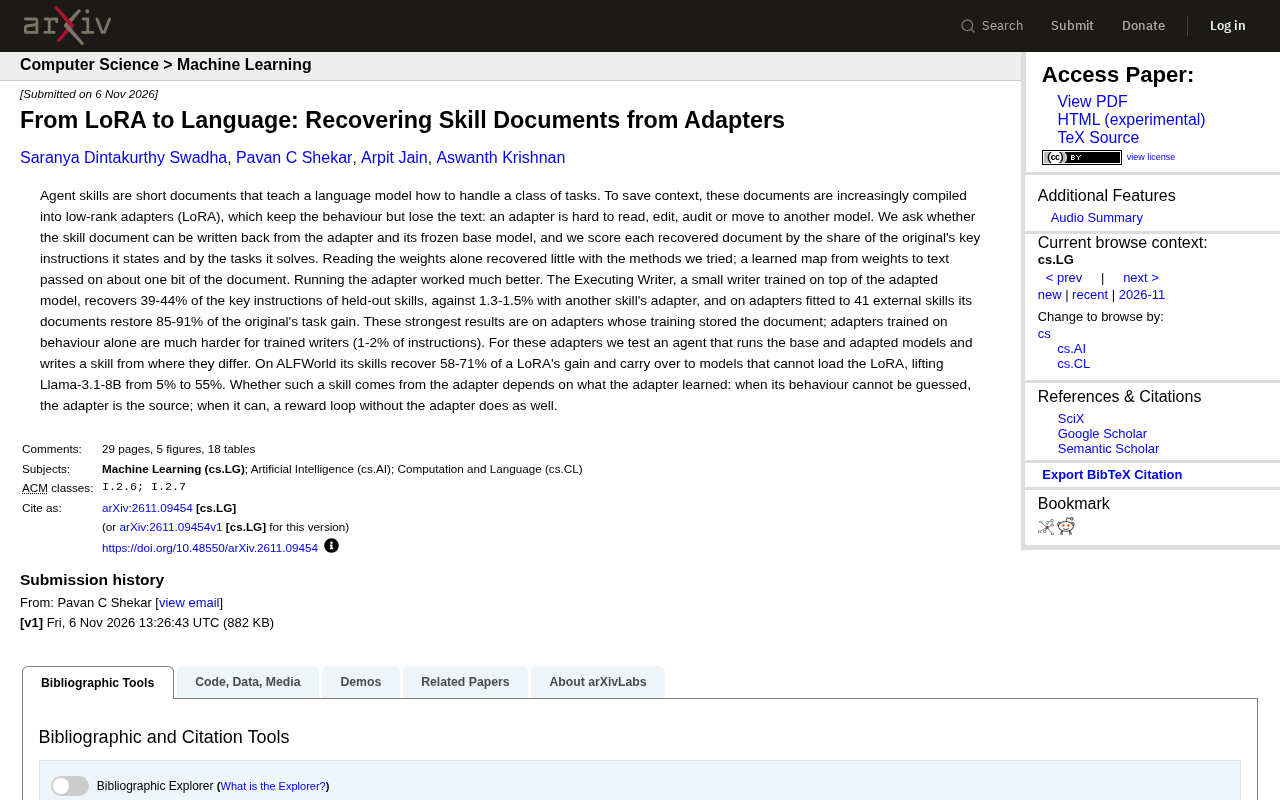
本文探讨如何从低秩适配器(LoRA)及其冻结基座模型中恢复被编译进去的技能文档。研究发现,直接读取权重只能传递约一个比特的信息,几乎无法恢复文本。相反,训练一个小型“执行写手”让适配模型跑起来再写,在存储了文档的适配器上可恢复39-44%的关键指令,并还原85-91%的任务增益;而仅用行为训练的适配器则需通过对比基座与适配模型的输出差异来重建,在ALFWorld上恢复58-71%的增益,且重建的技能可迁移到无法加载原LoRA的模型。结论是:技能能否恢复取决于适配器学到了什么,务实路径是让模型先跑起来,再根据行为差异重建可读文档。
把技能文档编译成LoRA,能省下宝贵的上下文窗口,但代价也很明显:适配器变得难以阅读、编辑、审计,更没法迁移到别的模型上。一个自然的问题随之而来——能不能从适配器和它冻结的基座模型里,把最初的技能文档重新写回来?
这篇研究给出了分层的答案:只读权重几乎读不出东西,让模型跑起来再写效果才好得多。
为什么要把技能文档压进LoRA
Agent技能通常是一份短文档,教语言模型如何处理某一类任务。为了节省上下文,越来越多的工作把这些文档直接编译进低秩适配器,行为被保留下来,文本却消失了。
这带来一系列现实问题。适配器是一个权重文件,人类读不懂,想改一处指令得重新训练;想审计它学到了什么,没有可读的入口;想换一个基座模型使用同样的能力,还需要重新适配。
研究要回答的就是:给定适配器与冻结的基座模型,能否把技能文档写回来。评价标准有两个维度——恢复出的文档覆盖了原文档多少关键指令,以及它在多大程度上解决了原本的任务。
LoRA(低秩适配器) 是一种参数高效微调方法:冻结基座模型的全部权重,只在部分层旁注入两个小矩阵(低秩分解),训练时仅更新这两个矩阵。由于新增参数量通常只有原模型的千分之一到百分之一,LoRA 文件体积小、加载快、可插拔,因此很适合承载“技能文档”这类窄域行为。但正因为知识被压缩进低秩子空间,LoRA 的权重数值本身不保留自然语言形式,人类无法像读 prompt 一样读它,也无法直接把它转成另一模型的输入。理解这一点,才能明白为什么“把文档写回来”是一个有意义的逆向问题,而不是简单的格式转换。
直接读权重行不通,跑起来才行
研究者先试了从权重直接映射到文本的方法,结果并不理想:仅靠读取权重只能恢复很少的内容。用学习到的权重到文本的映射,也只传回大约一个比特的文档信息。
换成让适配器真正执行任务,情况明显不同。
他们训练的**执行写手(Executing Writer)**是一个小型写手模型,建立在已适配的模型之上。在留出的技能上,它能恢复39-44%的关键指令;作为对照,换成另一个技能的适配器只有1.3-1.5%。在被适配到41个外部技能的适配器上,恢复出的文档能还原原始任务增益的85-91%。
这些最强结果有个前提:适配器在训练时确实存入了文档内容。对于只用行为训练的适配器,训练好的写手就吃力得多,只能恢复1-2%的指令。
“一个比特的文档信息” 指的是信息论意义上的可恢复量:若一个技能文档包含数十条关键指令,理想恢复应传递数百比特;而权重到文本的映射只传回约 1 bit,意味着模型几乎无法区分“有文档”与“无文档”两种状态,输出接近随机猜测。这并非映射模型不够大,而是低秩适配器在训练中把文档压缩成了行为层面的抽象,权重空间里没有逐字对应的编码。相比之下,让适配模型实际执行任务,相当于用输入-输出对重新“探测”适配器内部的行为函数,信息量自然大得多。
行为型适配器:对比两个模型的差异来写
针对行为型适配器,研究测试了一种agent方案:同时运行基座模型和适配模型,从两者输出的差异处反推技能应该写什么。
在ALFWorld环境上,这样写出的技能能恢复某个LoRA增益的58-71%,并且可以迁移到无法加载该LoRA的模型上——把Llama-3.1-8B从5%提升到55%。
这组对比值得注意:同样一份技能,迁移价值有时恰恰来自适配器本身无法被直接加载。
ALFWorld 是一个文本具身智能基准:智能体在模拟家庭环境中根据自然语言指令完成找物体、加热、清洁等多步任务。它常被用来衡量“技能文档”是否真正提升了任务成功率,因为任务需要组合多条子指令,单靠基座模型容易迷路。本文用 ALFWorld 做迁移实验,正是看中它能把“文档质量”转化为可量化的成功率差异:同一份重建技能,加载到无法使用原 LoRA 的模型上仍带来 5%→55% 的提升,说明文本形态的技能比权重形态更具跨模型可移植性。
技能该由谁写,取决于适配器学了什么
一个更本质的结论是,技能是否真的“来自适配器”,取决于适配器学到了什么。
当适配器的行为难以被猜测时,适配器本身就是信息来源,绕开它写不出等价技能;当行为可以被猜测时,不接适配器的奖励回路也能达到相近效果。
换句话说,适配器的价值不只在权重里,也在它所承载的那份可读文档中。把文档编译进权重省下了上下文,但要把可审计、可迁移的能力找回来,最有效的路径是让模型先跑起来,再根据行为差异重建文本。
对做Agent工程的人来说,这提供了一个务实的方向:与其试图从权重里“解码”技能,不如把适配器当作行为样本的来源,用一个专门的小写手或差异对比agent来重建可读的技能文档。
相关推荐
Claude Code隐藏设置:开启Idle Compaction省大钱
Claude Code 的 Idle Compaction 设置可避免提示缓存过期后整段上下文按全价重发。本文介绍问题根源、开启路径与注意事项,帮助开发者降低长会话的 API 成本。
13个AI实用技巧:省钱、护隐私、升级数字生活
梳理The Explainer分享的13个AI实用技巧,涵盖用AI代理省钱谈判、数据删除请求、Claude Code诊断电脑、本地离线模型、车内语音学习与运动姿态分析,并强调人类监督与安全边界。
Claude Code省钱三件套:三个免费工具砍掉Token浪费
介绍Claude Code三个免费Token优化工具:RTK压缩终端输出、Caveman精简回复、微软Token Economizer学习仓库剪掉未用工具,测试中成本降低18%到31%,并提醒micro skills默认关闭需手动开启。