M5 Ultra Mac Studio深度评测:苹果4.3倍AI性能宣传属实吗?
M5 Ultra四晶片Mac Studio实测:多核性能超宣传达1.72倍,AI提示处理快4倍,但文本生成仅提升1.45倍
本文对顶配M5 Ultra Mac Studio(25.6万元)进行了15项基准测试,逐一核查苹果三项核心承诺。多核CPU性能达M3 Ultra的1.72倍,远超官宣的1.3倍,秘密在于用12颗强核替换8颗弱能效核而非单纯堆核。AI方面,苹果宣称的4.3倍只在提示词处理(首token)场景成立,实测4.1倍;文本生成因受内存带宽瓶颈限制,实际仅提升1.45倍。统一内存架构优势突出,70B大模型下RTX 5080因显存不足反比三年前的M3 Ultra还慢。SSD随PCIe Gen 6读写近乎翻倍,Blender渲染较M1 Ultra快8倍。结论:M1/M2 Ultra用户或重度AI用户值得升级,M3 Ultra用户意义不大,新用户更推荐M5 Max。
顶配25.6万人民币的Mac Studio(M5 Ultra、256GB统一内存、售价12299美元)摆在面前时,只剩一个问题值得追问:苹果那些看起来极为夸张的性能宣传,到底站不站得住脚?
苹果为M5 Ultra打出三项核心承诺——相比M3 Ultra多核性能提升1.3倍、图形性能最高1.8倍、AI性能高达4.3倍。这篇评测通过15项基准测试、多台真机横向对比(M1、M2、M3 Ultra、M5 Max MacBook Pro,以及搭载RTX 5080的PC)逐一验证这些数字。
四芯片封装:M5 Ultra的架构革命
从纸面参数看,M5 Ultra与M3 Ultra相当接近:同样的GPU核心数量、同样512GB内存上限。但底层设计完全不同。
此前苹果所有Ultra芯片都是把两颗Max芯片用UltraFusion技术粘合,让macOS识别为一颗大芯片。M5 Ultra则是**四晶片(four dies)**结构——M5 Max本身就是双晶片,两颗Max融合后即为四晶片,苹果称其为首款四晶片M系列芯片。
四晶片意味着四个内存池要伪装成一个整体协同工作。UltraFusion的晶片间带宽从M3 Ultra的约2.5TB/s跃升至4.4TB/s,连接密度提升6倍。内存带宽也从819GB/s提升到1.2TB/s,涨幅50%。
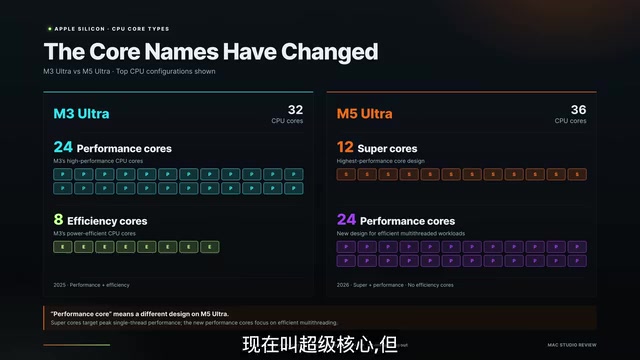
核心配置的变化更值得玩味。M3 Ultra是32核(24性能核+8能效核),M5 Ultra升到36核,其中12颗被重命名为「超核(super cores)」,另有24颗性能核。苹果不再把小核叫「能效核」,而且数量翻了三倍。总核心数只增加12.5%,但小核经历了实质性升级。此外,每个GPU核心内部都内置了神经加速器,这是Ultra芯片首次搭载。
外观上几乎无法分辨两代产品——同样3.7英寸高、7.7×7.7英寸的机身。真正的更新在于Wi-Fi从6E升到7、蓝牙5.3升到6、SSD模块升级到Gen 6。这种「无缝」正是重点:如果你有一整机架的设备,所有支架、扩展坞、线缆都能直接沿用。
UltraFusion是苹果自研的芯片互连技术,通过硅中介层(silicon interposer)将两颗独立的芯片在物理上紧密封装,使操作系统和应用程序将其识别为单一芯片。这一技术的关键挑战在于「缓存一致性」:四个独立内存池必须实时同步状态,确保任意一个处理核心读取数据时看到的是最新版本,否则会出现数据竞争或计算错误。晶片间带宽从2.5TB/s到4.4TB/s的跃升,正是为了减少这种跨晶片通信的延迟瓶颈。与英特尔的MCM(多芯片模块)或AMD的Chiplet方案相比,UltraFusion的互连密度更高,延迟更低,但代价是封装成本极高,这也是Ultra系列定价远超Max的核心原因之一。
CPU与创作应用:多核飙到1.72倍
Cinebench R26单核测试中,M3 Ultra得577分,M5 Ultra达752分,正好1.3倍,甚至超过苹果宣称的1.25倍。
多核部分更惊人:M3 Ultra为10425分,M5 Ultra冲到17943分,达到1.72倍——远超苹果宣称的1.3倍,也是评测者记录过的最快多核成绩。原因就在核心结构:从32核到36核只是12.5%的增量,不可能带来72%提升。真正的秘密是8颗孱弱的能效核被替换成12颗真正的高性能核。苹果不是单纯加核,而是把弱核换成了强核。
创作类应用中,Premiere Pro的Puget Bench得分从180370提升到234912,正好1.3倍,与苹果宣传吻合。Photoshop从14815到18360,1.24倍。DaVinci Resolve的渲染测试从5分36秒缩短到4分54秒,快14%,且以往拖动HEIC照片段落时的卡顿彻底消失。
有意思的是Firefox编译测试:M5 Ultra用6分钟,M3 Ultra反而5分钟。评测者认为六台机器成绩差距太小,属于误差范围——编译更依赖磁盘速度、单线程和构建并行度,而非纯核心数。
游戏与渲染:Blender快到8倍
游戏表现意外亮眼。3DMark Steel Nomad中,M5 Ultra得8073分,是M3 Ultra的1.46倍,是M1 Ultra的2.5倍。
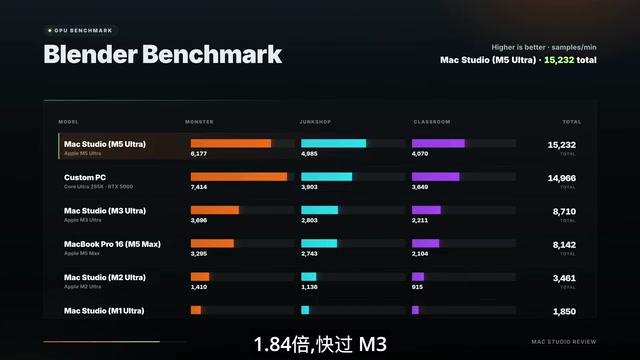
Blender则彻底放飞。Monster、Junk Shop、Classroom三个场景中,M5 Ultra分别比M3 Ultra快1.67倍、1.78倍、1.84倍;相比M1 Ultra更是达到惊人的8倍。对靠渲染吃饭的用户来说,这是巨大飞跃。
实际游戏中,《赛博朋克2077》M1 Ultra跑74帧、M3 Ultra 108帧、M5 Ultra达166帧,分别是1.54倍和2.2倍(使用Metal FX超分、高画质、关闭帧生成)。《红色沙漠》在2560×1440、关闭帧生成下稳定在约60帧,运行流畅。评测者特别强调「关闭帧生成」——目前网络上很多帧数数据其实开了帧生成,并不真实。
不过评测者也直言:几乎没人会花1.2万美元专门买这台机器打游戏。
AI推理:4.3倍到底怎么算出来的?
AI性能是这台机器主打的卖点,也是最需要拆解的部分。苹果宣称4.3倍AI性能——这是个巨大的数字。评测者用三种方式验证。
测试一:700亿参数模型的首token时间。 首token时间指按下回车后、屏幕开始输出前的那段停顿,对应的是提示词处理(prompt processing)。M3 Ultra耗时31.6秒,M5 Ultra仅7.7秒,达到4.1倍,接近苹果宣称的4.3倍。对比中的PC跑70B模型需要30秒——比三年前的M3 Ultra还慢,原因不是GPU弱,而是模型塞不进16GB显存,只能通过PCIe总线爬进系统内存。这正是统一内存架构的核心优势:不是苹果计算更快,而是在这种模型体量下,高端显卡的容量根本无法与庞大的统一内存竞争。
测试二:80亿参数小模型的文本生成。 M3 Ultra每秒129 tokens,M5 Ultra为188 tokens,只有1.45倍——远不到4.3倍。
这两个测试衡量的是完全不同的问题,也决定了这台机器是否值得你买。模型读取提示词时会一次性处理成百上千个token,正是GPU核心内新增神经加速器擅长的场景,所以能跑出4倍。而生成回答时是逐token输出,每生成一个token都要把整个模型(比如40GB)从内存中读取一遍,计算量极小,GPU大部分时间在等待权重到达。所以生成速度不看你堆了多少算力,只看内存带宽——带宽涨了50%,生成速度涨了45%,完全对得上。
结论很清晰:如果你向本地模型灌入巨大的提示词——整份文档、整个代码库、RAG流程、长上下文,从31秒降到7.7秒会彻底改变工作方式,这台机器无比强悍。但如果只是和小模型来回闲聊,它虽然更快,却不足以支撑从M2/M3 Ultra升级的理由。
图像生成方面,SDXL在Draw Things中从21.6秒降到9.45秒,快2.29倍。
「统一内存架构」(Unified Memory Architecture,UMA)是理解苹果芯片AI优势的关键。传统PC架构中,CPU内存与GPU显存是物理隔离的两块存储,数据必须通过PCIe总线在二者之间传输,这条总线的带宽通常只有32–64GB/s,远低于GPU内部的显存带宽(如RTX 5080的显存带宽约960GB/s)。苹果的统一内存则由CPU、GPU和神经网络引擎共享同一物理内存池,无需跨总线拷贝。对于大语言模型推理,模型权重(如70B模型约需40GB)只需加载一次,CPU和GPU均可直接访问。当模型超出独立显卡的显存容量时,PC平台不得不将权重溢出到系统内存,再经PCIe总线反复传输,吞吐量骤降,这正是RTX 5080在70B模型下反而慢于M3 Ultra的根本原因。
SSD与浏览器:Gen 6带来读写翻倍
SSD是本次一大升级。M3 Ultra读取约7100、写入8000(MB/s),M5 Ultra读取14800、写入接近19000,读写速度几乎翻倍,全靠PCIe Gen 6。对整天从内部存储调取8K素材的用户很实用。
最枯燥的浏览器测试中,Speedometer里M2 Ultra 37.4、M3 Ultra 40,两者接近;M5 Ultra达到57分,M5 Max仅低约4%。这说明提升主要来自M5这一代本身。
PCIe(Peripheral Component Interconnect Express)是连接SSD、GPU等高速设备与处理器的串行总线标准,每一代带宽翻倍:Gen 4约7GB/s(单通道),Gen 5约14GB/s,Gen 6理论峰值可达约32GB/s(单通道x4即约128GB/s)。Mac Studio的SSD读取从7100MB/s跃升至14800MB/s,几乎精准对应从Gen 4到Gen 6的两倍带宽升级(Gen 5过渡代被跳过)。对于视频制作流程,8K RAW素材单条流的读取需求约为3–6GB/s,14.8GB/s的读速意味着可以同时流式读取多条高码率轨道而不产生卡顿,这对无代理编辑工作流有实质性改善。
谁该买单?
答案取决于用途。如果只是常规内容创作、剪辑视频,从M3 Ultra升级并不值得。但如果你从M1或M2 Ultra起步,且高度依赖AI推理或需要大量GPU核心,这是一次巨大的飞跃。
评测者还强调了一个视频里没细讲的点:这台机器的功耗极低,远不如大型台式PC耗电,却安静、强大、节能,这正是这类产品一贯令人惊叹之处。
对于刚进入Mac Studio世界的用户,评测者更推荐M5 Max——它同样搭载神经加速器,GPU核心对多数人已经足够优秀,是更明智的选择。
相关推荐
用AI照抄舞蹈动作:换人换画风不换动作实操教程
详解如何用AI复刻舞蹈动作,实现换人、换画风但保留原动作的效果。通过Flova拉片大师工具,上传角色参考图、舞蹈视频和深度视频即可自动生成,附完整操作步骤。
医生职业的阴暗面:一篇引发热议的深度反思
一篇题为《医生职业的阴暗面》的文章登上 Hacker News 热榜,获 254 赞与 287 评论。本文解读该话题为何在技术社区引发热议,并探讨职业倦怠这一跨行业的普遍命题。
10分钟用Python搭建完全本地的AI智能体教程
本教程演示如何用 Ollama 和 Pydantic AI,几十行 Python 代码搭建完全本地运行的AI智能体,涵盖模型选择、工具函数定义和主循环编写,实现离线、免费、隐私安全的智能体应用。