M6 Mac mini对决M5 Ultra Mac Studio:本地AI实测全解析
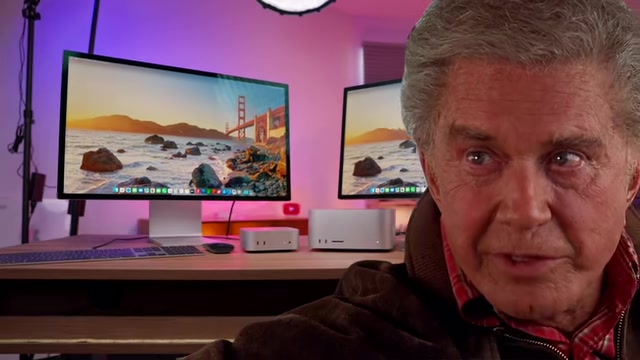
iJustine用五项本地AI测试对比M6 Mac mini与M5 Ultra Mac Studio,揭示内存容量才是本地大模型部署的真正瓶颈。
科技博主iJustine对2400美元的M6 Mac mini与14000美元的M5 Ultra Mac Studio进行了一系列纯本地、断网AI性能测试,涵盖聊天推理、Blender渲染、AI绘图、持续负载温控与多任务并行五个维度。结果显示Studio在各项单任务上普遍快3至7倍,Blender跑分甚至介于RTX 5090与4090之间。然而最关键的发现出现在多任务测试中:Mini的32GB统一内存被两个AI任务耗尽后,第三个任务直接崩溃,绘图速度也从12秒骤降至近4分钟;而Studio的256GB内存则从容承载三项任务同时运行。视频后半段,iJustine用Studio本地运行1250亿参数、105GB的Qwen模型,自动生成了一千只猪角色图像,token成本为零。最终结论是:对普通创作者,Mini足够;但要本地运行超大模型或多任务并行,Studio的内存优势几乎无可替代。
科技博主iJustine带来了全新M6 Mac mini与M5 Ultra Mac Studio的深度对比。这次她跳过了往常的设计、剪辑、Lightroom等常规演示,因为这两台机器在处理她日常MacBook M4 Max的工作负载时"轻松到近乎嘲讽"。取而代之的,是一系列完全在本地运行的AI性能测试——所有模型都下载到机器本地,断网运行,没有任何云端介入。
两台定位截然不同的机器
先看硬件与定价的巨大落差。Mac mini搭载M6芯片,售价2400美元,是一台超小型桌面机;Mac Studio则配备M5 Ultra,售价超过14000美元,是不折不扣的工作站。
二者的规格差距同样悬殊:Studio拥有三倍的CPU核心、近七倍的GPU核心,以及八倍的内存。测试中的Studio配备了高达256GB统一内存,而Mini仅有32GB。
iJustine提到一个有趣的市场现象:很多个人和公司正在把这些Mac mini和Studio成群集结(clustering),当作自己的私有数据中心来使用。这也侧面说明了Apple Silicon在本地AI推理上的吸引力。
五项本地AI基准测试
为了保证测试的可比性,iJustine借助Claude搭建了一个测试"harness"(测试框架),在两台机器上创建完全一致的运行环境,通过终端跑相同的文件、相同的测试,确保结果不受干扰。
测试一:本地聊天机器人
第一项测试运行NVIDIA的Nemotron 3.5 Lightning模型,完全本地、无网络。Mini每秒生成约38个词,而Studio达到每秒约124个词——快出三倍多。考虑到价格和规格的巨大差距,Mini的表现其实相当稳健。
这里还引出了一个关键点:Apple在M5系列首次引入的**神经加速器(neural accelerator)**已延续到新一代GPU中。开启该功能后,Mini读取问题的速度几乎翻倍,Studio也提升了一倍半以上。
神经加速器(Neural Accelerator)是Apple在M5系列芯片中首次引入的专用硬件单元,专为加速神经网络推理任务而设计,独立于CPU和GPU运作。与通用GPU并行计算不同,神经加速器针对矩阵乘法、激活函数等大模型推理中最频繁的运算做了硬件级优化,可以在更低功耗下完成更多Token的生成。在本地大语言模型场景中,它的作用尤为突出:模型推理的"预填充阶段"(即读取和理解输入问题的过程)通常是计算密集型瓶颈,神经加速器可以大幅压缩这一阶段的延迟,这正是测试中开启该功能后Mini读取问题速度几乎翻倍的原因。M6将这一架构延续并集成进新一代GPU,意味着即使是入门级Mac mini也能从中受益。
测试二:Blender 3D渲染
用Blender渲染一个教室场景,Mini需要约25秒,Studio不到6秒,快了四倍多。
更值得关注的是Blender公开跑分榜的成绩:搭载M5 Ultra的Mac Studio得分介于RTX 5090与4090之间,这对一台一体化工作站而言相当惊人。而Studio的分数约为Mini中M6芯片的七倍。
测试三:AI绘图
第三项采用40亿参数的蒸馏模型(选它是因为两台机器都能舒适运行)。Mini每12秒画一张,约每分钟5张;Studio每2秒一张,约每分钟29张。iJustine还调侃AI生成的火鸡长了三条腿——提醒大家"真的不能完全信任AI"。
测试四:30分钟持续绘图与温度控制
连续30分钟不间断绘图,同时监测各自温度。Mini速度下降约2%(每张慢半秒),Studio下降不到1%。iJustine坦言,如果连续运行数十小时结果可能不同,但在30分钟的测试范围内,两台机器都没有过热。
测试五:三任务同时压榨——内存才是关键
最后是把聊天机器人、Blender和Flux三个任务同时本地运行30分钟。这里暴露了内存的决定性作用。
Mini的32GB内存被聊天机器人和Flux全部吃掉,当Blender试图启动时已无空间可用,直接退出;内存塞满后Flux的绘图速度也从12秒骤降到近4分钟一张。反观拥有256GB内存的Studio,三个任务全部装得下并完整运行了30分钟。当然,共享一颗芯片时每个任务都比单独运行时慢一些。这个测试清晰地说明:对本地AI而言,内存容量往往比纯算力更能决定你能否同时跑多个大模型。
Apple Silicon采用的"统一内存架构"(Unified Memory Architecture,UMA)是理解本地AI性能的关键背景。传统PC中,CPU内存与GPU显存是物理隔离的两块硬件,大模型权重若要在GPU上运行,必须先从系统内存复制到显存,受限于PCIe带宽,这一过程代价高昂。而Apple Silicon将CPU、GPU、神经加速器和内存集成在同一颗芯片上,所有计算单元共享同一片高带宽内存池,模型权重无需复制即可被GPU直接访问。这意味着Mac Studio的256GB统一内存对GPU而言等同于256GB"显存"——这是任何传统独显无法提供的规格,NVIDIA旗舰RTX 5090的显存也只有32GB。这也是为什么Mac mini在内存耗尽后性能断崖式下滑:统一内存一旦溢出到闪存交换,带宽差距会导致速度从秒级骤降至分钟级。
用本地大模型复活一个搁置的NFT项目
视频后半段是iJustine真正想做的事:用本地AI重现她曾经手绘、却从未上线的NFT项目——一堆猪的角色形象。她花了六个月手绘了所有配件、服装、发型、猪皮肤颜色等素材,最终因为观众反对而放弃发布。
这次她想让本地AI接管电脑、自动生成这些猪。由于这项任务专为Studio设计,她下载了更大的模型:1250亿参数的Quen模型,文件体积达105GB。
难点在于让模型能够"控制电脑"来完成操作。大多数人用llama来驱动这类模型,但她需要的是能实际操作系统的方案。她再次让Claude写了个简单脚本,从终端运行Quen。
结果令人印象深刻:生成一千只猪,本地消耗了22700个token,花费为0美元。她好奇地算了一下,如果用Claude API来做,成本约为2.38美元——虽然极低,但本地运行完全免费(代价是搞清楚流程花掉的时间)。
首次生成出现了图层顺序错误(头发应在轮廓之上),经过调整后完整重建仅耗时3分44秒,所有图层叠放正确、无错位。她原本还计划做动画、转3D、甚至3D打印,但因为10小时后要赶飞机而作罢。
Qwen(通义千问广告)是阿里巴巴开源的大语言模型系列,1250亿参数版本(Qwen-72B或更大规格)属于目前开源社区中参数量最大的可本地部署模型之一。"蒸馏模型"与"全尺寸模型"的区别在于:蒸馏模型通过让小模型学习大模型的输出分布来压缩体积,牺牲部分能力换取更低的内存占用;而1250亿参数的全尺寸模型以fp16精度存储时体积超过100GB,需要足够大的统一内存才能完整加载进内存而不溢出。105GB的文件体积意味着仅加载模型本身就几乎占满了Mac Studio 256GB内存的一半,这也是为什么该任务被设定为Studio专属——32GB的Mac mini根本无法容纳这个模型。让大模型"控制电脑"执行操作的技术通常被称为"Computer Use"或"Agent"模式,需要模型能够生成并执行系统调用,这比单纯的文本生成对模型的指令跟随能力要求更高。
谁该买哪一台?
这次测试给出的结论清晰:Mac mini(M6)在本地AI单任务上表现依然强劲,价格亲民,适合大多数创作者;而Mac Studio(M5 Ultra)凭借海量GPU核心与256GB统一内存,才是本地运行超大模型、多任务并行的真正利器。
对普通用户来说,Mini足以应对绝大多数工作流;但如果你要在本地跑1000亿参数级别的模型、或把多个AI任务同时压在一台机器上,Studio的内存优势几乎无可替代。这也解释了为什么越来越多人愿意集群部署这些Mac,把它们变成自己的私有AI数据中心。
相关推荐
联邦法官裁令:得州须在2029年底前为所有监狱安装空调
美国联邦法官裁定得克萨斯州须在2029年底前为所有监狱安装空调,以应对长期存在的监狱高温安全隐患。本文解析裁决背景、执行挑战及其对囚犯权利保障的深远意义。
Lakebase 分支功能:让 AI 编程代理安全实验的隔离数据库方案
Databricks Lakebase Branching 为 AI 编程代理创建隔离的临时数据库环境,同时捕获 schema 与数据,让代理安全实验而不影响生产。本文解析其分支工作流、CLI 与 AGENTS.md 配置及 CI/CD 集成方式。
Genie One MCP:为AI助手注入受治理的企业业务上下文
Genie One MCP 通过 MCP 协议将 ChatGPT、Claude、Microsoft Copilot 等 AI 助手连接到企业受治理的业务上下文,提供批准的定义、可信数据关系与权限感知访问,助力企业安全落地 AI。