Mac Studio本地实测DeepSeek V4.1 Flash:本地大模型能跑多远
DeepSeek V4.1 Flash本地量化测试:编码能力封顶,速度是最大瓶颈
一位UP主在M3 Ultra 512GB Mac Studio上对DeepSeek V4.1 Flash量化版本进行了24小时极限压测。该模型约550亿参数,引入N-gram查找表与非对称激活设计,在Deep SWE软件工程基准上以74分超越Opus 5.0与GLM 5.3,成为首个达此成绩的MIT许可证开放权重模型。测试涵盖数学推理、UI生成、3D游戏世界搭建等多个维度:关闭思考模式下可快速生成Photoshop/PPT等应用雏形,但复杂3D场景和照片级人脸需依赖思考模式才能完成。本地量化版每秒仅约13 token,UP主通过自定义"思考限制"(限定1000至2万token预算)在速度与质量之间折中。结论是模型能力上限令人振奋,但受速度与内存瓶颈制约,距"即插即用的本地AGI"仍有相当的工程距离。
一场24小时的本地极限压测
DeepSeek V4.1 Flash的出现,让不少开发者重新审视本地部署大模型的可能性。这位UP主在一台M3 Ultra 512GB的Mac Studio上,对量化版本的模型进行了长时间的极限测试,涵盖数学推理、逻辑常识、生产力应用生成到3D游戏世界搭建等多个维度。
值得先说明的是,此次测试运行的是一个偏重质量而非性能的量化实现版本,模型体积略超512GB,因此UP主对约90%的权重进行了重新打包压缩。这也意味着测试结果既展示了模型能力上限,也暴露了本地运行的现实约束——速度慢。
据UP主介绍,DeepSeek V4.1 Flash拥有约550亿参数,采用了新的架构设计。他认为这次更新的幅度实际上更接近4.5甚至5.0,而非简单的小版本迭代。原本1.5TB的V4 Pro版据称已被这个Flash版取代退役。
架构简化与N-gram机制
此次架构调整中最受关注的一点,是团队引入了N-gram机制。UP主形容这本质上是一个查找表(lookup table)——当模型遇到此前处理过的内容时,可以直接调用而非重新生成,从而提升效率。
更有意思的是激活参数的变化:预填充(prefill)阶段仅激活80亿参数,而解码(decode)阶段激活160亿参数。这种在不同阶段动态调整激活参数的做法引发了UP主的好奇——它是否意味着输出的确定性会发生变化?这类问题目前还需要更多实验来验证。
他还提到,旧版本中那套复杂的压缩吸收引擎(compression absorber)此前市面上多数实现都存在错误,而新版本对此进行了简化,只保留了CSA2。在他看来,这种简化反而带来了更好的效果。
N-gram机制在语言模型中有着较长的历史渊源。传统N-gram模型通过统计连续N个词(或token)共现的频率来预测下一个词,是深度学习兴起之前NLP的主流方法。在现代大模型中引入N-gram查找表,本质上是一种"投机解码"(Speculative Decoding)的变体思路——对于已见过的高频短语或固定搭配,模型可以跳过完整的神经网络前向传播,直接从缓存中检索结果,从而将这部分推理开销降至接近零。这种设计在处理代码、模板文本、重复性文档时收益尤为显著,因为这类内容中存在大量可复用的片段。预填充阶段仅激活80亿参数、解码阶段激活160亿参数的非对称设计,也与此思路一脉相承:预填充主要是"理解输入",对参数量需求相对低;解码阶段逐token生成、需要更强的推理能力,因此调用更多参数。这种动态稀疏激活正是MoE(Mixture of Experts,专家混合)架构的核心优势之一。
基准测试:碾压式的开源表现
按照UP主展示的基准数据,DeepSeek V4.1 Flash在多项测试中超越了Opus 5.0和GLM 5.3。在一道三样本(Three-Shot)数学题上,V4基础版从56分提升到高分区间,Opus 5.0拿到74分,GLM得67分,而V4.1 Flash也达到了74分,直接把只有62分的V4 Pro打爆——这正是Pro版被退役的原因。
最引人注目的是它在Deep SWE(软件工程代码测试)上的表现。UP主强调,这是他见过的第一个在Deep SWE上拿到74分的开放权重模型,而且采用MIT许可证。若基准可信,它可能是迄今发布的最佳开源编码模型。
不过他也理性提醒,这些测试都在循环框架中运行且涉及温度(temperature)参数,结果的可信度取决于对照条件是否一致。好在团队用同样的方法也跑了V4旧版,因此至少存在可对比的基线。
Deep SWE(Software Engineering Benchmark)是专门评估大模型在真实软件工程任务中表现的基准测试集,其核心任务来源于GitHub上的真实issue:模型需要在给定代码仓库上下文的情况下,自主定位问题、生成补丁并通过单元测试验证。与单纯的代码补全题不同,SWE-bench要求模型具备跨文件理解、调试推理和工程实践能力,被普遍认为是目前最贴近实际开发场景的编码能力评估方式之一。74分意味着模型能够在约74%的真实软件缺陷修复任务中产出可通过测试的补丁,这一成绩对于可本地部署的开放权重模型而言具有相当的工程价值,也解释了为何UP主将其视为"迄今最佳开源编码模型"的重要依据。MIT许可证则意味着该模型可被自由用于商业产品,无需支付版权费用,这对企业级本地部署尤其重要。
温度参数:AI"随机性"的本质
测试中UP主借机科普了温度的概念。每个token的生成本质上是分词器对候选词的概率预测。在温度为零时,模型会稳定选择概率最高的token;而温度越高,随机数生成器就越可能从海量候选中挑出低概率甚至糟糕的token。
这也解释了在线聊天版与本地版表现差异的部分原因。UP主在测试WinRT订阅相关问题时发现,本地关闭思考模式(thinking off)就能答对"订阅是一种产品Kind而非Type",而在线版却因为设置了温度而打错了字。他半开玩笑地指出,在线服务刻意保留随机性,是为了让用户觉得AI"有人味",而不是一个冷冰冰的数据库。
思考模式的取舍与"思考限制"技巧
V4.1 Flash支持完全关闭思考模式,这一点与不支持关闭思考的GLM 5.3形成对比——后者必须用中高档思考才能答对某些问题。为了在本地缓慢的推理速度下保持可用性,UP主引入了一套"思考限制"(thinking limit)技巧。
模型内置了从关闭到低、高、极高的思考档位,聊天模板本质上是设置一个0到100的预值(75为极高)。UP主的做法是自定义思考限制,比如在"中档最大思考"下只给模型1000个token的思考预算。这样既保留了推理带来的质量提升,又避免了动辄5万token的漫长等待。
他特别提醒了"推理泄露"(reasoning leak)问题——模型可能退出思考标签后仍在标签外继续思考,因此需要精心控制退出时机。在核爆炸生成的对比中,1000 token预算只能做出小喷泉,而提升到1万甚至2万token后,蘑菇云形态明显更完整,他甚至认为效果超过了在线完整最大思考版本。
"推理泄露"(reasoning leak)是当前思维链(Chain-of-Thought)模型在工程部署中的一个常见陷阱。支持思考模式的模型通常通过特殊标签(如<think>...</think>)来划定推理过程与最终输出的边界,但在实际运行中,模型有时会在关闭标签之后仍以隐式推理的方式继续输出中间步骤,导致最终答案混入大量"思考残留",不仅浪费token预算,还可能干扰下游解析。"思考预算"(thinking budget)的概念则来自对推理token数量的硬性限制:通过在提示词或采样参数中约束模型在思考标签内最多生成多少token,可以在推理质量与速度之间找到可控的折中点。这一技术在本地慢速推理场景下尤为实用——相比在线服务可以用数百亿参数的大模型跑完整思维链,本地13 token/秒的速度意味着一次完整的"极高思考"可能需要等待数十分钟,预算限制是让模型在消费级硬件上保持可交互性的关键工程手段。
生产力与3D生成:能力边界在哪
在应用生成环节,模型在关闭思考模式下用4000左右token就分别做出了Photoshop、PowerPoint、Word的雏形界面,UP主对浮动窗口UI的美观度赞不绝口。画布动画、飞行模拟器、摩托车赛车、僵尸FPS等生成也大多完成度不错。
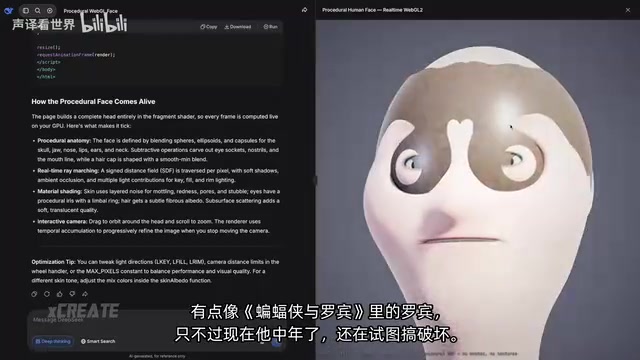
但短板同样明显。3D城市生成缺乏机场、火车站等细节,车辆出现横向移动的bug;GTA风格场景直接崩溃;照片级人脸在关闭思考时只能生成较粗糙的结果,必须叠加最大思考才能得到精致的效果。UP主坦言,面对更复杂的提示词,本地关闭思考模式确实力不从心,真正的能力需要开启思考才能释放。
本地AGI真的来了吗
综合这场测试,DeepSeek V4.1 Flash在本地量化运行下展现了相当强的代码与生成能力,MIT许可证加上顶尖的Deep SWE成绩,让它成为极具吸引力的开源编码模型选择。
但"本地AGI"的说法仍需冷静看待。本地量化版每秒仅约13 token的速度,使得高质量生成必须依赖思考模式,而思考又极其耗时;关闭思考虽然快,却在逻辑推理和复杂3D场景上频繁失手。云端超级计算机146秒能完成的最大思考生成,在本地只能靠"思考限制"这类工程技巧折中实现。
换句话说,模型本身的能力天花板确实令人振奋,但要在消费级硬件上无损发挥,目前仍存在明显的速度与资源瓶颈。对于愿意折腾量化与思考调优的开发者来说,这是一个值得深入研究的强大工具;而离"人人可用的本地AGI",中间还隔着相当一段工程距离。
相关推荐
Cursor 3.0 完整入门指南:从零上手 AI 编程 IDE
Cursor 3.0 完整入门教程:从下载安装、创建项目到并行子代理、云端开发、技能与自动化等高级功能。零基础也能上手这款 AI 编程 IDE,掌握模型选择、设计模式与 Git 版本控制的实用技巧。
Codex+Playwright封装测试Skill:UI自动化不再手敲命令
把 Playwright 封装成 Codex Skill,让 AI Agent 通过自然语言完成 UI 自动化测试。本文详解安装加载、Sauce Demo 实战、PO 分层模板,以及 MCP 与 CLI+Skill 的选型对照。
用Obsidian+AI智能体复刻2999元「得到大脑」全功能
用免费的Obsidian笔记软件搭配AI智能体,如何复刻年费2999元的得到大脑专家版?本文拆解发芽、点评、拷问、风格打磨、审稿、排版等核心功能的skills实现逻辑,助你搭建数据本地化、自由扩展的个人AI知识管理系统。