孟加拉语症状诊断基准存在模板泄漏,数据增强效果被高估

孟加拉语症状诊断基准中91%测试画像与训练仅差一症状,数据增强增益需泄漏控制评估。
该研究系统检验了孟加拉语症状驱动疾病预测基准的模板邻近性缺陷。该基准仅含725个独特患者画像、85种疾病和172个二元症状,许多画像间仅差一两个症状。作者设计2×2实验分离伯努利扰动增强与超参数调优的贡献,采用十次重复真实画像留出和父组分组内部交叉验证,并对比精确复制、随机过采样、类别加权和SMOTEN。结果显示:BNB增强后增益在Holm校正后不显著(平均准确率97.50%);XGBoost、LightGBM和CatBoost分别提升18.10、28.45和10.09个百分点。汉明距离审计发现91.0%的标准留出测试画像与训练数据仅差一个症状位。同疾病1位净化挑战下所有模型精度下降,但XGBoost和LightGBM仍保留大幅增益,表明其收益含真实泛化改善。作者建议基准准确率应与模板邻近性指标联合解读。
一个被忽视的基准缺陷:症状数据集的模板邻近性
在孟加拉语(Bangla)症状驱动的疾病预测研究中,一个仅包含725个独特患者画像、覆盖85种疾病和172个二元症状的小型结构化基准被广泛使用。这个数据集不仅规模有限、类别不平衡,更关键的是,许多画像之间仅仅相差一两个症状——这意味着一部分测试样本与训练样本在特征空间上极为接近。一篇最新预印本论文系统性地检验了这一问题,并提出了一套泄漏控制的数据增强与模板感知评估框架。
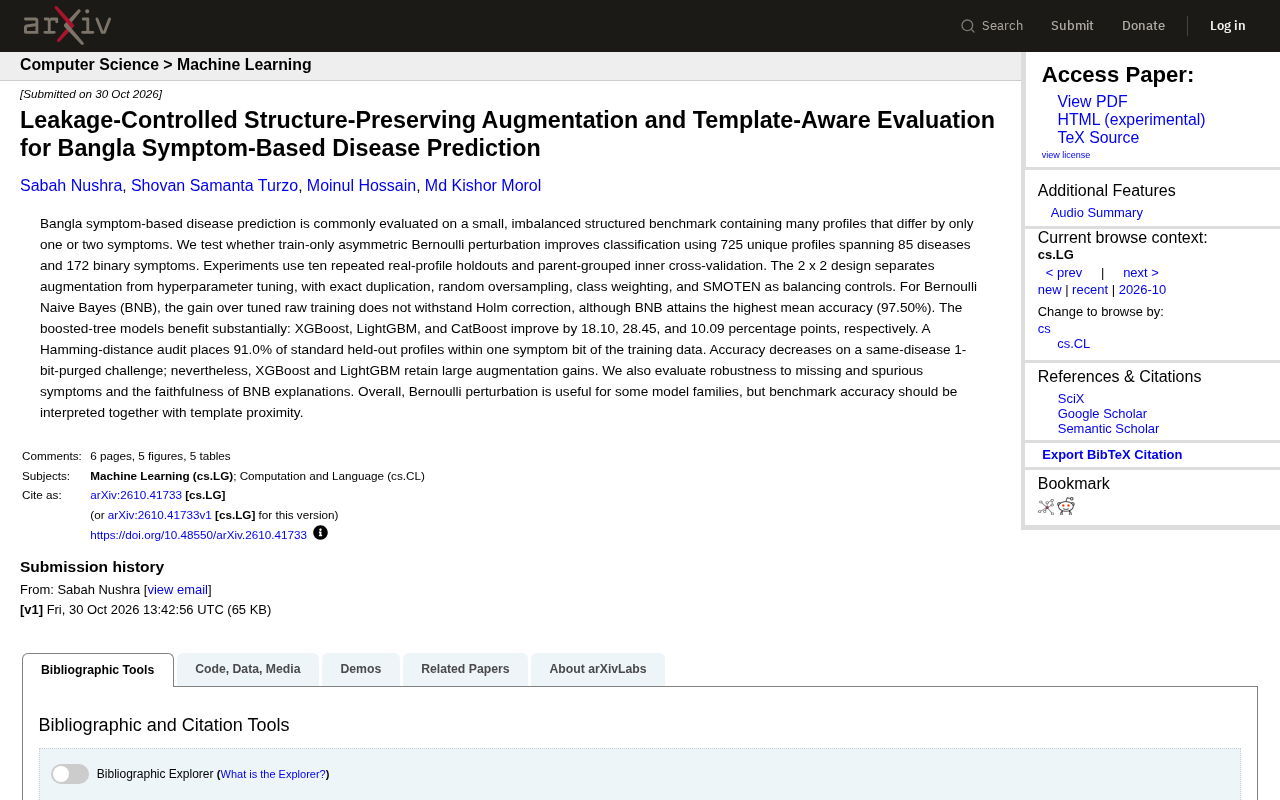
研究的核心问题很直接:当我们用不对称伯努利扰动(asymmetric Bernoulli perturbation)对训练集做数据增强时,模型精度的提升有多少是真实的泛化能力改善,又有多少只是模型记住了与训练模板高度相似的测试样本?
实验设计:分离增强与调参的2×2框架
为了干净地量化数据增强的贡献,作者设计了一个2×2实验矩阵,将“是否做伯努利扰动增强”与“是否进行超参数调优”两个因素完全交叉。这种设计避免了此前研究中常见的混淆——很多工作把增强带来的增益和调参带来的增益混在一起报告。
评估方案采用十次重复的真实画像留出(real-profile holdout)和父组分组内部交叉验证(parent-grouped inner cross-validation)。父组分组的意义在于,同一疾病的不同画像变体不会被同时分到训练集和验证集,从而降低模板泄漏的风险。作为对照,研究还引入了精确复制、随机过采样、类别加权和SMOTEN四种平衡策略,确保伯努利扰动的效果不是简单地等同于“多造了一些样本”。
实验覆盖的模型家族包括伯努利朴素贝叶斯(BNB)和三种梯度提升树模型:XGBoost、LightGBM和CatBoost。
伯努利扰动增强:在二值特征(症状有无)的场景下,伯努利扰动通常指以概率p翻转某个症状位的0/1取值,从而生成原始画像的变体。所谓“不对称”,意味着翻转为1和翻转为0的概率可以不同,以贴合症状稀疏、误报与漏报代价不等的临床特点。这种增强不改变标签,只对特征做结构保持的随机扰动,因此被视为一种正则化手段。
父组分组交叉验证:当同一疾病存在多个画像变体时,若随机划分训练/验证集,同一父组(即同源画像)的变体可能同时出现在两侧,导致验证集被“泄漏”。父组分组确保同一父组的所有变体只能落入同一折,从而模拟模型面对全新患者时的泛化表现。
增强效果因模型而异:树模型大幅受益,BNB增益不稳健
实验结果呈现出明显的模型依赖性。对于伯努利朴素贝叶斯,增强后的精度提升在Holm多重比较校正后不再显著,尽管BNB取得了所有配置中最高的平均准确率——97.50%。这一数字本身颇具迷惑性:BNB在原始训练集上调参后就已经很强,增强并没有带来统计上站得住的额外收益。
梯度提升树模型则是另一番景象。XGBoost、LightGBM和CatBoost分别提升了18.10、28.45和10.09个百分点。LightGBM的增幅最大,接近三成。这说明对于这类需要更多样本来划分决策边界的模型,结构保持的伯努利扰动确实提供了有效的正则化和多样性补充。
但作者并未止步于报告增益。他们进一步用汉明距离审计了标准留出评估的合理性,结果发现91.0%的标准留出画像与训练数据仅相差一个症状位(one symptom bit)。换言之,在常规评估协议下,绝大多数“测试样本”在特征空间上几乎就是训练样本的邻居。这个数字直接动摇了该基准上高准确率的可信度。
模板感知评估:净化1位邻近样本后的真实表现
为了量化模板邻近性对评估的污染程度,研究设计了一个“同疾病1位净化挑战”(same-disease 1-bit-purged challenge):在测试集中移除那些与训练集同疾病样本仅差一个症状位的画像。在这个更严格的评估下,所有模型的准确率都出现了下降——这符合预期,因为净化后的测试集确实更难。
关键在于,XGBoost和LightGBM在这个挑战下仍然保留了大幅度的增强增益。这说明它们从伯努利扰动中获得的收益并非完全来自模板泄漏,而是有真实的决策边界改善成分。相比之下,如果某个模型的增益在净化后完全消失,那就意味着它的“提升”本质上只是更好地拟合了模板邻近的测试样本。
此外,研究还评估了模型对缺失症状和虚假症状的鲁棒性,以及BNB解释的忠实性(faithfulness)。这两项补充实验进一步刻画了不同模型在真实临床场景下的可用性——毕竟在实际诊断中,患者报告的症状往往不完整,甚至包含噪声或误报。
汉明距离:在二元症状向量上,汉明距离定义为两个等长向量中对应位置取值不同的位数。此处“相差一个症状位”即汉明距离为1。汉明距离审计通过计算每个测试画像与训练集中同疾病最近邻的汉明距离,量化测试样本与训练模板的邻近程度。距离越小,说明测试集越容易被“记忆”而非“泛化”所攻克,是评估基准泄漏风险的直接指标。
对基准评测的启示
这项工作的价值不在于否定数据增强,而在于揭示了一个更普遍的方法论问题:在小规模、高模板相似度的结构化医学基准上,标准留出评估给出的精度数字可能系统性偏高。91.0%的测试画像在一症状位内邻近训练数据,这个事实意味着任何在该基准上报告接近满分精度的模型,都需要额外说明其评估协议是否做了模板邻近性控制。
作者的建议是明确的:基准准确率应当与模板邻近性指标一起解读。对于孟加拉语这类低资源语言的症状诊断研究,这一点尤为重要——数据集越小、类别越不平衡,模板泄漏的放大效应就越明显。伯努利扰动对某些模型家族确实有用,但它的增益必须在泄漏控制的评估框架下才能被可靠地度量。
从更广的视角看,这套“泄漏控制+模板感知”的评估思路并不局限于孟加拉语或症状诊断。任何基于结构化患者画像、样本量有限、且画像之间存在细微变体的医学AI基准,都可能面临同样的评估偏差。把汉明距离审计和净化挑战纳入标准评测流程,或许是比追求更高基准精度更有意义的下一步。
相关推荐
AI编程工具成新攻击面:伪造Claude扩展窃取开发者信息
伪造Claude代码扩展现身Cursor市场,11小时内影响多达5000名开发者,窃取主机信息并植入SSH后门。了解攻击手法、自查步骤与AI编程工具的安全防御策略。
ChatGPT 12月起改算Token:聊天与Codex共用额度,谁最受影响?
ChatGPT 12月起改用Token计费,聊天与Codex共用额度。简单问题可用Instant免额度,重度Codex用户影响最大。本文解析新规则、额度查询与Credits购买方式。
ChatGPT与Codex合并额度:谁先用完?
OpenAI将于12月合并ChatGPT与Codex的付费额度,统一按token计量。本文解析合并细节、token计量的模糊性、OpenAI的财务动机,以及用户应对策略。