免费本地部署谷歌Gemma模型:数据零上传的隐私AI方案
用LM Studio在普通电脑免费本地运行谷歌开源Gemma模型,数据全程不出本机。
本文介绍了如何通过LM Studio在普通配置的个人电脑上免费运行谷歌开源的Gemma 3 12B模型,实现完全离线、数据不出本机的本地AI工作流。文章解释了QAT量化技术如何让百亿参数模型压缩至普通电脑可运行的体积,并通过分析机密财务PDF、离线生成完整HTML网页、读图解读血液化验单三个实战案例验证了本地模型的实际能力。本地部署的核心优势是免费、私密、可离线,尤其适合处理敏感数据;主要短板则是生成速度较慢、上下文窗口仅8192 tokens、复杂任务质量不及云端旗舰模型。对大多数日常需求而言,这套方案已足够实用。
在AI工具高度依赖云端的今天,把数据交给多家跨国公司几乎成了默认选项。但一位油管博主给出了另一条路径:在自己的电脑上免费运行谷歌开源的Gemma模型,全程离线,数据永远不出本机。这不仅省钱,更解决了很多人最在意的隐私顾虑。
本文根据该教程整理,梳理出从工具选择、模型下载到实际应用的完整流程,并分析本地大模型的真实能力边界。
为什么选择本地运行AI
本地运行AI模型的核心价值在于两点:完全免费与数据私密。当你处理机密数据、上传私人报告、甚至是健康信息时,所有计算都只在你的电脑上完成,不会发送到美国或欧盟的任何服务器。
代价则是性能受限。你的电脑硬件决定了能跑多大的模型——配置强悍可以运行更聪明的模型,普通电脑则只能胜任日常任务,无法与Gemini、GPT等云端旗舰正面较量。这是一个隐私与算力之间的权衡,而对多数人来说,本地方案已经足够应付大量实际需求。
博主使用的是一台16GB内存、M2 Pro芯片的Mac Mini,属于普通配置而非天价设备,实测运行Gemma毫无压力。
LM Studio:本地模型的运行入口
要运行Gemma这类本地模型,需要一个承载它的应用。目前主流的两个选择是Ollama和LM Studio,教程选择了后者,因为它功能完整且安装简单。
访问 lmstudio.ai 即可下载,支持Mac和Windows。安装后的界面与Gemini、ChatGPT、Claude高度相似:底部是与AI对话的输入栏,侧边栏可查看代码,聊天记录全部存储在本地。
值得留意的是,LM Studio不只能装Gemma,还支持Qwen、DeepSeek、NVIDIA的Nemotron、GLM、Mistral等大量开源模型,可根据电脑算力自由选择。
Ollama与LM Studio代表了本地模型运行的两种主要思路。Ollama更偏向开发者,以命令行为主要交互方式,支持通过API将本地模型接入其他应用(如Open WebUI、Continue等IDE插件),灵活性更高。LM Studio则提供完整的图形界面,内置模型市场、聊天窗口和参数调节面板,对普通用户更友好,同时也支持本地API服务器模式供开发者调用。两者底层都依赖llama.cpp这一开源推理引擎来完成实际计算,对Apple Silicon芯片的Metal加速和NVIDIA的CUDA加速均有良好支持,这也是M系列Mac在本地推理上表现出色的技术原因。
如何挑选并下载合适的模型
在模型页面,信息量很大但并不复杂。教程选择下载 Gemma 3 12B(QAT版本),理由是它目前是普通电脑能跑的最强开源模型之一。
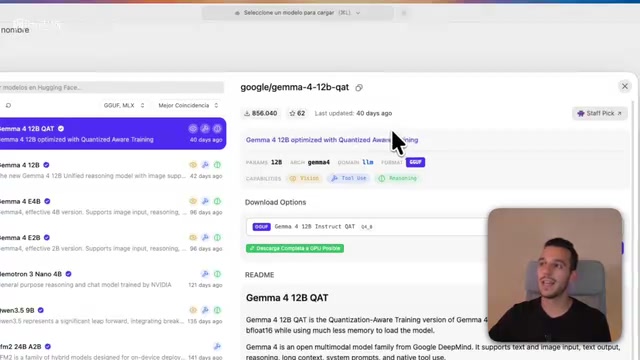
这里几个关键概念值得解释:
QAT量化是什么
QAT指量化。大模型内部由数十亿参数构成,原始版本占用空间极大,需要庞大的硬件才能运行。量化本质上就是把这些参数“四舍五入”,让它们占用更小的空间,从而能在普通电脑上跑起来。这也是本地部署得以普及的核心技术。
量化的核心原理是降低参数的数值精度。原始模型通常以32位或16位浮点数存储每个参数,而量化会将其压缩为8位、4位甚至更低的整数表示,存储空间可缩减至原来的1/4到1/8。QAT(Quantization-Aware Training,量化感知训练)是量化技术中较为先进的一种——它在模型训练阶段就模拟量化带来的精度损失,让模型主动适应低精度环境,因此比训练后再量化(PTQ)的方式损失更小、输出质量更稳定。另一种常见标注是GGUF格式,这是专为本地推理设计的文件格式,与Q4_K_M、Q5_K_S等字母数字组合一起出现时,表示不同的量化等级——数字越大精度越高,文件也越大。理解这些标注,能帮助你在模型页面更准确地根据硬件条件挑选最合适的版本。
参数量与文件大小的关系
模型名称中的数字直接对应文件体积:12B(120亿参数)约为7-10GB,9B约6GB,3B约3GB,20B则大得多。参数越多通常越聪明,但对硬件要求也越高。
看懂那颗绿色按钮
下载前最该关注的是那个绿色的“GPU完整加载可行”提示。它直接告诉你:你的电脑是否足够强,能否流畅运行这个模型。有了这个绿色信号,就可以放心下载。
此外还要注意上下文窗口——Gemma此版本为8192 tokens,意味着不宜进行过长对话,否则会超出容量。
上下文窗口(Context Window)决定了模型在单次对话中能"记住"多少内容,8192 tokens大约相当于6000个英文单词或4000个中文汉字。一旦对话超过这个上限,模型就会开始"遗忘"最早的内容,可能导致前后矛盾或分析遗漏。处理长文档时,建议将文件拆分为多个片段分批提交,或开启新对话避免上下文污染。部分更大参数的模型支持更长的上下文窗口,但对内存的需求也会成倍增加,这是本地部署时需要在能力与硬件之间做出的另一项取舍。
三个实战案例看真实能力
下载完成后,教程用三个逐步进阶的案例展示了Gemma的实际表现。
案例一:分析机密财务报告
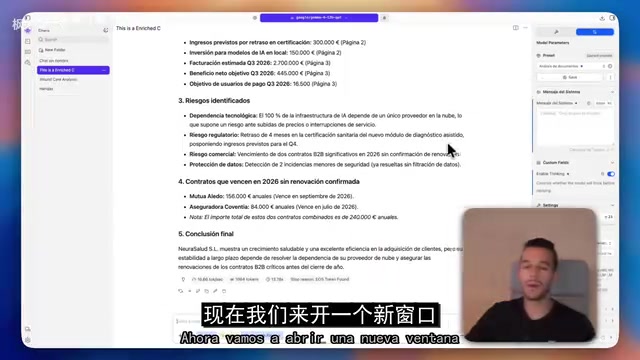
博主上传了一份包含敏感数据的三页PDF(含执行摘要、损益表、关键指标、业务线拆分),要求Gemma以财务分析师身份输出结构化报告:五点关键摘要、重要经济数据、识别的风险、到期合同以及三行结论。
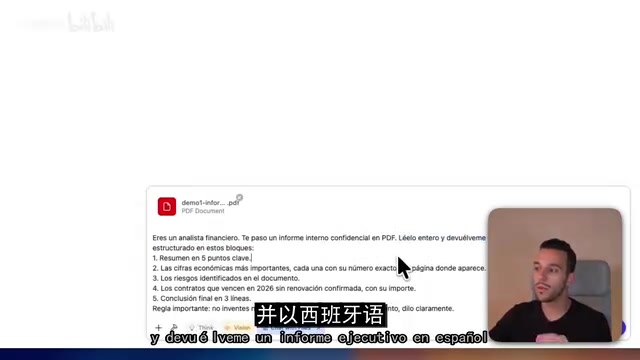
结果耗时约13.78秒,生成1064个tokens,速度为每秒16 tokens。这里暴露了本地模型的第一个局限:token生成速度明显慢于Gemini或ChatGPT。但关键在于——整个分析在本地完成,数据未离开电脑,甚至可以在飞机上无网络时使用。
博主还介绍了右侧面板的进阶功能:系统消息(自定义AI行为)、开启thinking推理(响应更慢但质量更高)、以及temperature温度调节(0偏严谨、1偏创意)。分析文档时建议温度设为0.1-0.2,避免模型编造内容。这些设置还能保存为preset,比如专门建立一个“文档分析”预设,随用随取。
案例二:从零生成完整网页
第二个案例难度升级:让Gemma在单个HTML文件中生成包含首页、菜单、三图画廊、关于我们和联系表单的完整网页,CSS和JavaScript都内嵌其中。
开启推理后能看到Gemma完整的思维链,耗时更长但代码质量更好。生成的HTML可粘贴到HTML Viewer等网站预览。博主坦言:代码不如Gemini、ChatGPT等闭源云端模型精致,但能在完全离线的状态下编程,本身就是了不起的能力。
案例三:读图分析血液化验单
第三个案例考验多模态能力。博主上传的是一张血液化验单图片(而非可选取文本的PDF),要求Gemma用通俗语言解读。
Gemma先明确声明自己不是医生、解读不能替代专业咨询,随后逐项分析并建议将结果交给全科医生。当被要求用更通俗的方式解释时,它打了个精彩比方:把身体比作一座大城市,血液是运输系统,血常规是城市交通,生化指标是补给与废物。
这个案例的价值在于:很多人拿到化验单看不懂,用本地模型拍照解读既私密又免费。博主也提醒,健康数据应尽量匿名化,且AI永远不能替代真正的医疗专业人士。
本地AI的价值与边界
综合来看,本地部署Gemma的适用场景清晰:免费、私密、可离线,特别适合处理机密文档、健康信息等敏感数据,以及无网络环境下的工作。
它的短板同样明确:生成速度较慢、上下文窗口有限、代码与复杂任务的质量不及云端旗舰模型。但对于日常任务而言,一台普通配置的电脑加上一个开源模型,已经能构建出一套不依赖任何厂商、数据绝对可控的AI工作流。这正是开源模型对个人和企业最实在的意义。
相关推荐
Opus 5的道德边界:从拒绝到"恐怖主题项目"的绕行实验
一位开发者用Claude Opus 5开发果蝇隐喻项目时,因措辞被拒后改称"恐怖主题项目"成功绕行。本文剖析大模型内容审核对表层语义的依赖及其对AI安全与人机协作的启示。
语音AI在真实呼叫中心场景下真的靠谱吗?
语音AI真的能应对真实呼叫中心的抢话、改口和噪音吗?本文从技术边界、演示陷阱和人机协同角度,分析Voice AI在真实压力场景下的可靠性与评估方法。
AI安全之争:是为了安全,还是为了控制权?
Anthropic CEO Amodei呼吁全球协调应对AI安全,但这一主张引发争议:AI安全辩论究竟是为了安全,还是为了争夺技术控制权?本文剖析这场辩论背后的权力博弈与治理困境。