语音AI在真实呼叫中心场景下真的靠谱吗?
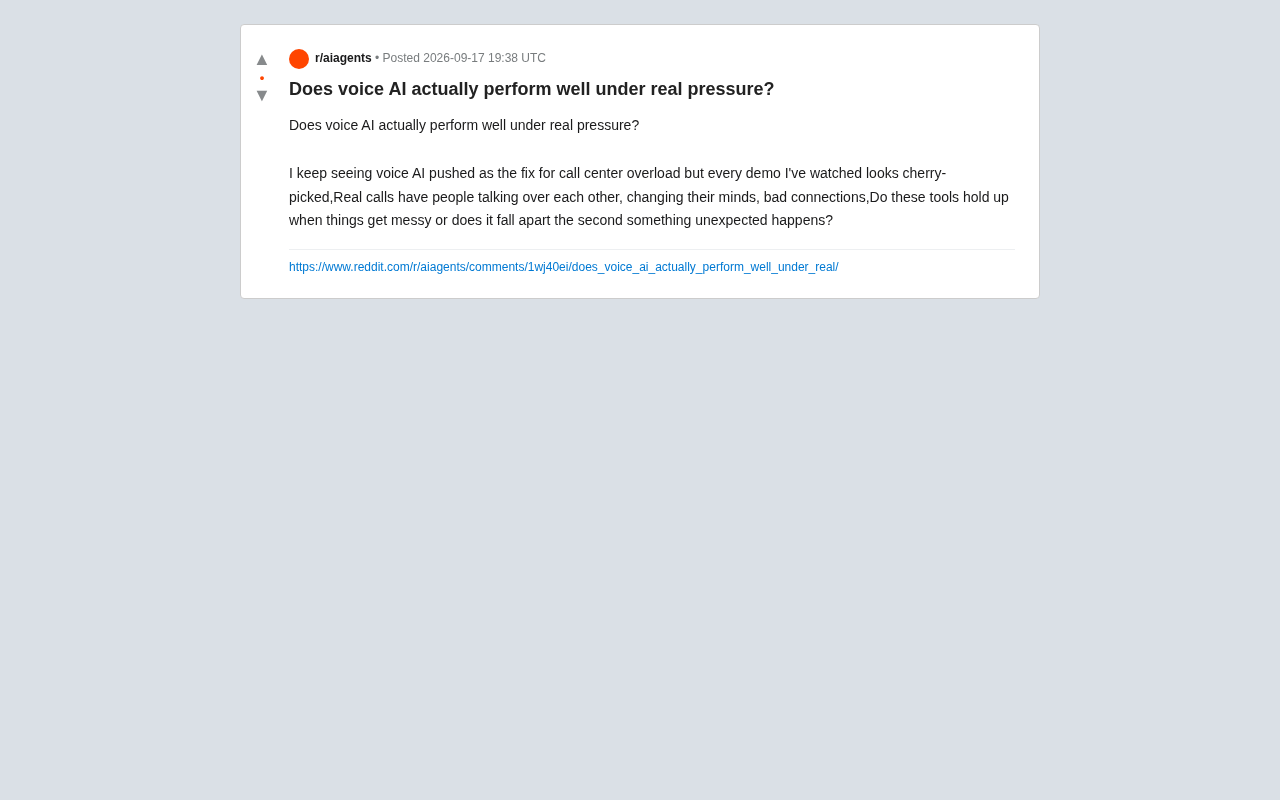
语音AI演示光鲜,但抢话、噪音、延迟等真实场景压力才是检验成熟度的关键。
本文围绕一个Reddit用户的质疑展开:语音AI的产品演示是否经过精心挑选,刻意回避了真实通话中的重叠发言、意图漂移、信道噪音等复杂状况?文章系统梳理了当前语音AI的技术瓶颈——ASR在噪声下词错率骤升、端到端延迟难以压缩、打断处理机制不稳定——并指出该技术在账单查询、预约确认等结构化任务中已具实用价值,但"演示级流畅"与"生产级可靠"之间仍存在明显差距。文章最终建议:评估语音AI应聚焦其出错时的兜底策略与转接能力,并用真实通话录音而非脚本进行压力测试,方能做出可靠的采购判断。
一个被反复追问的问题
语音AI(Voice AI)近年被包装成呼叫中心人力过载的终极解药,几乎每场产品演示都展示出流畅自然的对话效果。但一位Reddit用户提出了值得深思的质疑:这些演示是否经过了精心挑选(cherry-picked)?在真实的电话场景里——人们相互抢话、中途改变主意、信号断断续续——这些工具还能撑得住吗?还是一遇到意料之外的情况就崩溃?
这个问题触及了语音AI落地的核心痛点:演示环境与真实环境之间的巨大鸿沟。
演示与现实之间的差距
产品演示往往在受控环境下进行:清晰的口音、标准的语速、单人依次发言、没有背景噪音。这种设定恰恰规避了真实呼叫中最棘手的几类挑战。
真实通话的复杂性主要体现在几个维度:
- 重叠语音(Overlapping Speech):两个人同时说话时,语音识别系统难以准确分离和转写。
- 意图漂移:客户在通话中途改变需求,要求系统实时更新上下文理解。
- 信道质量差:手机信号弱、环境嘈杂会显著拉低语音转文字(ASR)的准确率。
- 打断与插话:用户随时可能打断AI的回复,考验系统的实时中断处理能力(barge-in)。
这些恰恰是演示视频里几乎不会出现的场景,也是评估语音AI是否真正成熟的关键指标。
Barge-in(插话中断) 是语音AI在真实通话中必须解决的关键交互机制。传统IVR(交互式语音应答)系统依赖固定的静音检测窗口来判断用户是否开始说话,而现代语音AI需要在AI自身发言期间实时监听用户的插话意图,并在毫秒级别内决定是否中断当前输出。这一机制的难点在于区分"真正的打断意图"与"无意义的背景噪声或口头禅(如'嗯''对对对')"——误触发会打断正常播报,漏触发则让用户感到被忽视。部分系统引入声音活动检测(VAD, Voice Activity Detection)与意图置信度双重过滤来降低误判率,但在嘈杂信道下的鲁棒性仍是公开难题。
当前技术的真实能力边界
从技术架构看,现代语音AI通常由三层组成:语音识别(ASR)、自然语言理解与生成(LLM)、语音合成(TTS)。压力测试主要暴露在前两层。
在语音识别环节,重叠说话和噪音环境仍是行业公认的难题。即便顶尖的ASR模型,在多人抢话或强背景噪音下的词错率也会明显上升。理解层虽然因大语言模型的进步而大幅提升了上下文追踪和意图纠偏能力,但面对逻辑跳跃、模糊表达时,仍可能给出偏离用户真实意图的回复。
值得关注的是延迟问题。真实对话对响应速度极为敏感——超过一定时长的停顿会让通话体验显得机械、不自然。要在保证理解质量的同时压缩端到端延迟,是工程实现上的持续挑战。
词错率(WER, Word Error Rate) 是衡量ASR系统准确性的核心指标,指识别结果中错误词数占参考文本总词数的比例。主流商用ASR在安静环境下的WER可低至3%-5%,但在多人重叠发言或强噪声场景中可飙升至30%以上,直接导致下游LLM接收到失真输入,引发理解偏差。端到端延迟则是指从用户说完话到AI开始播放回复之间的时间,通常由ASR转写、LLM推理、TTS合成三段叠加而成。研究表明,人类自然对话的轮换间隔约为200毫秒,而当前语音AI的端到端延迟普遍在800毫秒至2秒之间,这一差距是造成通话体验"机械感"的主要根源。部分厂商通过流式(streaming)处理——即ASR边识别边传给LLM、TTS边生成边播放——将感知延迟压缩至500毫秒以内,但在复杂查询场景下仍难以稳定达标。
它并非全无价值
质疑并不等于否定。语音AI在结构化、可预测的场景中已经展现出实用价值,例如账单查询、预约确认、状态跟踪等边界清晰的任务。这类通话流程相对固定,客户表达也较为标准化,AI的成功率较高。
更务实的部署模式是人机协同:让语音AI处理大量重复、低复杂度的来电,把真正需要判断力、情绪安抚或复杂决策的通话转接给人工坐席。这种分层策略既缓解了人力压力,又避免了AI在高压场景下失控带来的客户体验灾难。
如何评估一款语音AI是否可靠
对于正在考虑引入语音AI的团队,与其相信演示视频,不如设计自己的压力测试:
- 用真实的通话录音(而非脚本)进行回放测试
- 故意制造抢话、改口、噪音等干扰
- 观察系统在无法理解时的兜底策略——是优雅地转人工,还是陷入死循环
- 关注端到端延迟和打断处理的自然度
判断一个系统成熟与否,关键不在于它顺利时有多流畅,而在于它出错时有多得体。 能否识别自身能力边界并及时转接,往往比堆砌功能更能反映产品的工程成熟度。
结语
这位Reddit用户的怀疑是合理且必要的。语音AI确实在快速进步,但"演示级流畅"与"生产级可靠"之间仍有距离。真正值得投入的产品,应当在混乱、不可预测的真实通话中依然保持稳定,并在超出能力范围时懂得体面退场。在做采购决策前,用自己的真实场景压测,是唯一可靠的验证方式。
相关推荐
Bend编程语言:用形式化证明拦截AI错误并跑在GPU上
Bend编程语言:用形式化证明拦截AI错误并跑在GPU上
Bend是一门在Hacker News引发热议的编程语言,通过形式化证明拦截AI生成代码的错误,并原生运行在GPU上实现自动并行。本文解析其核心理念、技术路线与社区疑问。
Bonsai 2 27B:9倍压缩下的近无损模型探索
Bonsai 2 27B 声称在近无损前提下将 27B 大模型压缩至原体积的九分之一。本文解析其压缩技术路径、社区反应与实际部署价值,并给出验证建议。
Uber如何防御重试风暴:分布式系统的容错设计
Uber如何防御重试风暴?本文解析分布式系统中重试流量的放大效应,以及重试预算、断路器、指数退避与抖动等容错设计策略,帮助工程团队构建更稳定的弹性系统。