Uber如何防御重试风暴:分布式系统的容错设计
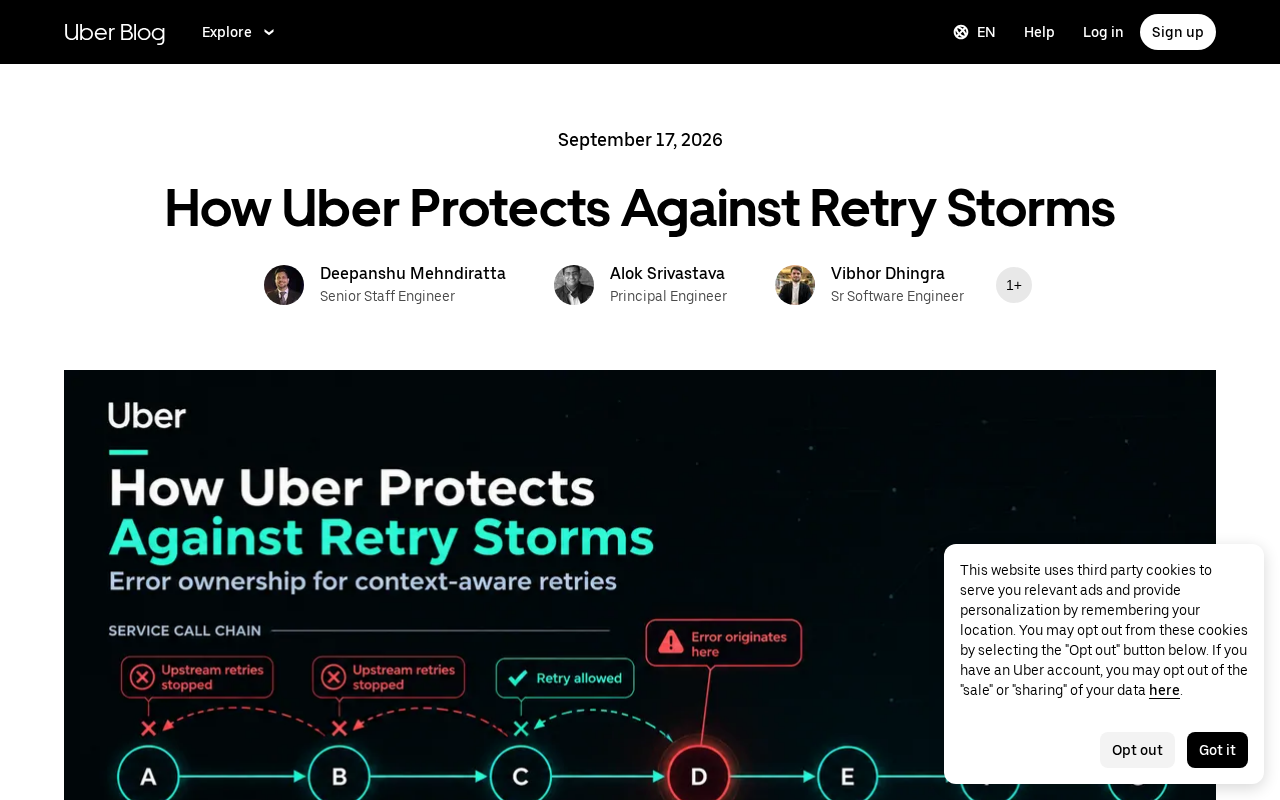
Uber通过重试预算、断路器与指数退避抖动三重机制,防止分布式系统中重试流量的正反馈放大演变为全局故障。
重试风暴是分布式系统中一种危险的连锁反应:下游故障触发上游大量重试,重试流量叠加在本已过载的服务上,使故障进一步恶化,引发更多重试,形成指数级放大的正反馈循环。Uber通过三层防御机制应对这一问题:重试预算将重试流量占总流量的比例限定在可控阈值内,从根源上截断放大效应;断路器在错误率持续超标时自动跳闸,给下游提供恢复空间;指数退避配合随机抖动则将原本聚集在同一时刻的重试请求分散开来,削平流量尖峰。这套组合机制的核心启示是:弹性系统设计不仅要考虑"如何重试",更要考虑"何时停止重试",并通过可观测性手段持续监控重试流量比例,及时发现故障放大的早期信号。
什么是重试风暴
在大规模分布式系统中,重试机制是提升可靠性的常见手段。当一个请求失败时,客户端会自动重发请求,期望在临时故障恢复后获得成功响应。这在多数场景下运作良好,但当系统本身处于过载或部分故障状态时,重试反而可能成为压垮系统的最后一根稻草。
重试风暴(Retry Storm)指的正是这样一种连锁反应:下游服务出现延迟或故障时,上游服务的大量请求超时并触发重试,重试流量叠加在原本已经吃紧的负载之上,导致下游进一步恶化,进而引发更多超时和更多重试,形成一个不断放大的正反馈循环。对于像 Uber 这样每秒处理海量请求的平台而言,这种放大效应足以让局部故障演变成全局性的服务不可用。
重试为何会失控
理解重试风暴的关键在于认识到重试流量的"放大效应"。假设一个服务的每次调用都配置了最多 3 次重试,那么在下游服务开始返回错误时,实际到达下游的请求量可能瞬间放大到正常水平的 3 到 4 倍。当调用链有多层时,这种放大是逐层叠加的——上游重试导致中间层放大,中间层重试再向下游放大,最终底层服务承受的压力呈指数级增长。
更棘手的是同步问题。当大量客户端因为同一个下游故障而同时失败、同时重试时,重试请求会在时间上高度聚集,形成周期性的流量尖峰。这些尖峰即便平均负载不高,也会在短时间内击穿服务的处理能力,让恢复变得更加困难。
Uber 的防御策略
面对这一挑战,Uber 采用了多层次的防御手段,核心思路是在保留重试带来的可靠性收益的同时,抑制其放大效应。
重试预算与限流
最直接的手段是为重试设置"预算"(retry budget)。系统不再允许无限制地重试,而是限定重试流量占总流量的比例,例如只允许 10% 的额外重试请求。一旦重试量超出这个阈值,后续的失败请求将不再触发重试而是直接返回错误。这样即便下游发生大面积故障,重试带来的额外负载也被限制在一个可控范围内,避免了指数级放大。
断路器机制
断路器(Circuit Breaker)是另一道关键防线。当某个下游服务的错误率持续超过设定阈值时,断路器会"跳闸",在一段时间内直接拒绝对该服务的调用,而不是让请求继续堆积。这给了下游服务喘息和恢复的时间,也避免了上游浪费资源在注定失败的请求上。断路器通常配合半开状态使用,定期放行少量探测请求来判断下游是否已恢复。
断路器模式源自电气工程中的保险丝概念,由 Michael Nygard 在《Release It!》一书中系统引入软件领域。它通常维护三种状态:关闭(Closed)——请求正常通过,同时统计失败率;打开(Open)——错误率超过阈值后跳闸,所有请求立即失败,不再尝试访问下游;半开(Half-Open)——经过冷却期后,放行有限数量的探测请求,若探测成功则恢复关闭状态,若探测失败则重新打开。这一状态机设计的精妙之处在于它能自适应地感知下游健康状况,既不会在下游已恢复时继续拦截请求,也不会在下游仍脆弱时贸然放入全量流量。在实现上,断路器的阈值设置需要结合业务容忍度和服务 SLA 仔细校准——阈值过低会导致误跳闸,阈值过高则起不到保护作用。
指数退避与抖动
为了解决重试同步导致的流量尖峰,指数退避(Exponential Backoff)配合随机抖动(Jitter)成为标配。指数退避让每次重试之间的等待时间逐渐拉长,避免短时间内连续冲击下游;随机抖动则在退避时间上叠加随机偏移,把原本聚集在同一时刻的重试请求分散到一个时间窗口内,从而削平流量尖峰。
关于抖动策略,AWS 工程博客曾系统比较了几种常见实现:纯指数退避(无抖动)、全抖动(等待时间完全随机化在 0 到上限之间)、等差抖动(固定步长加随机偏移)以及"去相关抖动"(每次等待时间基于上次实际等待时间随机化)。实验结果显示,**全抖动(Full Jitter)**在吞吐量和服务端压力之间取得了最优平衡——它牺牲了单个客户端的重试延迟,但大幅降低了客户端群体在时间上的同步性,从而最有效地削平了流量尖峰。这个结论对工程实践的意义在于:直觉上"退避更多"并不等于"更安全",抖动的随机化程度才是分散同步重试的关键变量。
对工程实践的启示
Uber 的做法揭示了一个重要原则:重试本身是一把双刃剑。在设计弹性系统时,不能只考虑"如何在失败后重试",更要考虑"何时应该停止重试"。盲目的重试策略在小规模系统里或许无害,但在高并发、多层调用的架构中,它可能成为放大故障的元凶。
对于正在构建分布式系统的团队,可以借鉴的实践包括:为重试引入预算限制而非固定次数;在客户端和服务端同时部署断路器;所有重试逻辑都应带上退避和抖动;以及建立可观测性,实时监控重试流量占比,及时发现异常放大。这些机制组合使用,才能在保证可靠性的同时守住系统的稳定边界。
(注:本文基于 Hacker News 分享的标题与主题整理,原始讨论信息有限,具体技术细节以 Uber 官方工程博客为准。)
相关推荐
从Function Calling到MCP:读懂大模型工具调用底层原理
从Function Calling五步流程入手,用天气查询实战拆解大模型工具调用的底层原理,理清它与智能体的区别,以及它作为MCP协议基础的关键地位,为学习MCP和A2A打好地基。
智能体系统的授权该发生在哪一层?执行边界的安全思考
智能体系统中授权检查应该发生在哪一层?本文探讨执行边界的独立验证问题,分析上游策略检查的局限、状态漂移与重放攻击风险,以及纵深防御在AI agent安全架构中的实践思路。
三值权重压缩:27B模型缩至6GB,可在浏览器本地运行
Ternary Bonsai 2(27B)在Hugging Face发布,采用三值权重将模型压缩至6GB以下,仅为FP16的九分之一,官方称保留98.2%性能,并支持通过WebGPU在浏览器本地运行。