#分布式系统
共 9 篇相关文章

差点搞垮Azure的存储Bug:安全部署策略的由来
微软Azure团队回顾一次因存储性能优化引发无限循环与重试雪崩、险些拖垮全球服务的故障,并由此诞生了金丝雀发布式的安全部署策略(SDP),为分布式系统工程实践提供了宝贵教训。

百万级AI Agent的真正瓶颈是分布式系统
当AI Agent数量突破百万量级,真正的挑战不再是模型智能,而是状态一致性、调度、故障处理等分布式系统难题。本文解析大规模Agent系统的工程本质及对开发者的启示。
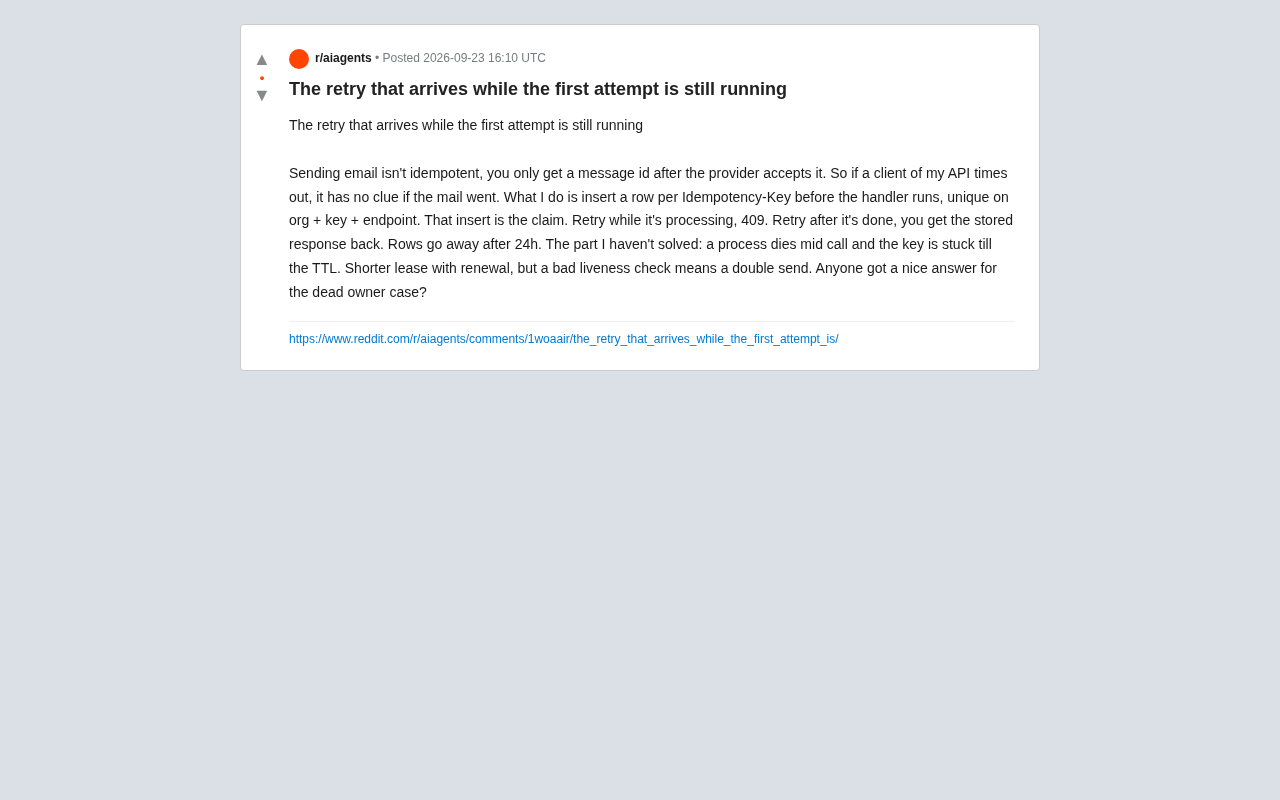
幂等键难题:如何处理API重试中的“僵尸进程”
发送邮件不是幂等操作,API 重试时如何避免重复发送?本文剖析基于幂等键的抢占声明机制,以及进程崩溃导致“死亡持有者”这一分布式系统经典难题的权衡与解决思路。

Delta:基于链式复制的高可用强一致存储系统解析
Delta 是采用链式复制(Chain Replication)架构的高可用强一致分布式存储系统。本文解析链式复制的读写原理、故障恢复机制及其在强一致与高可用之间的工程取舍,帮助理解这类存储系统的设计思路与适用场景。

时间触发通信系统中的"喋喋不休"故障及其防护
深入解析时间触发通信系统中的"喋喋不休"(babbling idiot)故障模式,探讨总线守卫、集中式与分布式守卫架构如何实现故障隔离,保障航空、汽车等安全关键系统的通信可靠性。
CSE 452:Google视角下的分布式系统设计入门课
CSE 452 是一份以 Google 工程实践为背景的分布式系统设计入门课程。本文梳理其定位与价值,并给出分布式系统的学习路径建议,适合后端与系统架构学习者参考。
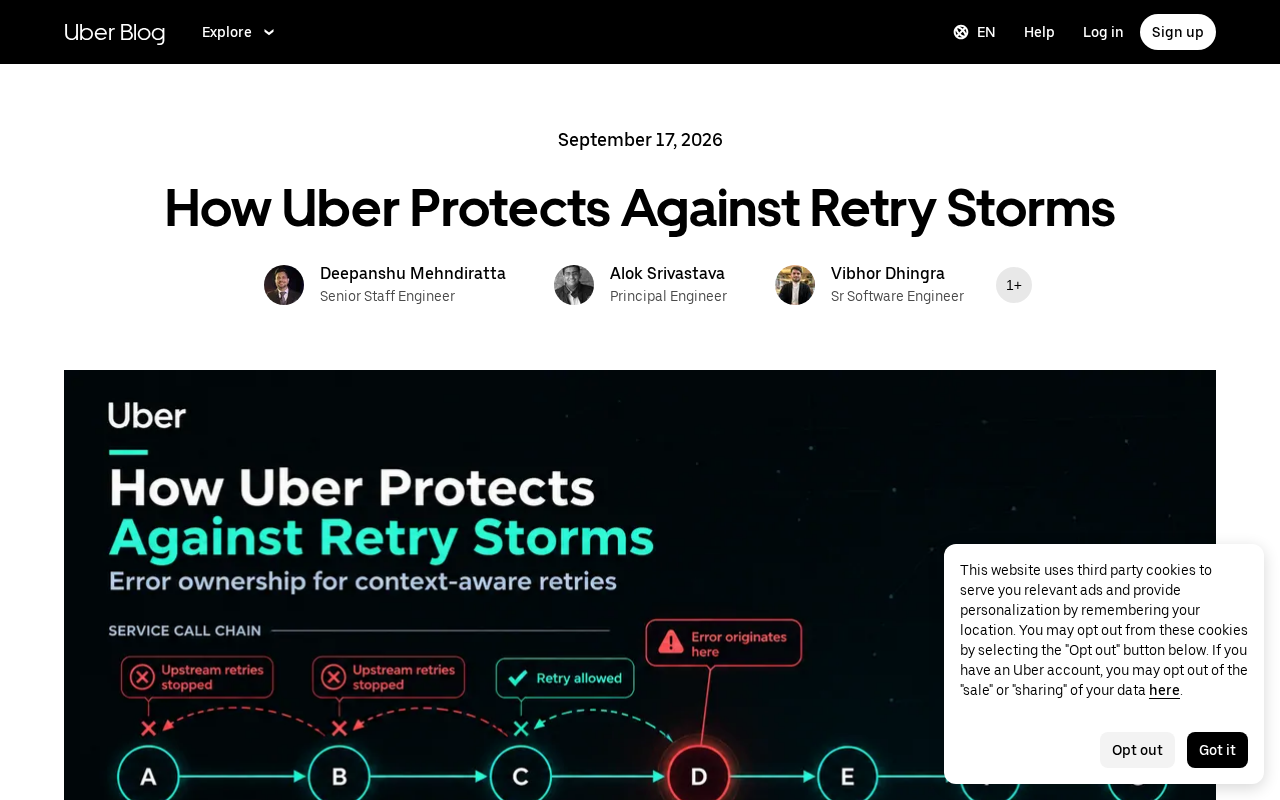
Uber如何防御重试风暴:分布式系统的容错设计
Uber如何防御重试风暴?本文解析分布式系统中重试流量的放大效应,以及重试预算、断路器、指数退避与抖动等容错设计策略,帮助工程团队构建更稳定的弹性系统。
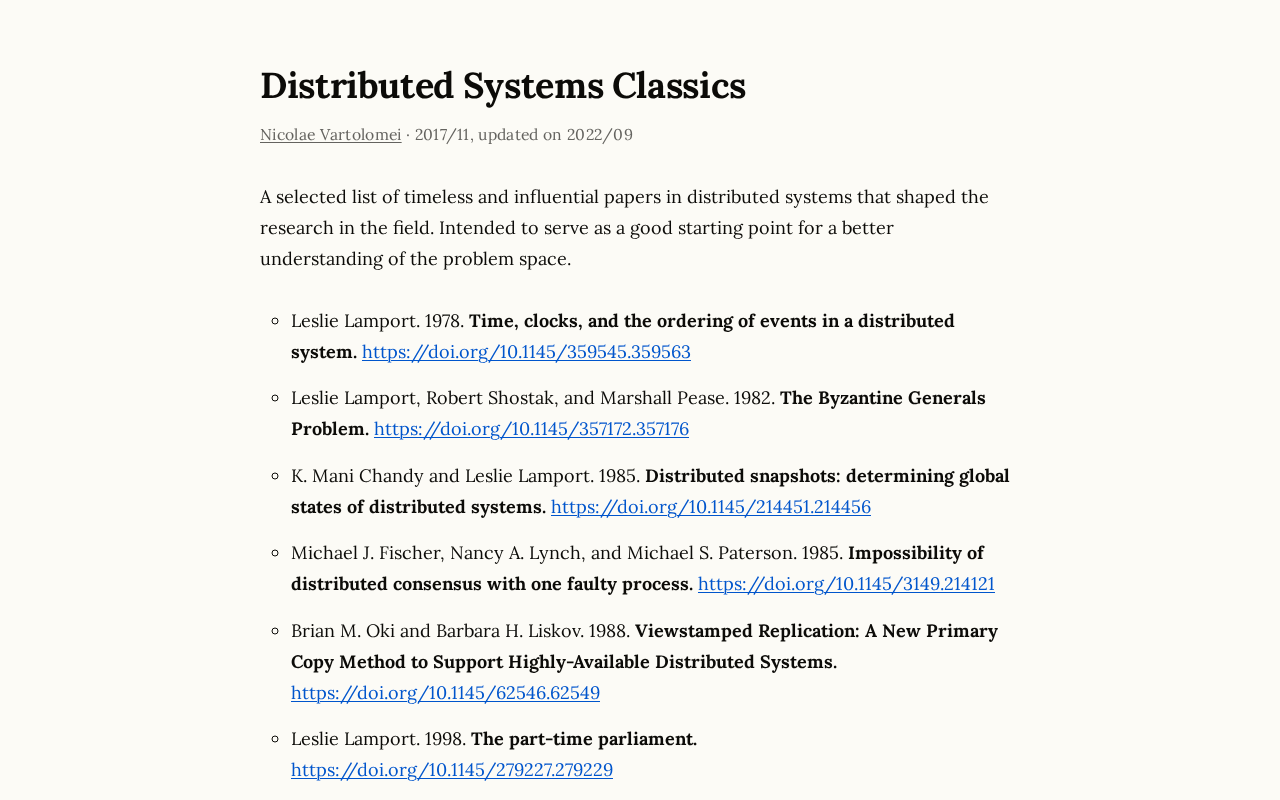
分布式系统经典论文导读:从入门到精通的必读清单
一份在 Hacker News 走红的分布式系统经典论文清单,涵盖共识算法、逻辑时钟、CAP 定理等核心主题,为工程师提供系统化的学习路径与理论到实践的桥梁。

AI Agent 崩溃后如何避免重复退款?CellaFlow 的持久化执行方案
AI Agent 崩溃后如何避免重复退款、又不让工作流死锁?CellaFlow 通过持久化执行、共享工作标识、租约与栅栏机制,解决多智能体系统中不可逆副作用的安全性与活性难题,附开源崩溃基准测试对比。