免Schema的企业数据合成:STS仿真范式解析

SAP提出STS范式,让LLM智能体在仿真环境中通过策略API生成数据,无需访问Schema即可保证合法性与分布保真度。
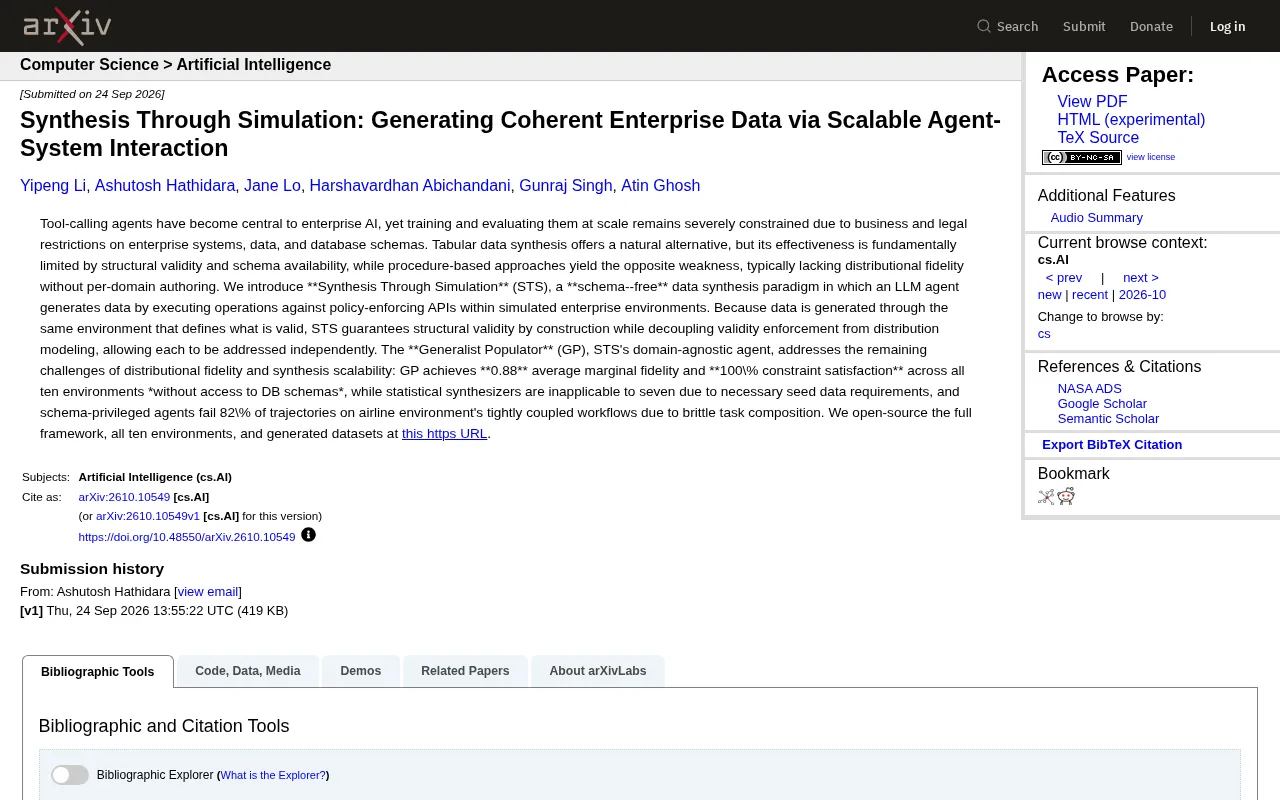
企业AI在训练和评估工具调用智能体时,面临真实数据因商业合规限制难以获取的困境。SAP团队提出的「通过仿真进行合成(STS)」范式,通过让LLM智能体在仿真的企业环境中与策略执行API交互来生成数据,从构造上保证结构合法性,同时将合法性强制执行与分布建模解耦。核心组件Generalist Populator(GP)在十个企业仿真环境中实现了0.88的平均边际保真度和100%的约束满足率,且全程无需访问数据库Schema。对比实验还揭示了一个反直觉结论:拥有Schema特权的智能体在紧耦合的航空业工作流中有82%的轨迹失败,信息更多并不等于表现更好。SAP已将完整框架和数据集开源。
企业AI的数据困境
工具调用型智能体(tool-calling agents)已经成为企业AI的核心组件,但在规模化训练和评估这类智能体时,始终存在一个绕不开的难题:企业系统、数据以及数据库结构往往受到商业机密和法律合规的严格限制。换句话说,你很难拿到真实的企业数据来训练模型,也很难在真实环境中大规模评估智能体的表现。
这篇来自 SAP 团队的 arXiv 论文(arXiv:2610.10549v1)正是针对这一痛点,提出了一种名为 Synthesis Through Simulation(STS,通过仿真进行合成) 的全新数据合成范式。它试图回答一个关键问题:在无法接触真实数据库结构的前提下,如何生成既结构合法、又具备分布保真度的企业级数据?
现有方法的两难
要理解 STS 的价值,先要看清当前主流方案的局限。文章指出,解决数据缺失问题通常有两条路径,但它们各有硬伤。
表格数据合成:受限于结构合法性
第一条路径是表格数据合成(tabular data synthesis)。这类统计式合成器能够模拟真实数据的分布特征,但其效果从根本上受制于两点:一是结构合法性(structural validity),二是数据库结构的可获得性(schema availability)。更麻烦的是,许多统计合成器需要种子数据(seed data)作为输入——而这恰恰是企业场景中最难拿到的东西。论文提到,在其测试的十个环境中,有七个因为种子数据的硬性要求而无法应用统计合成器。
表格数据合成(tabular data synthesis)是数据增强领域的经典方向,常见技术路线包括基于变分自编码器(VAE)的 TVAE、基于生成对抗网络的 CTGAN,以及近年兴起的基于扩散模型的方法。这些方法的共同前提是:必须先拿到一批真实数据(种子数据)来学习其统计分布,然后再采样生成新数据。在公开数据集(如医疗、金融学术数据集)场景下,这套流程运转良好。但企业数据库往往涉及多表关联、外键约束和跨字段业务规则,合成器即便学会了单列的边际分布,也极难还原这些复杂约束——生成的数据很可能在逻辑上自相矛盾,无法被真实业务系统接受。
基于流程的方法:缺乏分布保真度
第二条路径是基于流程(procedure-based)的方法。这类方法通过预先编写的规则生成数据,能够保证合法性,但其弱点恰好相反:缺乏分布保真度(distributional fidelity),且通常需要为每个领域单独编写规则(per-domain authoring),扩展性极差。
两条路径一个保分布但失合法,一个保合法但失分布,形成了鲜明的两难局面。
STS 的核心思路:让环境定义合法性
STS 的突破点在于「免 Schema(schema-free)」这一设计理念。它不再依赖对数据库结构的直接访问,而是让一个 LLM 智能体在仿真的企业环境中,通过调用「强制执行策略的 API」(policy-enforcing APIs)来执行操作,从而生成数据。
这个设计有一个巧妙之处:由于数据是通过「定义何为合法的同一个环境」生成的,STS 从构造上(by construction)就保证了结构合法性。更重要的是,它将「合法性强制执行」与「分布建模」这两件事解耦(decoupling),使得两者可以被独立处理——这正好对症下药地解决了前面提到的两难。
换个角度理解:传统方法要么先定规则再填数据,要么先学分布再修合法性,而 STS 让智能体像真实用户一样在系统中「操作」,系统本身的 API 和策略会自动拦截一切非法操作,合法性因此天然成立。
Generalist Populator:领域无关的填充智能体
在保证合法性之后,剩下的两个挑战是分布保真度和合成的可扩展性。为此,STS 引入了 Generalist Populator(GP,通用填充器)——一个领域无关(domain-agnostic)的智能体。
论文给出的实验数据相当亮眼:
- GP 在全部十个环境中达到了 0.88 的平均边际保真度(average marginal fidelity);
- 实现了 100% 的约束满足率(constraint satisfaction);
- 关键是,这一切都在没有访问数据库 Schema 的前提下完成。
作为对比,统计式合成器因种子数据要求而无法应用于其中七个环境;而即便是拥有 Schema 特权的智能体(schema-privileged agents),在航空业环境那种紧耦合(tightly coupled)工作流中,仍有高达 82% 的轨迹(trajectories)失败,原因是任务组合的脆弱性(brittle task composition)。
这组对比说明了一个反直觉的结论:拥有更多信息(Schema 访问权)的智能体,并不一定表现更好。在复杂的、流程紧耦合的业务场景里,直接操作 Schema 反而容易因任务编排失误而崩溃,而通过仿真环境与 API 交互的方式则显得更稳健。
「边际保真度」(marginal fidelity)是衡量合成数据质量的常用指标,通常指合成数据在每个字段上的单变量统计分布(如均值、方差、类别频率)与真实数据的接近程度,常用 Wasserstein 距离或 KL 散度来量化。0.88 的平均边际保真度意味着合成数据在大多数字段的分布上与参考真实数据相当接近,但该指标无法捕捉多变量之间的联合分布偏差——这也是为什么论文同时强调「约束满足率」这一补充指标,二者共同构成对合成数据质量的完整描述。此外,「轨迹」(trajectory)在工具调用智能体的评估语境中,指智能体完成一项任务所执行的完整动作序列,包括 API 调用、参数选择和中间状态,是评估智能体规划能力的基本单位。
开源价值与行业意义
值得关注的是,SAP 团队将整个框架、全部十个仿真环境以及生成的数据集全部开源,代码托管于 GitHub(https://github.com/SAP/synthesis-through-simulation)。对于企业AI从业者而言,这意味着可以直接在这些仿真环境中训练和评估工具调用智能体,而无需触碰敏感的真实企业数据。
从更宏观的视角看,STS 代表了一种数据合成思路的转变:从「静态地模仿数据」转向「动态地生成数据」。当数据通过智能体与系统的真实交互产生时,它不仅合法,还天然携带了业务逻辑和操作上下文。这对于训练下一代企业级 Agent 具有实际意义,尤其是在金融、航空、供应链等对数据合规性要求极高的领域。
当然,论文也隐含了一些待验证的边界:仿真环境本身的构建成本、GP 在更极端分布下的表现、以及该范式能否推广到十个环境之外的更广泛场景,仍需后续研究和社区实践来检验。但作为一个方法论创新,STS 为「如何在合规约束下规模化合成企业数据」提供了一条颇具启发性的新路径。
相关推荐

一条推文引发的思考:AI能否成为危机决策助手
一条调侃官员向AI咨询如何应对假想疫情的推文引发讨论。本文探讨生成式AI在高风险公共决策中的能力边界、幻觉风险与负责任使用原则。

一条推文背后的AI叙事:当算法学会讲述"寻找爱情"的故事
一条关于"缪斯寻找爱情"的推文背后,是AI叙事内容兴起的缩影。本文从截图碎片还原这个民谣式故事,并分析叙事型AI、多模态创作与情感表达的趋势。

Perplexity开源pplx-embed-v2-late:跨模态后交互嵌入模型
Perplexity开源发布pplx-embed-v2-late,两款后交互(late-interaction)嵌入模型,支持文本、图像与页面的跨模态检索,共享统一嵌入空间,现已在Hugging Face公开可用。