#LLM Agent
共 7 篇相关文章

·5 分钟
TrawMem:把智能体记忆重构为任务导向的角色自适应工作区
TrawMem 提出任务导向的角色自适应工作区框架,将智能体记忆从按相关性检索重构为按任务角色与关系组织。在 LoCoMo 与 MemGallery 上 macro-F1 提升 2.23-3.14 点,同时减少上下文 token 消耗。
阅读全文 →

·6 分钟
为LLM Agent构建搜索抓取层:缓存、正文提取与成本控制
详解如何为LLM Agent构建搜索抓取层:通过网关模式统一处理缓存、预算控制与robots.txt合规,用trafilatura提取正文将180KB HTML压缩至6KB,实测缓存命中率35%-45%,显著降低Agent抓取成本。
阅读全文 →
·5 分钟
LLM Agent任务分解:构建可靠工作流的核心工程模式
结构化任务分解是构建可靠LLM Agent工作流的关键工程模式。本文详解如何通过LLM驱动的提示词设计将复杂目标拆解为原子子任务,涵盖减少幻觉、提升可调试性、成本优化与并行化等核心收益,并指出过度分解的边界。
阅读全文 →
·7 分钟
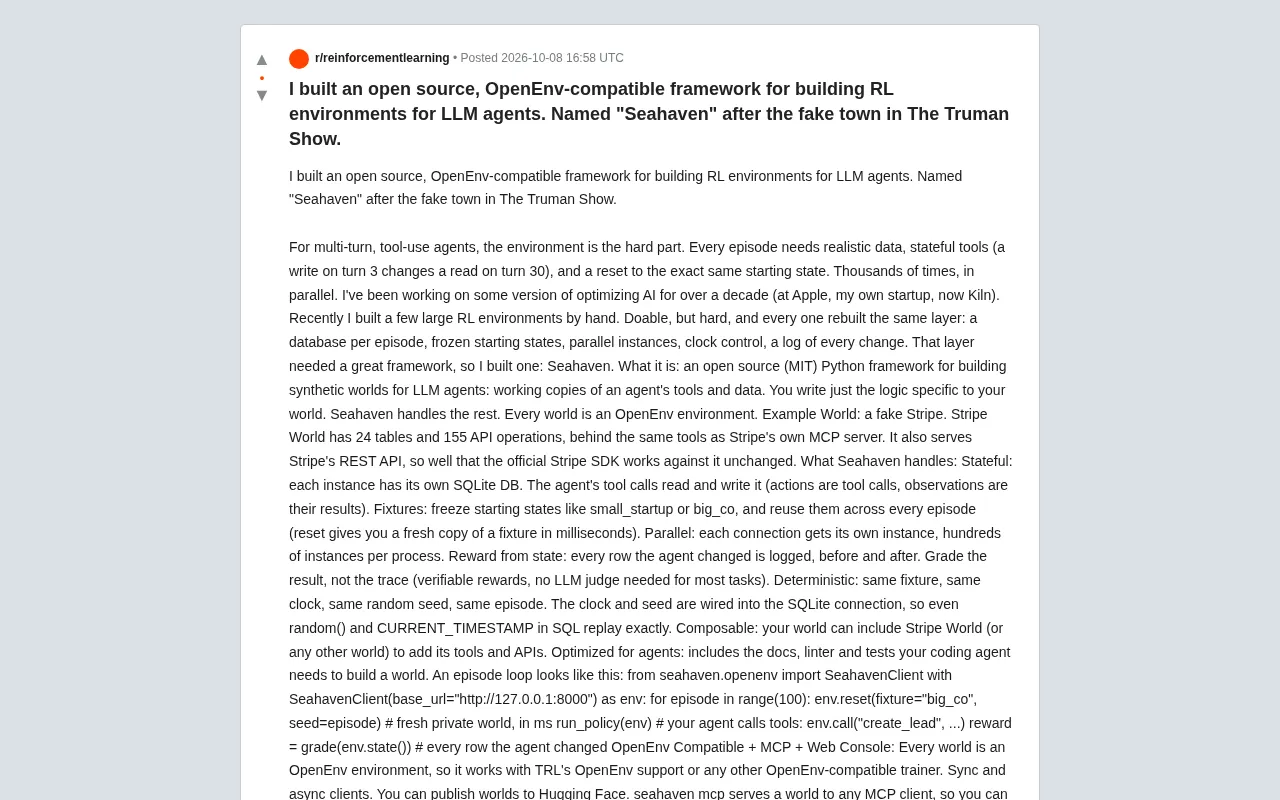
Seahaven:为 LLM 智能体打造 RL 训练环境的开源框架
Seahaven 是一个 MIT 开源、兼容 OpenEnv 的 Python 框架,用于为 LLM 智能体构建可复现的 RL 训练环境。支持带状态工具、毫秒级 reset、确定性回放与基于状态的可验证奖励,并提供高保真的 Stripe World 示例。
阅读全文 →

·5 分钟
TwinCheck:用「负孪生」反事实验证修复工具智能体的错误调用
arXiv 新论文提出 TwinCheck——一种推理阶段的证据驱动「负孪生」验证策略,通过反事实对照修复工具智能体的错误调用,在 BFCL V4 多轮任务上将成功率从 45.3% 提升至 58.5%,且无成功转失败回退。
阅读全文 →

·5 分钟
Glyph:用多策略Agent系统自动标注企业数据目录
Glyph 是一套面向企业数据目录的多策略 Agent 系统,用协作 LLM 智能体自动完成列描述生成与敏感度本体标注,通过锚定流水线源代码提升准确性,助力数据发现、访问控制与合规治理。
阅读全文 →
