TrawMem:把智能体记忆重构为任务导向的角色自适应工作区

TrawMem 按任务角色而非相关性组织智能体记忆,效果提升且省 token。
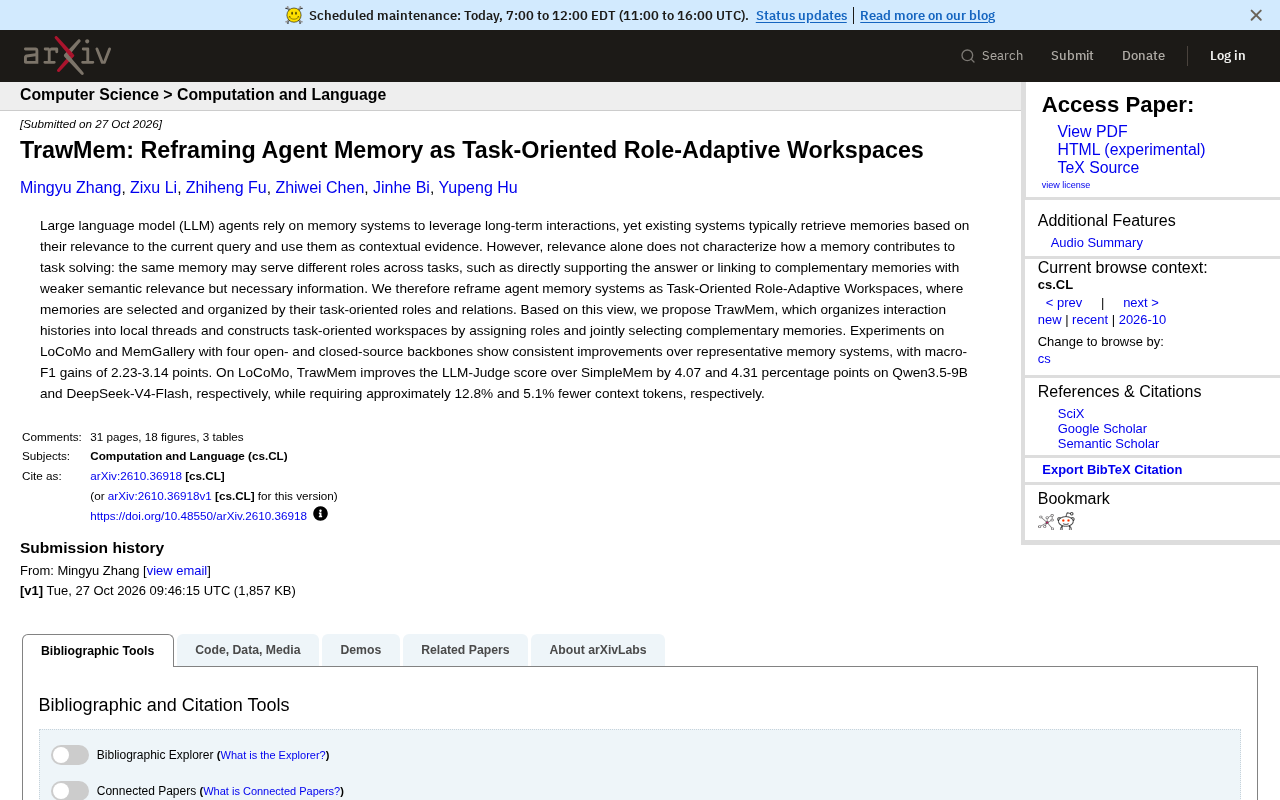
文章介绍 TrawMem 这一智能体记忆新框架。作者指出,主流记忆系统按查询语义相关性检索片段,但相关不等于有用——某些弱相关记忆是通往关键互补信息的线索,会被相关性排序系统性过滤。TrawMem 将记忆重构为"任务导向的角色自适应工作区",选取单位从单条片段变为角色组合,组织方式从平铺列表变为结构化工作区。实现上先把交互历史切分为局部线程以降低噪声,再通过角色分配与互补记忆联合选择构建工作区。在 LoCoMo 与 MemGallery 两基准、四个骨干模型上,macro-F1 提升 2.23 至 3.14 点,LoCoMo 上 LLM-Judge 得分提升约 4 个百分点,同时上下文 token 反降 5% 至 13%。文章认为这提示记忆的"角色"应成为一等设计维度。
记忆检索的旧范式:相关性并不等于有用性
当前主流LLM智能体的记忆系统,基本遵循同一套逻辑:当用户提出新查询时,系统从长期交互历史中检索与当前查询语义最相关的记忆片段,把它们拼接进上下文作为证据。这套做法直观、易实现,也被大量产品沿用。
问题在于,相关性和任务贡献之间并不能画等号。同一段记忆在不同任务中可能扮演完全不同的角色——它可能直接支撑答案,也可能只是通往某条互补记忆的线索,而后者在语义上与查询的相关性往往更弱,却携带着完成任务所必需的信息。如果检索器只按相关性排序,这类"弱相关但关键"的记忆就会被系统性过滤掉。
TrawMem正是从这个观察出发,对智能体记忆的底层抽象做了一次重新定义。
语义相关性检索通常指用查询与记忆片段的向量表示(如通过双塔编码器得到的稠密向量)计算余弦相似度并排序,或结合 BM25 等稀疏检索做混合打分。RAG(Retrieval-Augmented Generation)的典型流程即由这一打分机制驱动:取 top-k 片段拼入上下文。它的隐含假设是"与查询越像的文本越有用",这一假设在事实问答中大体成立,但在需要多步推理、线索串联或互补证据的任务中会失效——关键记忆可能字面 dissimilar,却承载着推理链条上不可或缺的一环。理解这一点,才能明白为何仅靠相似度排序会系统性漏掉"弱相关但关键"的记忆。
Task-Oriented Role-Adaptive Workspaces:一次抽象层的重构
研究团队提出的新框架名为"任务导向的角色自适应工作区"(Task-Oriented Role-Adaptive Workspaces)。核心主张是:记忆不应只按与查询的相关性被检索,而应按其在任务中的角色和关系被选择与组织。
这个视角转换带来两个直接后果。其一,记忆的选取单位从"单条片段"变成"角色组合"——系统需要判断某条记忆在当前任务中是直接证据、补充背景,还是指向其他记忆的桥梁。其二,记忆的组织方式从"平铺的上下文列表"变成"有结构的工作区",不同角色的记忆被放置在各自的位置上,共同服务于同一个任务目标。
换句话说,记忆系统要回答的问题从"哪些记忆和查询最像"变成了"哪些记忆组合起来最能解决这个任务"。
LLM 智能体的记忆系统一般分为短期(上下文窗口内的对话历史)与长期(外部存储、可跨会话检索)两层,长期记忆又常按情节记忆(episodic,具体交互事件)、语义记忆(semantic,抽取出的事实)等类型划分。多数系统的长期层以向量库为核心,检索时做相似度召回。TrawMem 所挑战的正是"长期记忆=向量检索库"这一默认抽象:它主张记忆的存储与索引之外,还需一层"选择与组织"的逻辑,决定哪些记忆以何种结构进入上下文。这一层此前常被简化为重排序,而工作区视角把它提升为与检索并列的独立设计维度。
TrawMem 的工作机制:局部线程 + 联合选择
基于上述框架,TrawMem 在实现上做了两件事。
第一,把交互历史组织成局部线程(local threads)。 长期交互历史往往是碎片化、跨话题的,直接在上面做检索噪声很大。局部线程的做法是先按交互的连续性把历史切分成有内聚性的片段,让后续的角色判断和选择在更干净的单元上进行。
第二,构建任务导向工作区。 系统为记忆分配角色,并在此基础上做互补记忆的联合选择——不是逐条独立打分,而是考虑记忆之间的关系,把"直接支撑"和"互补补充"的记忆一起挑出来。这也是它能捞回那些语义相关性弱但信息必要的记忆的原因。
从方法定位上看,TrawMem 属于对记忆系统的结构性改造,而非在检索器上加一个重排序模块。它改变的是记忆被选择和组织的粒度与依据。
**联合选择(joint selection)**与逐条独立打分的区别在于建模记忆间的依赖关系:若记忆 B 只有在记忆 A 被选中的前提下才有用,独立打分会让 B 因自身相关性低而落选,联合选择则把 {A, B} 作为一个组合评估其对任务的贡献。这在组合优化上接近带依赖约束的子集选择问题,实际实现中常借助角色标签(直接证据/补充背景/桥梁线索)来近似依赖结构。相比在检索结果上叠加 cross-encoder 重排序,联合选择改变的是候选集合的构造方式,因而能召回重排序阶段根本无法看到的互补记忆。
实验结果:稳定的F1提升与更少的上下文开销
论文在 LoCoMo 和 MemGallery 两个基准上,使用四个开源与闭源骨干模型进行了评测,结果显示相对代表性记忆系统取得了一致的改进,macro-F1 提升 2.23 到 3.14 个点。
在 LoCoMo 上,TrawMem 相对 SimpleMem 的 LLM-Judge 得分提升分别为:Qwen3.5-9B 上 4.07 个百分点,DeepSeek广告-V4-Flash 上 4.31 个百分点。同时,上下文 token 消耗分别减少约 12.8% 和 5.1%。
后一组数字值得单独拿出来看。记忆系统常见的困境是"效果靠堆上下文"——把更多记忆塞进窗口换取准确率,代价是推理成本和延迟上升。TrawMem 在提升效果的同时反而降低了 token 占用,说明按角色组织工作区确实比按相关性平铺更"省",选择本身变得更精准了。
提一嘴,现有摘要只覆盖了两个基准和四个骨干模型,尚未涉及更长的交互历史、多轮工具调用等更复杂的智能体场景,这类场景下的表现还有待观察。
对智能体记忆设计的启示
TrawMem 的价值不止于一组提升数字,更在于它提示了一个被长期忽略的设计维度:记忆的"角色"应当成为一等公民。
对做智能体产品的团队来说,这意味着记忆模块的评估指标需要调整。只看向 Recall@K 或语义相似度是不够的,还需要衡量记忆组合对任务完成的实际贡献。对研究者而言,"任务导向的角色自适应"这个抽象留出了不少可延展的空间——角色如何定义、由谁判定、能否跨任务迁移,都是开放问题。
记忆系统正在从"检索增强的附属组件"变成"任务求解的组织结构",TrawMem 是这条路径上一个清晰的路标。
相关推荐
导演大师配置Ollama本地模型全流程教程
B站教程完整演示导演大师配置Ollama本地模型的方法:从Ollama安装、模型路径设置、千问模型下载,到在导演大师Agent设置中接入本地模型,并用本地千问3.8跑通选题、大纲、剧本和分镜全流程。
导演大师接入Ollama本地模型:配置与全流程创作实战
B站教程详解导演大师如何接入Ollama本地模型:从安装Ollama、设置模型存储路径、命令行拉取千问模型,到在Agent设置中添加提供方,并用本地千问3.8跑通选题、大纲、剧本、分镜的短片创作全流程。
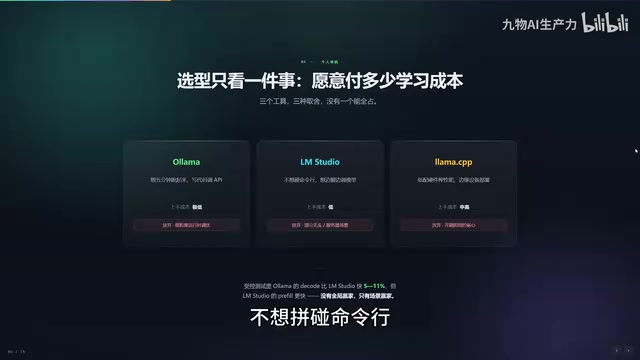
本地大模型部署三条路线:个人、企业、专用引擎怎么选
本地大模型部署分三条路线:个人端 Ollama、LM Studio、LLaMA.cpp 如何取舍;企业端 vLLM 与 SGLang 的内存复用模式差异;专用引擎 NIFL、Halogen、Strix 的适用边界。用三个问题帮你选对工具。